GSP246

總覽
BigQuery 是 Google 推出的全代管數據分析資料庫,具備免維運與低成本的優勢。您可以使用這項產品查詢數 TB 的資料,完全不必管理基礎架構,也無須特別安排資料庫管理員。
透過 BigQuery ML,資料分析師只需編寫少量程式碼,就能一手包辦機器學習模型的建立、訓練、評估和預測工作。
在本實驗室中,您將運用 BigQuery 公開資料集內,數百萬筆紐約市黃色計程車的載客資料,在 BigQuery 建立機器學習模型,讓模型根據輸入內容預測車資,最後再評估模型成效並產出預測結果。
課程內容
在本實驗室中,您將瞭解如何執行下列工作:
- 使用 BigQuery 尋找公開資料集
- 查詢及探索公開計程車資料集
- 建立訓練和評估資料集,供批次預測使用
- 在 BigQuery ML 建立預測 (線性迴歸) 模型
- 評估機器學習模型成效
設定和需求
瞭解以下事項後,再點選「Start Lab」按鈕
請詳閱以下操作說明。實驗室活動會計時,且中途無法暫停。點選「Start Lab」後就會開始計時,顯示可使用 Google Cloud 資源的時間。
您將在真正的雲端環境完成實作實驗室活動,而不是模擬或示範環境。為此,我們會提供新的暫時憑證,供您在實驗室活動期間登入及存取 Google Cloud。
為了順利完成這個實驗室,請先確認:
- 可以使用標準的網際網路瀏覽器 (Chrome 瀏覽器為佳)。
注意事項:請使用無痕模式 (建議選項) 或私密瀏覽視窗執行此實驗室,這可以防止個人帳戶和學員帳戶之間的衝突,避免個人帳戶產生額外費用。
- 是時候完成實驗室活動了!別忘了,活動一旦開始將無法暫停。
注意事項:務必使用實驗室專用的學員帳戶。如果使用其他 Google Cloud 帳戶,可能會產生額外費用。
如何開始實驗室及登入 Google Cloud 控制台
-
按一下「Start Lab」按鈕。如果實驗室會產生費用,請在開啟的對話方塊中選取付款方式。右側的「Lab setup and access」面板會顯示下列項目:
- 「Open Google Cloud console」按鈕
- 此實驗室所需的臨時憑證 (使用者名稱和密碼)
- 完成此實驗室所需的其他資訊 (如有)
請注意,實驗室計時器位於頁面頂端附近,會顯示剩餘時間。
-
按一下「Open Google Cloud console」。如果使用 Chrome 瀏覽器,也可以按一下滑鼠右鍵,選取「在無痕視窗中開啟連結」。
接著,實驗室會啟動相關資源,並開啟另一個分頁,顯示「登入」頁面。
提示:您可以在不同的視窗並排開啟分頁。
注意:頁面顯示「選擇帳戶」對話方塊時,請點選「使用其他帳戶」。
-
如有必要,請將下方的 Username 貼到「登入」對話方塊。
{{{user_0.username | "Username"}}}
您也可以在「Lab setup and access」面板找到「Username」。
-
點選「下一步」。
-
複製下方的 Password,並貼到「歡迎使用」對話方塊。
{{{user_0.password | "Password"}}}
您也可以在「Lab setup and access」面板找到「Password」。
-
點選「下一步」。
重要事項:請務必使用實驗室提供的憑證,而非自己的 Google Cloud 帳戶憑證。
注意:如果使用自己的 Google Cloud 帳戶來進行這個實驗室,可能會產生額外費用。
-
繼續點按後續頁面:
- 接受條款及細則。
- 由於這是臨時帳戶,請勿新增救援選項或雙重驗證機制。
- 請勿申請免費試用。
Google Cloud 控制台稍後會在這個分頁開啟。
注意:如要使用 Google Cloud 產品和服務,請按一下「導覽選單」,或在「搜尋」欄位輸入服務或產品名稱。
開啟 BigQuery 控制台
- 在 Google Cloud 控制台中,依序選取「導覽選單」>「BigQuery」。
接著,畫面中會顯示「歡迎使用 Cloud 控制台中的 BigQuery」訊息方塊,當中會列出快速入門導覽課程指南的連結和版本資訊。
- 點選「完成」。
BigQuery 控制台會隨即開啟。
工作 1:探索紐約市計程車資料
問題:2015 年黃色計程車每個月的載客次數是多少?
- 複製下列 SQL 程式碼,並貼入查詢編輯器:
#standardSQL
SELECT
TIMESTAMP_TRUNC(pickup_datetime,
MONTH) month,
COUNT(*) trips
FROM
`bigquery-public-data.new_york.tlc_yellow_trips_2015`
GROUP BY
1
ORDER BY
1
- 點選「執行」。
結果應大致如下:
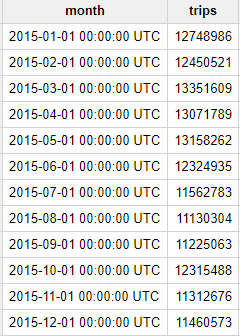
如表所示,2015 年紐約市計程車每個月的載客次數都超過 1,000 萬次,規模相當可觀!
檢查工作是否已完成
點選「Check my progress」,確認工作已完成。如果成功完成,就會看見評估分數。
計算 2015 年黃色計程車每個月的載客次數
問題:2015 年黃色計程車載客的平均時速是多少?
#standardSQL
SELECT
EXTRACT(HOUR
FROM
pickup_datetime) hour,
ROUND(AVG(trip_distance / TIMESTAMP_DIFF(dropoff_datetime,
pickup_datetime,
SECOND))*3600, 1) speed
FROM
`bigquery-public-data.new_york.tlc_yellow_trips_2015`
WHERE
trip_distance > 0
AND fare_amount/trip_distance BETWEEN 2
AND 10
AND dropoff_datetime > pickup_datetime
GROUP BY
1
ORDER BY
1
結果應大致如下:
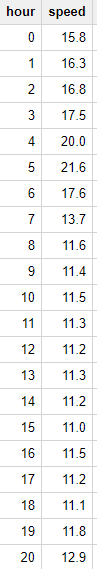
白天的平均時速約落在 11 到 12 英里,但到了清晨 5 點,平均時速幾乎翻倍,達到 21 英里。這點不難理解,因為清晨 5 點時的車流量通常較少。
檢查工作是否已完成
點選「Check my progress」,確認工作已完成。如果成功完成,就會看見評估分數。
計算 2015 年黃色計程車載客的平均時速
工作 2:確定目標
現在,您要在 BigQuery 建立機器學習模型,並使用歷來的載客資料集與相關數據,預測紐約市計程車的車資。出發前若能先預測車資,對乘客與計程車業者規劃行程都大有幫助。
工作 3:選取特徵並建立訓練資料集
「紐約市黃色計程車」資料集為市府提供的公開資料集,目前已在 BigQuery 開放使用。
建議您先瀏覽完整欄位清單,再預覽資料集,從中尋找實用特徵,協助機器學習模型釐清歷來載客資料與車資間的關聯。
您的團隊決定測試下列欄位,看看是否適合做為車資預測模型的輸入特徵:
- 將查詢換成下列內容:
#standardSQL
WITH params AS (
SELECT
1 AS TRAIN,
2 AS EVAL
),
daynames AS
(SELECT ['Sun', 'Mon', 'Tues', 'Wed', 'Thurs', 'Fri', 'Sat'] AS daysofweek),
taxitrips AS (
SELECT
(tolls_amount + fare_amount) AS total_fare,
daysofweek[ORDINAL(EXTRACT(DAYOFWEEK FROM pickup_datetime))] AS dayofweek,
EXTRACT(HOUR FROM pickup_datetime) AS hourofday,
pickup_longitude AS pickuplon,
pickup_latitude AS pickuplat,
dropoff_longitude AS dropofflon,
dropoff_latitude AS dropofflat,
passenger_count AS passengers
FROM
`nyc-tlc.yellow.trips`, daynames, params
WHERE
trip_distance > 0 AND fare_amount > 0
AND MOD(ABS(FARM_FINGERPRINT(CAST(pickup_datetime AS STRING))),1000) = params.TRAIN
)
SELECT *
FROM taxitrips
上方的查詢有幾點需要注意:
- 查詢的主要邏輯寫在最下面 (
SELECT * from taxitrips)。
-
taxitrips 會擷取大部分的 NYC 資料集內容,SELECT 則定義了訓練特徵與標籤。
-
WHERE 的作用是排除您不想用於訓練的資料。
-
WHERE 也納入取樣子句,表示只會擷取千分之一的資料。
- 定義
TRAIN 變數,即可快速建構獨立的 EVAL 資料集。
- 明白這個查詢的用途後,請點選「執行」。
畫面上會顯示類似下方的結果:
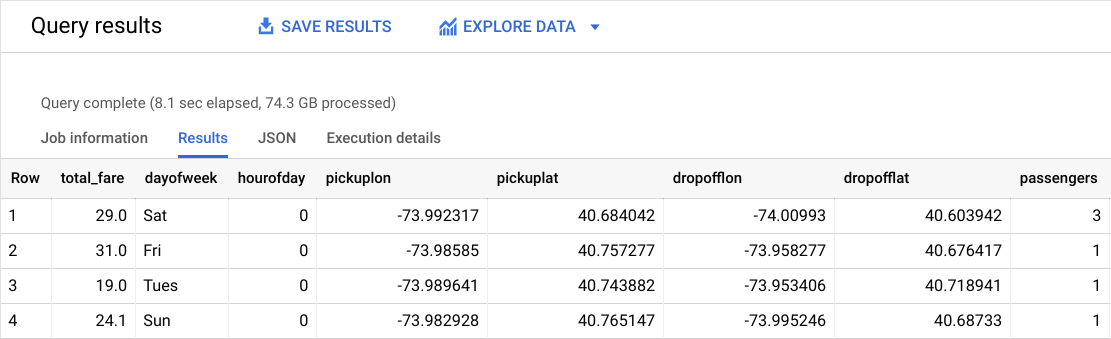
哪一個才是標籤 (正確答案)?
total_fare 為本模型的標籤,也就是要預測的目標。這個欄位是由 tolls_amount 和 fare_amount 計算而來。由於小費金額取決於乘客意願,不適合納入模型,可以直接排除。
檢查工作是否已完成
點選「Check my progress」,確認工作已完成。如果成功完成,就會看見評估分數。
測試各欄位是否適合做為車資預測模型的輸入特徵
工作 4:建立 BigQuery 資料集來儲存模型
在本節中,您將建立新的 BigQuery 資料集,用來儲存機器學習模型。
-
在左側的「Explorer」面板,依序點選專案 ID 旁的「查看動作」圖示 >「建立資料集」。
-
在「建立資料集」對話方塊,輸入下列資訊:
- 在「資料集 ID」部分,輸入 taxi。
- 在「資料位置」部分,選取「US (多個美國區域)」。
- 其他設定均保留預設值。
- 接著,點選「建立資料集」。
檢查工作是否已完成
點選「Check my progress」,確認工作已完成。如果成功完成,就會看見評估分數。
建立 BigQuery 資料集來儲存模型
工作 5:選擇 BigQuery ML 模型類型並指定選項
選定初步特徵後,現在可以開始在 BigQuery 建立第一個機器學習模型。
目前有幾種模型可供選擇:
-
預測模型:使用線性迴歸 (linear_reg) 預測數值,例如下個月的銷售額。
-
二元/多類別分類模型:使用邏輯迴歸 (logistic_reg) 判斷類別,例如郵件是否為垃圾郵件。
-
k-means 分群模型:適合使用非監督式學習方法探索資料 (kmeans)。
注意:機器學習領域還有許多其他模型類型 (例如類神經網路或決策樹),通常可透過 TensorFlow 等程式庫使用。目前 BigQuery ML 只支援上述三種類型,詳情請參閱 BigQuery ML 藍圖。
- 輸入下列查詢,建立模型並指定模型選項:
CREATE or REPLACE MODEL taxi.taxifare_model
OPTIONS
(model_type='linear_reg', labels=['total_fare']) AS
WITH params AS (
SELECT
1 AS TRAIN,
2 AS EVAL
),
daynames AS
(SELECT ['Sun', 'Mon', 'Tues', 'Wed', 'Thurs', 'Fri', 'Sat'] AS daysofweek),
taxitrips AS (
SELECT
(tolls_amount + fare_amount) AS total_fare,
daysofweek[ORDINAL(EXTRACT(DAYOFWEEK FROM pickup_datetime))] AS dayofweek,
EXTRACT(HOUR FROM pickup_datetime) AS hourofday,
pickup_longitude AS pickuplon,
pickup_latitude AS pickuplat,
dropoff_longitude AS dropofflon,
dropoff_latitude AS dropofflat,
passenger_count AS passengers
FROM
`nyc-tlc.yellow.trips`, daynames, params
WHERE
trip_distance > 0 AND fare_amount > 0
AND MOD(ABS(FARM_FINGERPRINT(CAST(pickup_datetime AS STRING))),1000) = params.TRAIN
)
SELECT *
FROM taxitrips
-
點選「執行」,開始訓練模型。
-
等待模型訓練完成,大約需要 5 至 10 分鐘。
訓練完成後,畫面會顯示「This statement will create a new model named qwiklabs-gcp-03-xxxxxxxx:taxi.taxifare_model.」訊息,表示訓練成功。
- 查看 taxi 資料集,確認當中是否已出現「taxifare_model」。
接下來,您將使用模型從未見過的新資料評估成效。
檢查工作是否已完成
點選「Check my progress」,確認工作已完成。如果成功完成,就會看見評估分數。
建立計程車資模型
工作 6:評估分類模型的成效
選取評估標準
使用線性迴歸模型時,我們會建議搭配均方根誤差 (RMSE) 等損失指標。您需要持續訓練並改良模型,直到 RMSE 降至最低為止。
在 BigQuery ML 評估訓練好的機器學習模型時,可以查詢 mean_squared_error 欄位,並套用 SQRT() 函式來計算 RMSE。
既然模型已訓練完成,現在就能執行下列 ML.EVALUATE 查詢,評估模型成效。
- 複製下列指令並貼入查詢編輯器,然後點選「執行」:
#standardSQL
SELECT
SQRT(mean_squared_error) AS rmse
FROM
ML.EVALUATE(MODEL taxi.taxifare_model,
(
WITH params AS (
SELECT
1 AS TRAIN,
2 AS EVAL
),
daynames AS
(SELECT ['Sun', 'Mon', 'Tues', 'Wed', 'Thurs', 'Fri', 'Sat'] AS daysofweek),
taxitrips AS (
SELECT
(tolls_amount + fare_amount) AS total_fare,
daysofweek[ORDINAL(EXTRACT(DAYOFWEEK FROM pickup_datetime))] AS dayofweek,
EXTRACT(HOUR FROM pickup_datetime) AS hourofday,
pickup_longitude AS pickuplon,
pickup_latitude AS pickuplat,
dropoff_longitude AS dropofflon,
dropoff_latitude AS dropofflat,
passenger_count AS passengers
FROM
`nyc-tlc.yellow.trips`, daynames, params
WHERE
trip_distance > 0 AND fare_amount > 0
AND MOD(ABS(FARM_FINGERPRINT(CAST(pickup_datetime AS STRING))),1000) = params.EVAL
)
SELECT *
FROM taxitrips
))
接著,您將使用 params.EVAL 篩選出另一組計程車載客資料,並據此評估模型。
- 等待模型執行完成,再查看結果 (RMSE 值可能會有些微差異)。
|
Row
|
rmse
|
|
1
|
9.477056435999074
|
評估完模型後,得出的 RMSE 為 9.47。RMSE 是均方誤差的平方根,單位與 total_fare 相同,因此 9.47 的誤差值相當於 ±$9.47 美元。
這項損失指標是否達到讓模型正式上線的標準,完全取決於您在訓練開始前設定的評估基準。建立基準是指為模型的成效與準確度,訂出一個可接受的最低門檻。
檢查工作是否已完成
點選「Check my progress」,確認工作已完成。如果成功完成,就會看見評估分數。
評估分類模型的成效
工作 7:預測計程車資
接著,請編寫查詢來使用新模型預測。
#standardSQL
SELECT
*
FROM
ml.PREDICT(MODEL `taxi.taxifare_model`,
(
WITH params AS (
SELECT
1 AS TRAIN,
2 AS EVAL
),
daynames AS
(SELECT ['Sun', 'Mon', 'Tues', 'Wed', 'Thurs', 'Fri', 'Sat'] AS daysofweek),
taxitrips AS (
SELECT
(tolls_amount + fare_amount) AS total_fare,
daysofweek[ORDINAL(EXTRACT(DAYOFWEEK FROM pickup_datetime))] AS dayofweek,
EXTRACT(HOUR FROM pickup_datetime) AS hourofday,
pickup_longitude AS pickuplon,
pickup_latitude AS pickuplat,
dropoff_longitude AS dropofflon,
dropoff_latitude AS dropofflat,
passenger_count AS passengers
FROM
`nyc-tlc.yellow.trips`, daynames, params
WHERE
trip_distance > 0 AND fare_amount > 0
AND MOD(ABS(FARM_FINGERPRINT(CAST(pickup_datetime AS STRING))),1000) = params.EVAL
)
SELECT *
FROM taxitrips
));
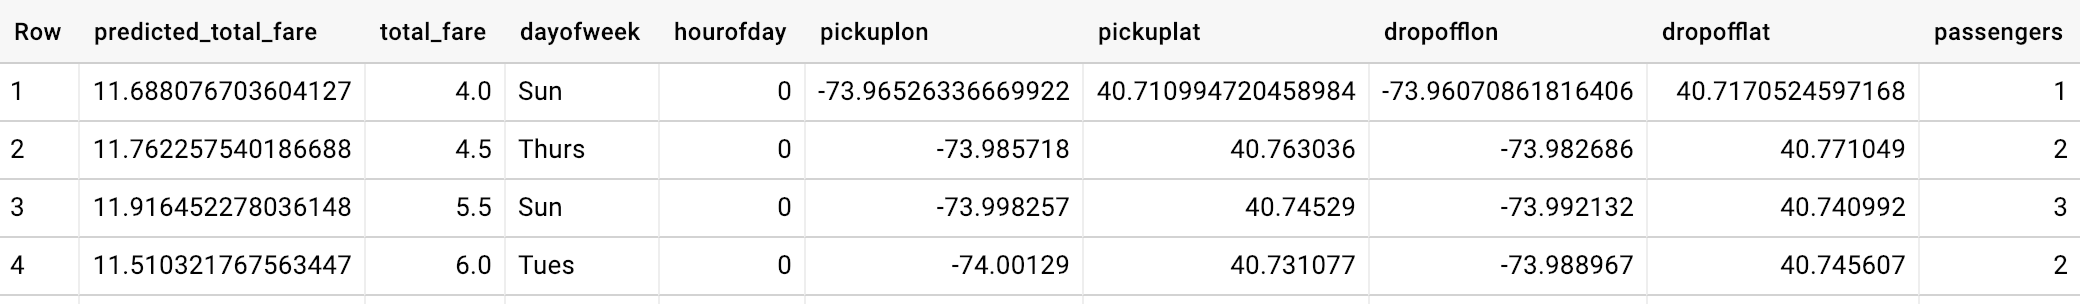
現在,模型預測的計程車資會與實際車資及其他特徵並列顯示,方便您比對。畫面上會顯示類似下方的結果:
檢查工作是否已完成
點選「Check my progress」,確認工作已完成。如果成功完成,就會看見評估分數。
預測計程車資
工作 8:運用特徵工程改良模型
建構機器學習模型需要經過不斷反覆調整。評估完初始模型的成效後,我們通常會回頭刪減特徵與資料列,看看是否能讓模型的表現更好。
篩選訓練資料集
接下來,您要查看計程車資的常用統計資料。
- 複製下列指令並貼入查詢編輯器,然後點選「執行」:
SELECT
COUNT(fare_amount) AS num_fares,
MIN(fare_amount) AS low_fare,
MAX(fare_amount) AS high_fare,
AVG(fare_amount) AS avg_fare,
STDDEV(fare_amount) AS stddev
FROM
`nyc-tlc.yellow.trips`
# 1,108,779,463 fares
輸出內容應大致如下:
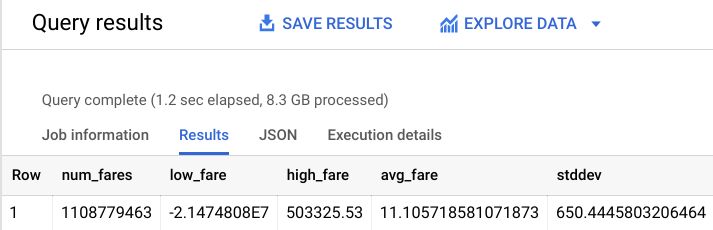
這裡可以看到,資料集中有一些奇怪的離群值,例如負數車資或超過 $5 萬美元的金額。因此,我們必須運用專業知識處理資料,避免這些異常離群值誤導模型。
請限制資料範圍,只顯示介於 $6 美元至 $200 美元間的車資。
- 複製下列指令並貼入查詢編輯器,然後點選「執行」:
SELECT
COUNT(fare_amount) AS num_fares,
MIN(fare_amount) AS low_fare,
MAX(fare_amount) AS high_fare,
AVG(fare_amount) AS avg_fare,
STDDEV(fare_amount) AS stddev
FROM
`nyc-tlc.yellow.trips`
WHERE trip_distance > 0 AND fare_amount BETWEEN 6 and 200
# 843,834,902 fares
輸出內容應大致如下:
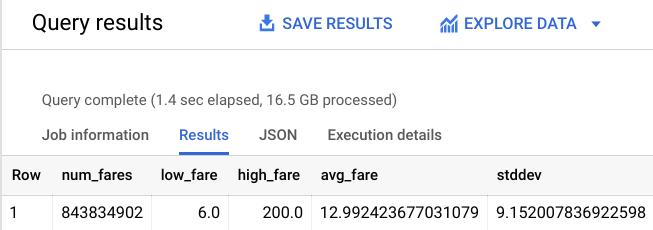
這樣看起來好一點了。現在不妨順便限制行駛距離,讓模型聚焦於紐約市的載客資料。
- 複製下列指令並貼入查詢編輯器,然後點選「執行」:
SELECT
COUNT(fare_amount) AS num_fares,
MIN(fare_amount) AS low_fare,
MAX(fare_amount) AS high_fare,
AVG(fare_amount) AS avg_fare,
STDDEV(fare_amount) AS stddev
FROM
`nyc-tlc.yellow.trips`
WHERE trip_distance > 0 AND fare_amount BETWEEN 6 and 200
AND pickup_longitude > -75 #limiting of the distance the taxis travel out
AND pickup_longitude < -73
AND dropoff_longitude > -75
AND dropoff_longitude < -73
AND pickup_latitude > 40
AND pickup_latitude < 42
AND dropoff_latitude > 40
AND dropoff_latitude < 42
# 827,365,869 fares
輸出內容應大致如下:
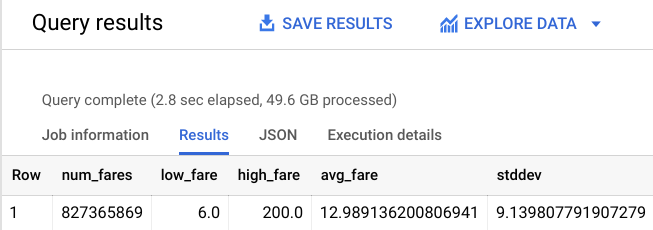
即使經過篩選,目前仍有超過 8 億筆載客資料可供新模型學習。接下來,請根據這些新的限制重新訓練模型,觀察模型表現如何。
重新訓練模型
現在要建立新的線性迴歸模型 taxi.taxifare_model_2,並重新訓練模型來預測總車資。您會發現,這次的指令也加入了一些計算得出的特徵,例如上下車地點間的歐幾里得距離 (直線距離)。
CREATE OR REPLACE MODEL taxi.taxifare_model_2
OPTIONS
(model_type='linear_reg', labels=['total_fare']) AS
WITH params AS (
SELECT
1 AS TRAIN,
2 AS EVAL
),
daynames AS
(SELECT ['Sun', 'Mon', 'Tues', 'Wed', 'Thurs', 'Fri', 'Sat'] AS daysofweek),
taxitrips AS (
SELECT
(tolls_amount + fare_amount) AS total_fare,
daysofweek[ORDINAL(EXTRACT(DAYOFWEEK FROM pickup_datetime))] AS dayofweek,
EXTRACT(HOUR FROM pickup_datetime) AS hourofday,
SQRT(POW((pickup_longitude - dropoff_longitude),2) + POW(( pickup_latitude - dropoff_latitude), 2)) as dist, #Euclidean distance between pickup and drop off
SQRT(POW((pickup_longitude - dropoff_longitude),2)) as longitude, #Euclidean distance between pickup and drop off in longitude
SQRT(POW((pickup_latitude - dropoff_latitude), 2)) as latitude, #Euclidean distance between pickup and drop off in latitude
passenger_count AS passengers
FROM
`nyc-tlc.yellow.trips`, daynames, params
WHERE trip_distance > 0 AND fare_amount BETWEEN 6 and 200
AND pickup_longitude > -75 #limiting of the distance the taxis travel out
AND pickup_longitude < -73
AND dropoff_longitude > -75
AND dropoff_longitude < -73
AND pickup_latitude > 40
AND pickup_latitude < 42
AND dropoff_latitude > 40
AND dropoff_latitude < 42
AND MOD(ABS(FARM_FINGERPRINT(CAST(pickup_datetime AS STRING))),1000) = params.TRAIN
)
SELECT *
FROM taxitrips
模型可能需要幾分鐘才能重新訓練完成。在控制台看到下列訊息後,即可繼續下一步:
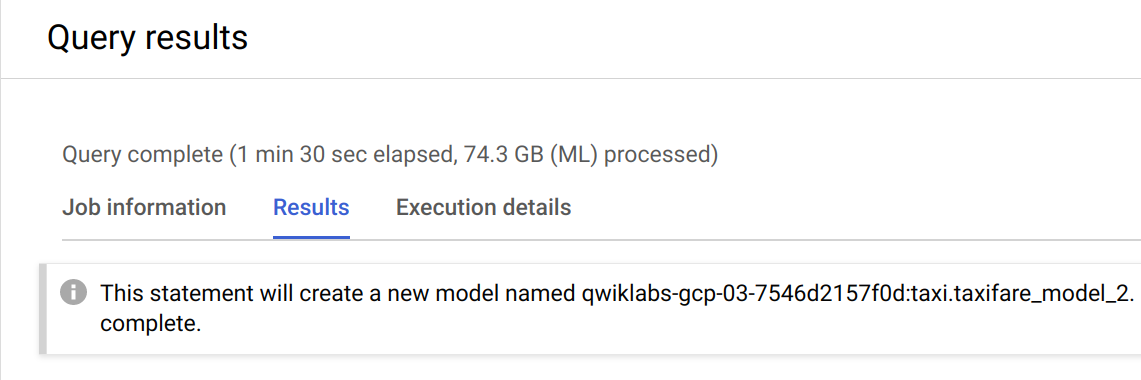
評估新模型的成效
線性迴歸模型調整完成後,請使用資料集評估模型成效。
SELECT
SQRT(mean_squared_error) AS rmse
FROM
ML.EVALUATE(MODEL taxi.taxifare_model_2,
(
WITH params AS (
SELECT
1 AS TRAIN,
2 AS EVAL
),
daynames AS
(SELECT ['Sun', 'Mon', 'Tues', 'Wed', 'Thurs', 'Fri', 'Sat'] AS daysofweek),
taxitrips AS (
SELECT
(tolls_amount + fare_amount) AS total_fare,
daysofweek[ORDINAL(EXTRACT(DAYOFWEEK FROM pickup_datetime))] AS dayofweek,
EXTRACT(HOUR FROM pickup_datetime) AS hourofday,
SQRT(POW((pickup_longitude - dropoff_longitude),2) + POW(( pickup_latitude - dropoff_latitude), 2)) as dist, #Euclidean distance between pickup and drop off
SQRT(POW((pickup_longitude - dropoff_longitude),2)) as longitude, #Euclidean distance between pickup and drop off in longitude
SQRT(POW((pickup_latitude - dropoff_latitude), 2)) as latitude, #Euclidean distance between pickup and drop off in latitude
passenger_count AS passengers
FROM
`nyc-tlc.yellow.trips`, daynames, params
WHERE trip_distance > 0 AND fare_amount BETWEEN 6 and 200
AND pickup_longitude > -75 #limiting of the distance the taxis travel out
AND pickup_longitude < -73
AND dropoff_longitude > -75
AND dropoff_longitude < -73
AND pickup_latitude > 40
AND pickup_latitude < 42
AND dropoff_latitude > 40
AND dropoff_latitude < 42
AND MOD(ABS(FARM_FINGERPRINT(CAST(pickup_datetime AS STRING))),1000) = params.EVAL
)
SELECT *
FROM taxitrips
))
輸出內容應大致如下:
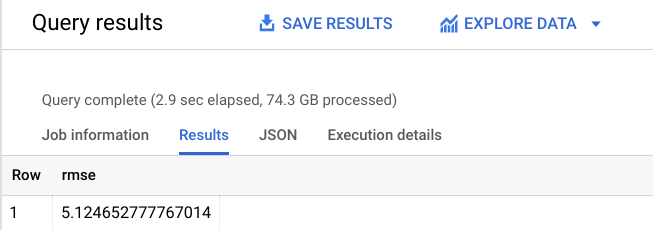
從結果來看,RMSE 下降至 ±$5.12 美元,比起第一個模型的 ±$9.47 美元,表現有顯著進步。
RMSE 代表預測誤差的標準差,由此可知,重新訓練後的線性迴歸模型確實大幅提升模型準確度。
工作 9:隨堂測驗
下列選擇題可以加深您對本實驗室概念的理解,請盡力作答。
工作 10:探索其他資料集
如要嘗試用其他資料集建模,例如預測芝加哥的計程車資,可以使用 bigquery-public-data 專案。
-
前往「Explorer」面板,依序點選「+ 新增資料」>「依據名稱為專案加上星號」,然後輸入專案名稱 bigquery-public-data,開啟該資料集。
-
點選「加上星號」。
「Explorer」部分會隨即列出 bigquery-public-data 專案。
恭喜!
您已成功在 BigQuery 建構機器學習模型,可用來預測紐約市的計程車資。
後續行動/瞭解詳情
- 參閱 BigQuery ML 說明文件,進一步瞭解 BigQuery ML。
- 參閱說明文件的「將 BigQuery ML 模型註冊至 Model Registry」一節,進一步瞭解如何在 Agent Platform 管理 BigQuery ML 模型。
Google Cloud 教育訓練與認證
協助您瞭解如何充分運用 Google Cloud 的技術。我們的課程會介紹專業技能和最佳做法,讓您可以快速掌握要領並持續進修。我們提供從基本到進階等級的訓練課程,並有隨選、線上和虛擬課程等選項,方便您抽空參加。認證可協助您驗證及證明自己在 Google Cloud 技術方面的技能和專業知識。
使用手冊上次更新日期:2026 年 5 月 18 日
實驗室上次測試日期:2026 年 1 月 7 日
Copyright 2026 Google LLC 保留所有權利。Google 和 Google 標誌是 Google LLC 的商標,其他公司和產品名稱則有可能是其關聯公司的商標。







