

Before you begin
- Labs create a Google Cloud project and resources for a fixed time
- Labs have a time limit and no pause feature. If you end the lab, you'll have to restart from the beginning.
- On the top left of your screen, click Start lab to begin

Load the data
/ 25
Add Cloud Data Fusion API Service Agent role to service account
/ 25
Deploy and execute batch pipeline
/ 25
View the results
/ 25
Load the data
/ 25
Add Cloud Data Fusion API Service Agent role to service account
/ 25
Deploy and execute batch pipeline
/ 25
View the results
/ 25

ETL 是指擷取 (Extract)、轉換 (Transform) 和載入 (Load),這個概念後來也衍生出多種不同的變化,包括 EL、ELT 和 ELTL。
本實驗室將說明如何使用 Cloud Data Fusion 的 Pipeline Studio 建構 ETL 管道。Pipeline Studio 提供多種建構模塊與內建外掛程式,讓您能逐一設定節點,打造出批次管道。您也會使用 Wrangler 外掛程式來建立轉換,並套用至經由管道傳輸的資料。
就 ETL 應用程式而言,最常見的資料來源通常是逗號分隔值 (CSV) 格式的文字檔,因為許多資料庫系統都是用這種方式匯出及匯入資料。本實驗室將以 CSV 檔案為例,但同樣的技巧也適用於資料庫來源,以及任何您現有的資料來源。
最後輸出內容會寫入 BigQuery 資料表,您要透過標準 SQL 來分析這個目標資料集的資料。
本實驗室的學習內容包括:
每個實驗室都會提供新的 Google Cloud 專案和一組資源,讓您在時限內免費使用。
請以無痕視窗登入 Google Skills。
請記下實驗室時間限制 (例如 02:00:00),務必在時限內完成作業。
研究室不提供暫停功能。如有需要,您可以重新開始,但原先的進度恕無法保留。
準備就緒之後,請點選「Start Lab」。
請記下研究室憑證 (使用者名稱和密碼),登入 Google Cloud 控制台時會用到。
點選「Open Google console」。
點選「Use another account」,然後複製這個研究室的憑證,並貼到提示中。
如果使用其他憑證,系統會顯示錯誤或向您收取費用。
接受條款,然後略過資源復原頁面。
點選「Start Lab」按鈕。如果實驗室會產生費用,畫面上會出現選擇付款方式的對話方塊。左側的「Lab Details」窗格會顯示下列項目:
點選「Open Google Cloud console」;如果使用 Chrome 瀏覽器,也能按一下滑鼠右鍵,選取「在無痕視窗中開啟連結」。
接著,實驗室會啟動相關資源,並開啟另一個分頁,顯示「登入」頁面。
提示:您可以在不同的視窗中並排開啟分頁。
如有必要,請將下方的 Username 貼到「登入」對話方塊。
您也可以在「Lab Details」窗格找到 Username。
點選「下一步」。
複製下方的 Password,並貼到「歡迎使用」對話方塊。
您也可以在「Lab Details」窗格找到 Password。
點選「下一步」。
按過後續的所有頁面:
Google Cloud 控制台稍後會在這個分頁開啟。

Cloud Shell 是含有多項開發工具的虛擬機器,提供永久的 5 GB 主目錄,並在 Google Cloud 中運作。Cloud Shell 可讓您透過指令列存取 Google Cloud 資源。gcloud 是 Google Cloud 的指令列工具,已預先安裝於 Cloud Shell,並支援 Tab 鍵完成功能。
在控制台的右上方,點按「啟用 Cloud Shell」按鈕 
點按「繼續」。
請稍候片刻,等待系統完成佈建作業並連線至環境。連線建立後,即代表您已通過驗證,且專案已設為「PROJECT_ID」。
輸出內容
輸出內容範例
輸出內容
輸出內容範例
開始使用 Google Cloud 前,請務必確保專案在 Identity and Access Management (IAM) 中具備正確的權限。
前往 Google Cloud 控制台的「導覽選單」
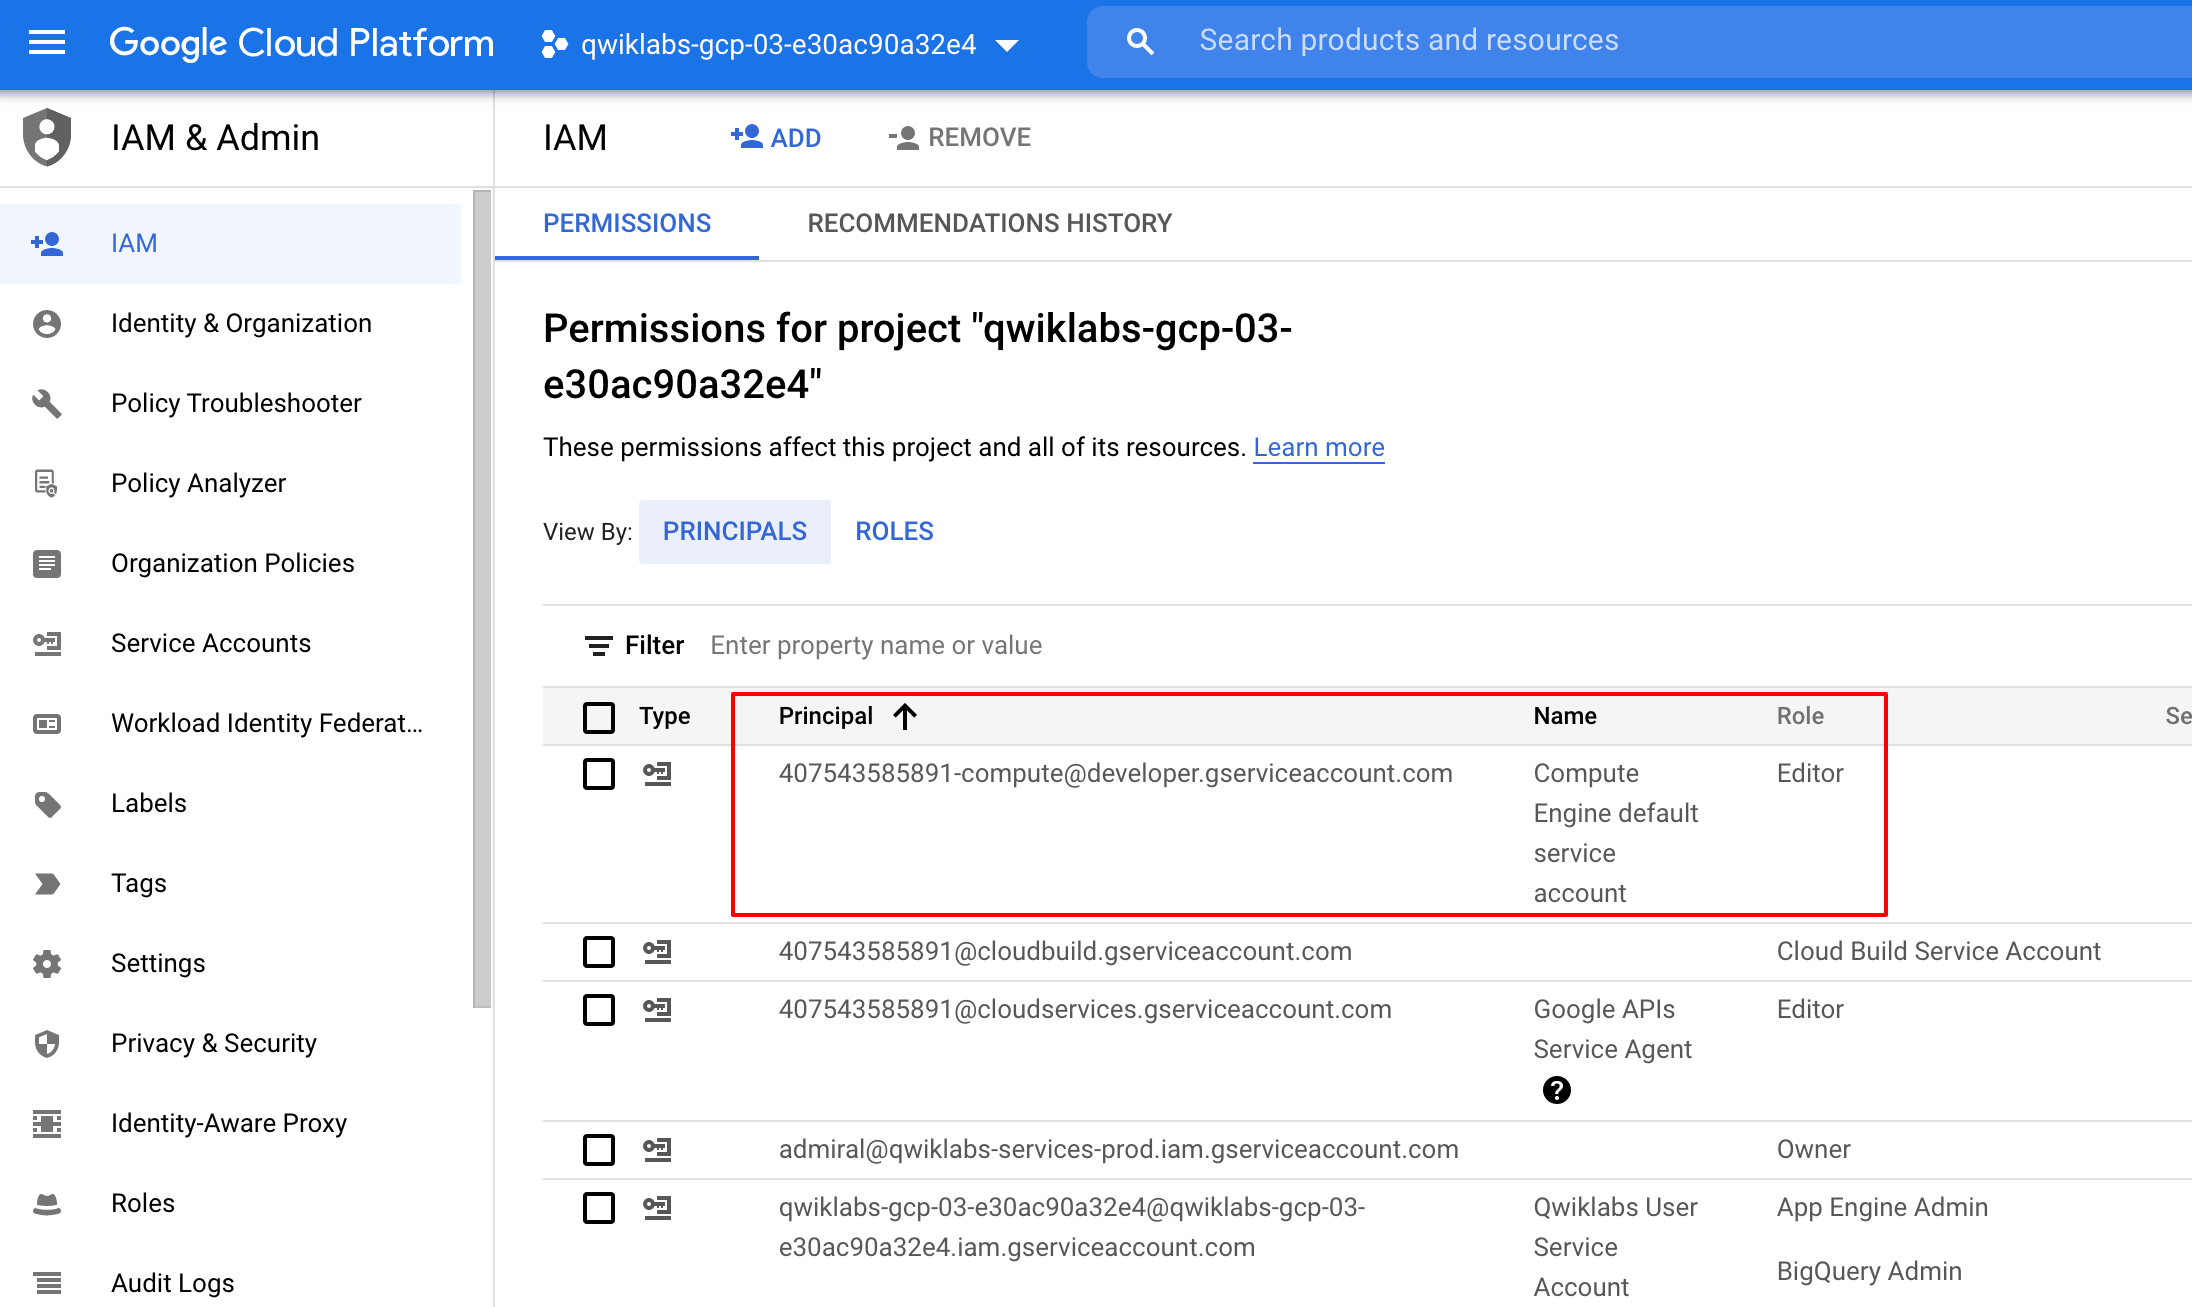
確認具有預設的運算服務帳戶 {project-number}-compute@developer.gserviceaccount.com,且已指派 editor 角色。帳戶前置字串為專案編號,如需查看,請前往「導覽選單」>「Cloud 總覽」。
如果帳戶未顯示在 IAM 中,或沒有 editor 角色,請依照下列步驟指派必要角色。
前往 Google Cloud 控制台,依序點選「導覽選單」>「Cloud 總覽」。
從「專案資訊」資訊卡複製「專案編號」。
從「導覽選單」依序點選「IAM 與管理」>「身分與存取權管理」。
點選「身分與存取權管理」頁面頂端的「新增」。
在「新增主體」輸入:
將 {project-number} 換成您的專案編號。
從「請選擇角色」選單依序選取「基本」或「專案」>「編輯者」。
點選「儲存」。
在這項工作中,您將於專案建立 Cloud Storage bucket,並暫存一個 CSV 檔案。Cloud Data Fusion 隨後會從這個儲存空間 bucket 讀取資料。
新建立的 bucket 名稱即為專案 ID。
點選「Check my progress」,確認目標已達成。
在這項工作中,您要將必要的 IAM 角色,授予與 Cloud Data Fusion 執行個體相關聯的服務帳戶。
前往 Google Cloud 控制台,依序點選「導覽選單」>「IAM 與管理」>「身分與存取權管理」。
找出預設 Compute Engine 服務帳戶 {project-number}-compute@developer.gserviceaccount.com,然後將該服務帳戶複製到剪貼簿。
在「IAM 權限」頁面,點選「+ 授予存取權」。
在「新增主體」欄位貼上服務帳戶。
在「選取角色」部分,輸入 Cloud Data Fusion API 服務代理,然後選取該角色。
點選「+ 新增其他角色」。
在「選取角色」部分,輸入 Dataproc 管理員,然後選取該角色。
點選「儲存」。
點選「Check my progress」,確認目標已達成。
前往控制台,依序點選「導覽選單」圖示 >「IAM 與管理」>「身分與存取權管理」。
勾選「包含 Google 提供的角色授予項目」核取方塊。
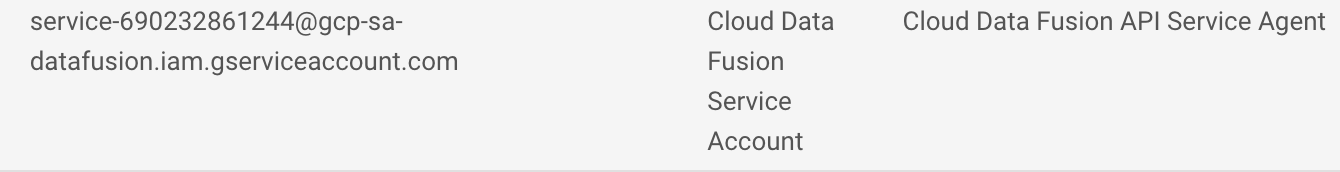
向下捲動清單,找到 Google 代管的 Cloud Data Fusion 服務帳戶 (格式為 service-{project-number}@gcp-sa-datafusion.iam.gserviceaccount.com),然後將該帳戶的名稱複製到剪貼簿。
接著,依序點選「IAM 與管理」>「服務帳戶」。
點選預設的 Compute Engine 帳戶 (格式為 {project-number}-compute@developer.gserviceaccount.com),然後選取頂端導覽面板中的「具備存取權的主體」分頁標籤。
點選「授予存取權」按鈕。
在「新增主體」欄位,貼上先前複製的服務帳戶名稱。
在「角色」下拉式選單,選取「服務帳戶使用者」。
點選「儲存」。
在這項工作中,您將使用 Cloud Data Fusion 的 Wrangler 元件,準備及清理原始資料。透過這樣反覆進行的過程,您可以即時查看視覺化的轉換結果。
前往 Google Cloud 控制台,依序點選「導覽選單」>「Data Fusion」>「執行個體」。
找到所需執行個體後,點選「查看執行個體」。出現提示訊息時,請使用實驗室憑證登入。如果系統詢問是否觀看導覽,請點選「No, Thanks」。
在 Cloud Data Fusion UI,依序點選「導覽選單」圖示 >「Wrangler」。
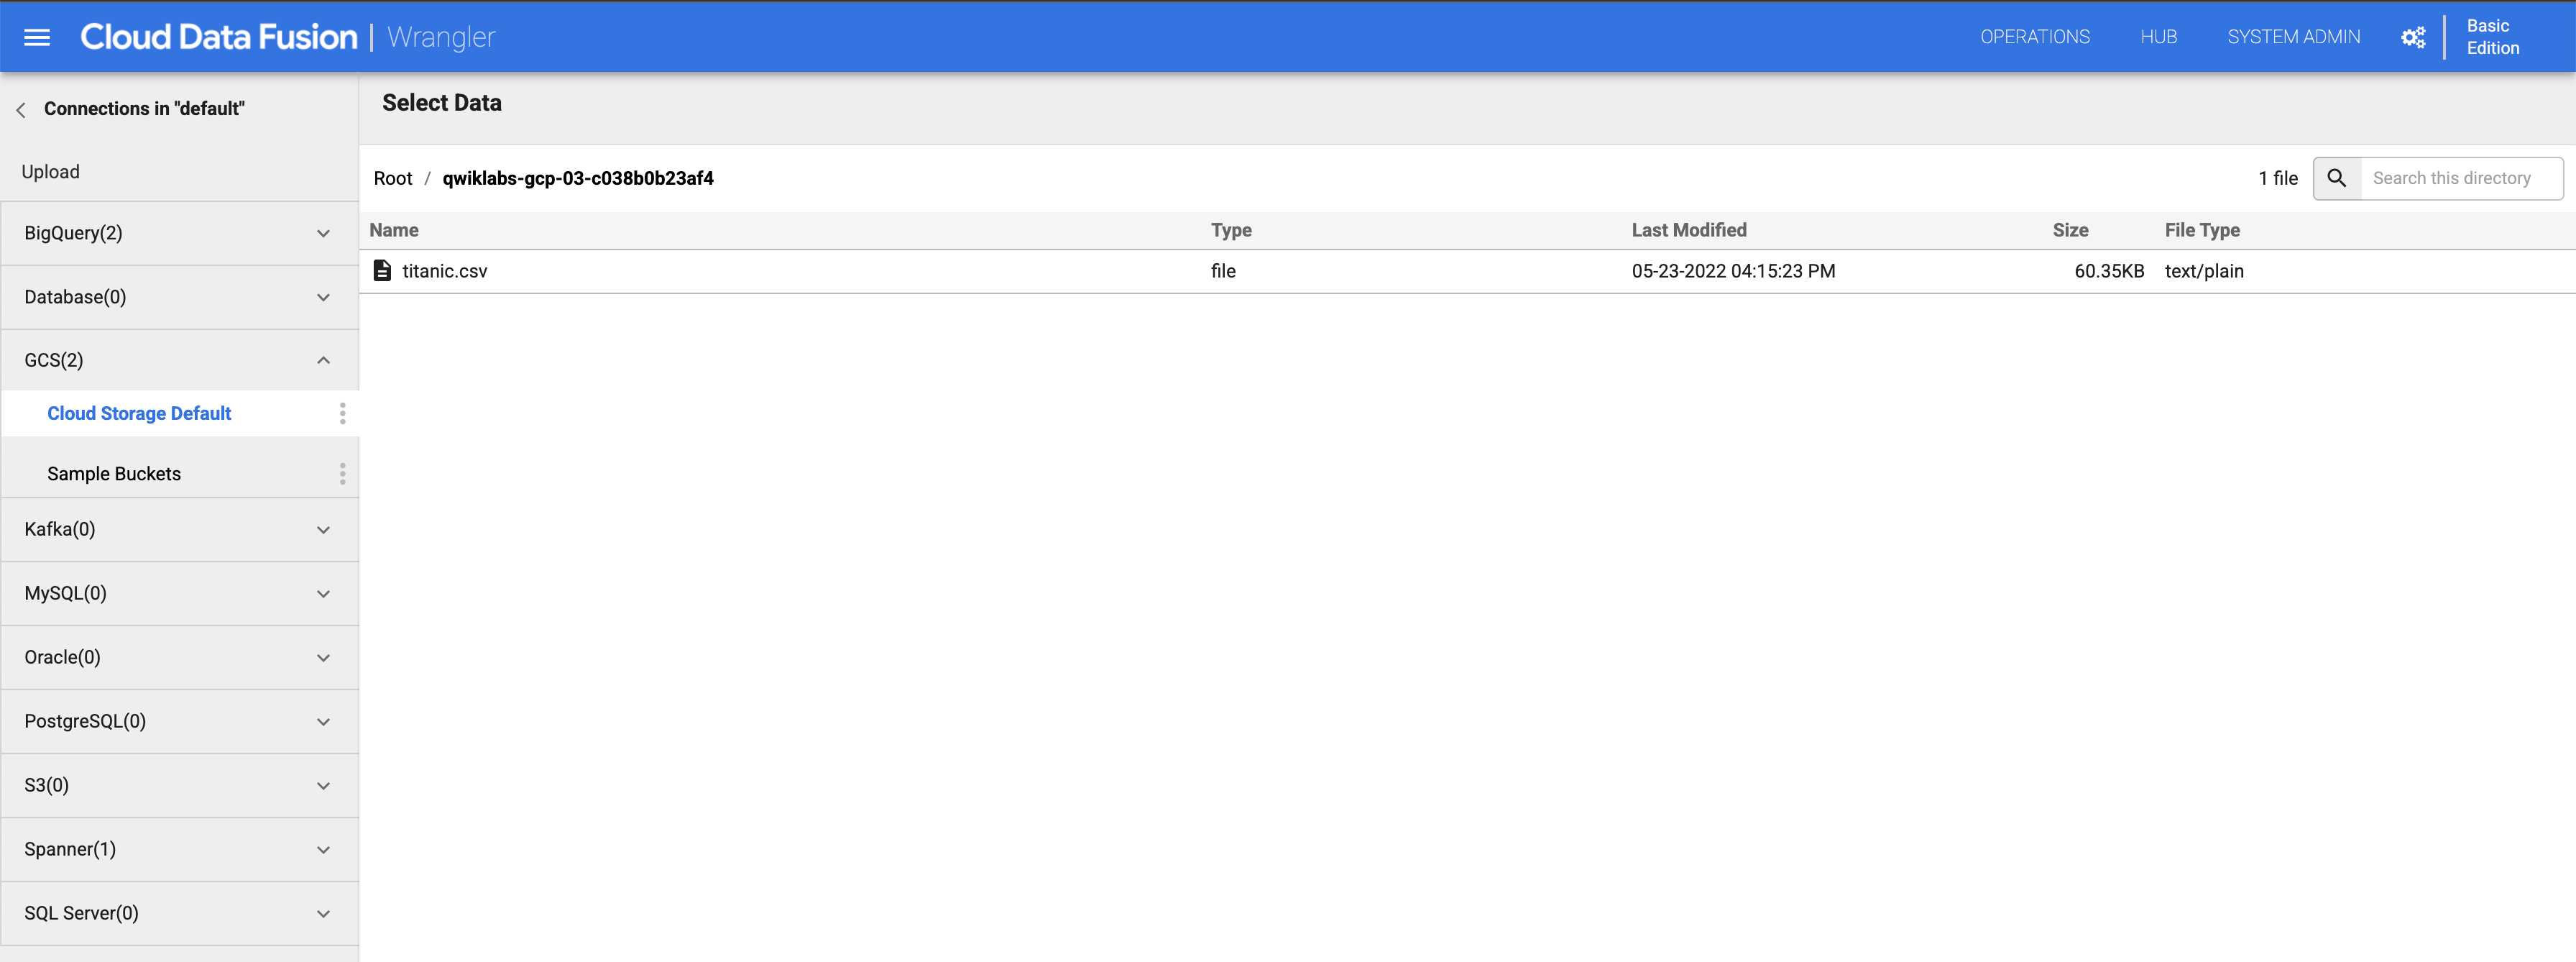
在左側面板點選「(GCS) Google Cloud Storage」,然後選取「Cloud Storage Default」。
點選與專案 ID 對應的 bucket。
點選「titanic.csv」。
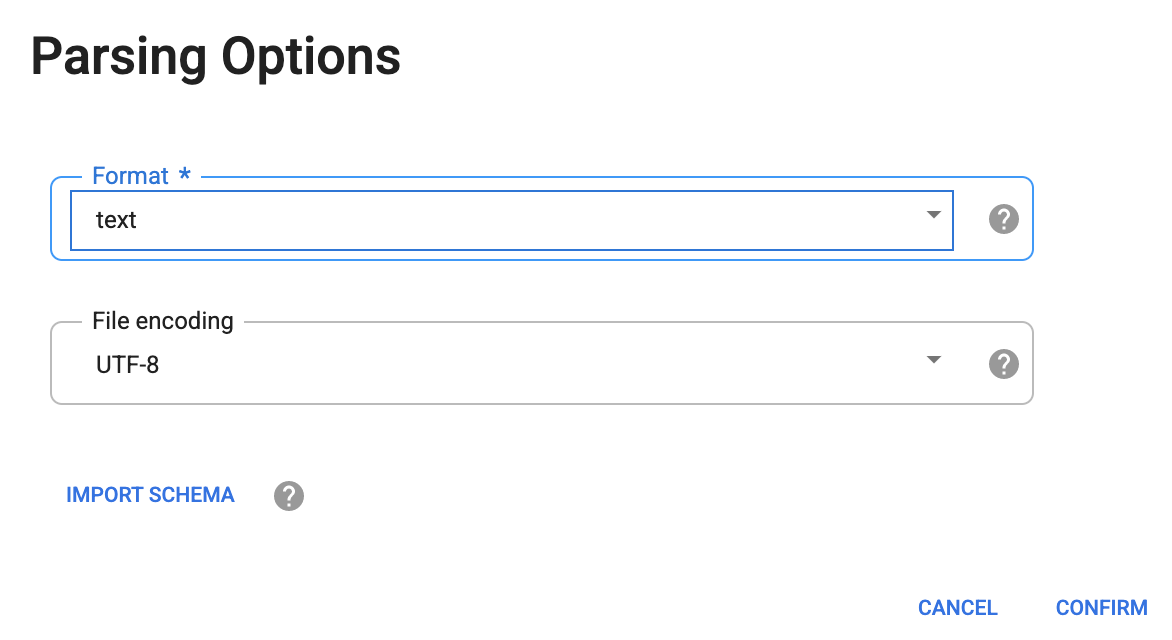
在「Parsing Options」對話方塊的「Format」部分選取「text」,然後點選「Confirm」。
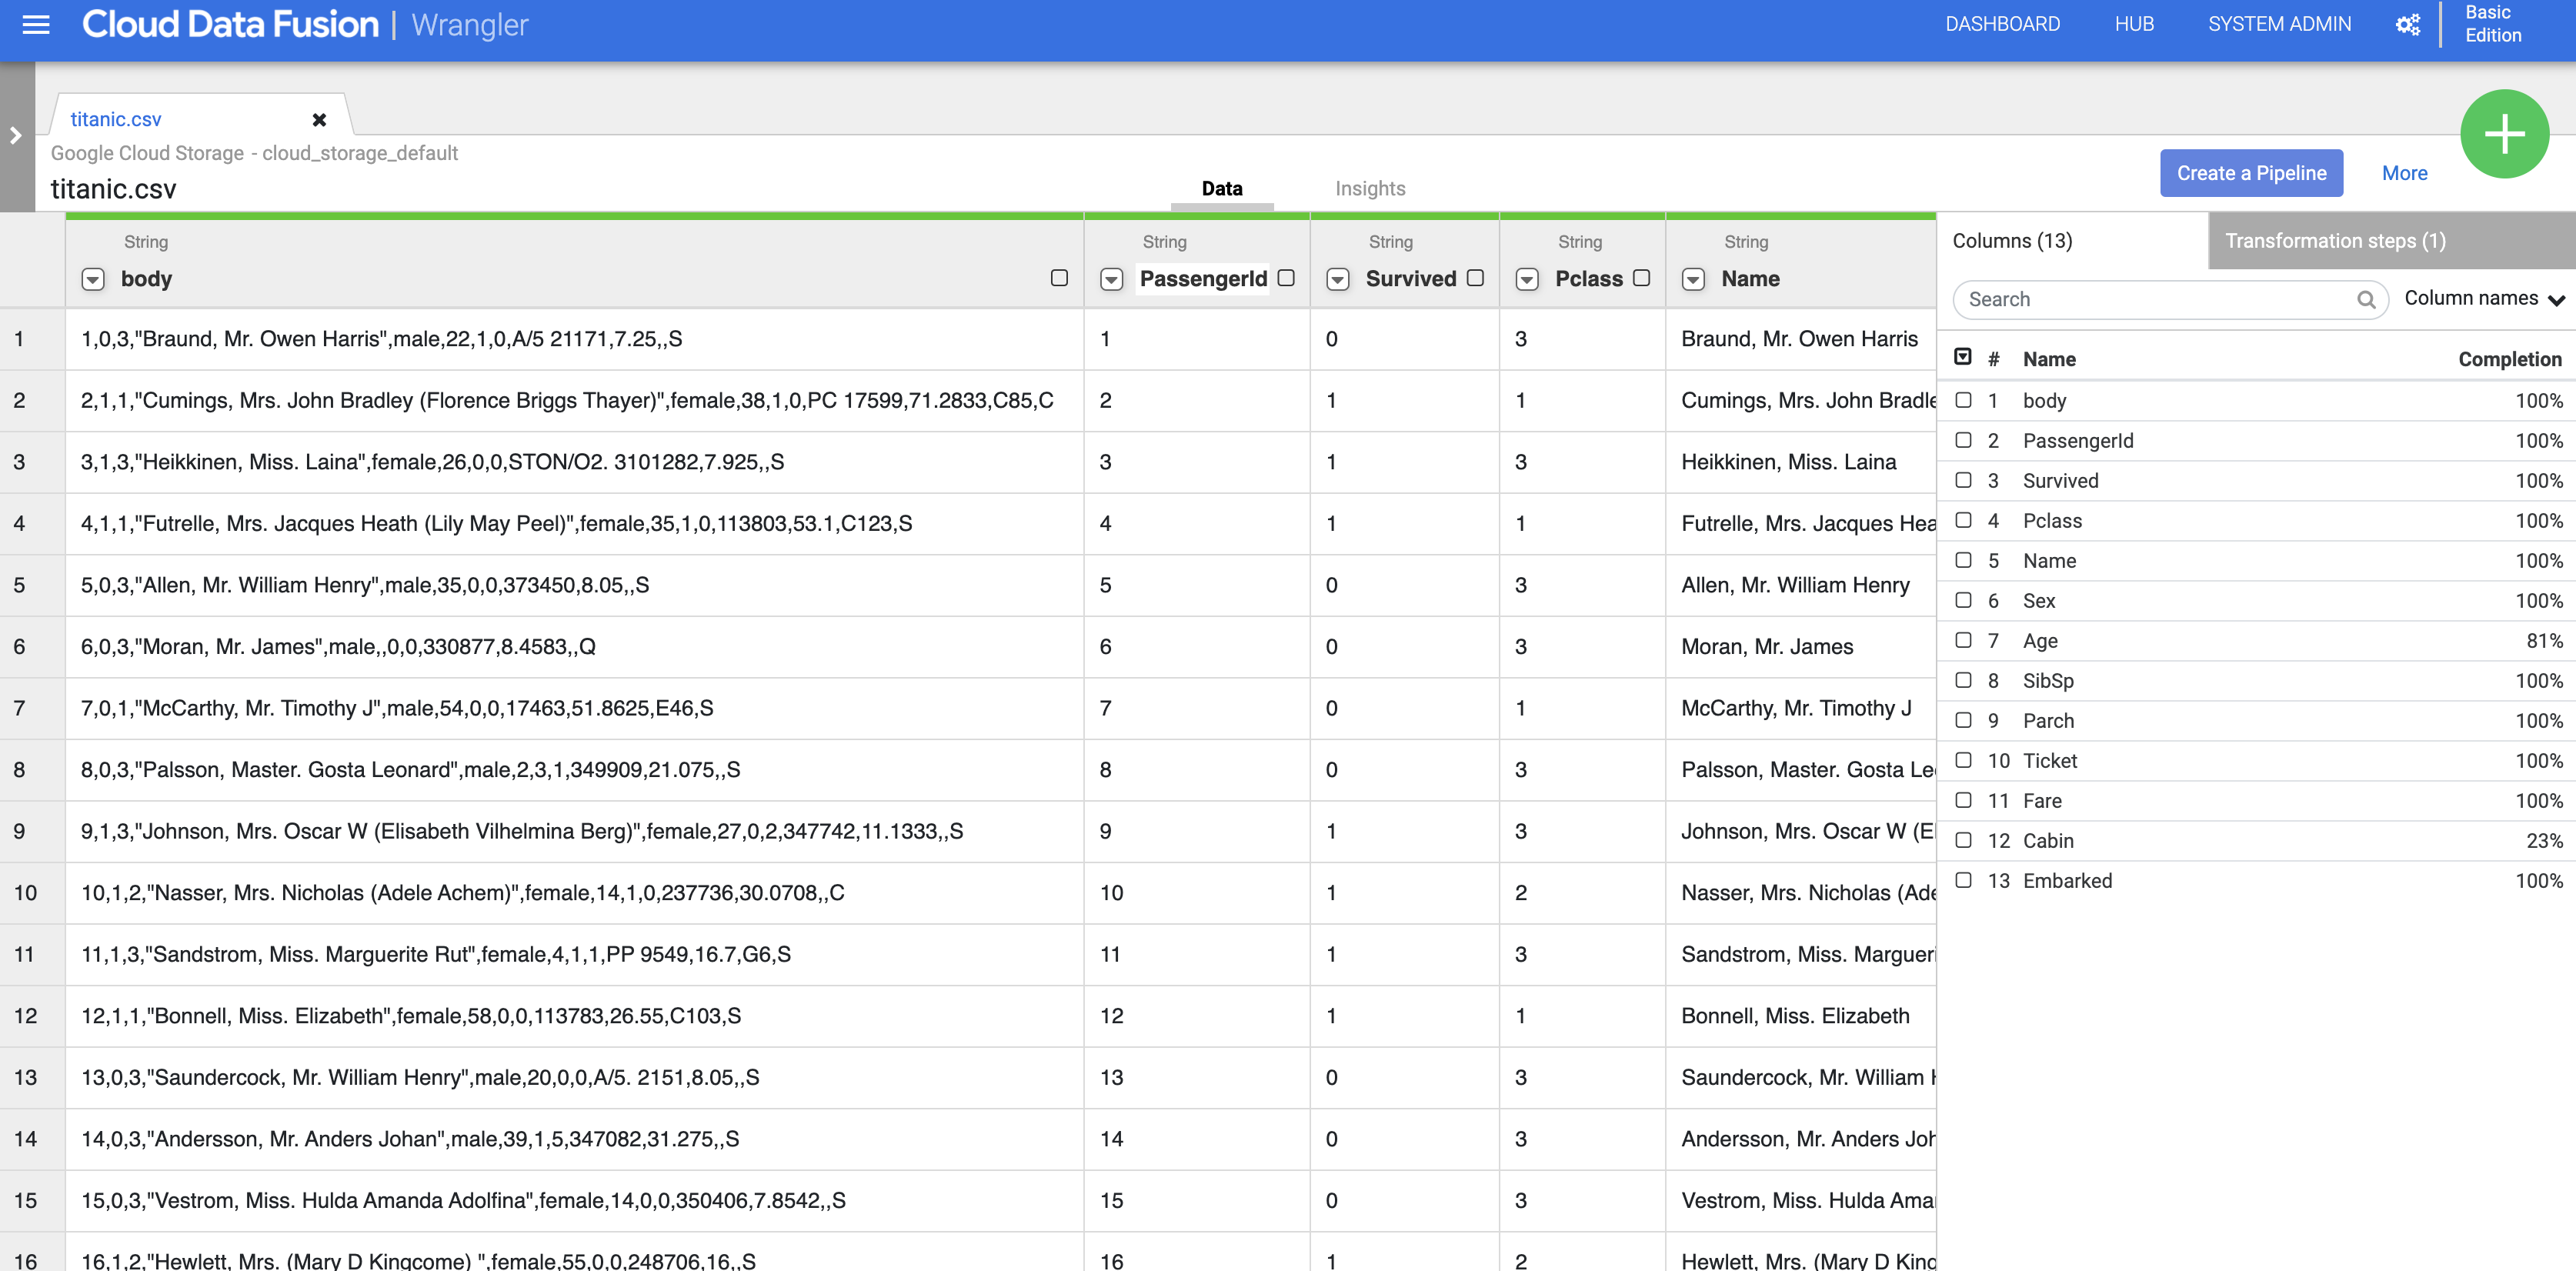
資料會隨即載入至 Wrangler 畫面。現在,您可以開始反覆套用並調整資料轉換了。
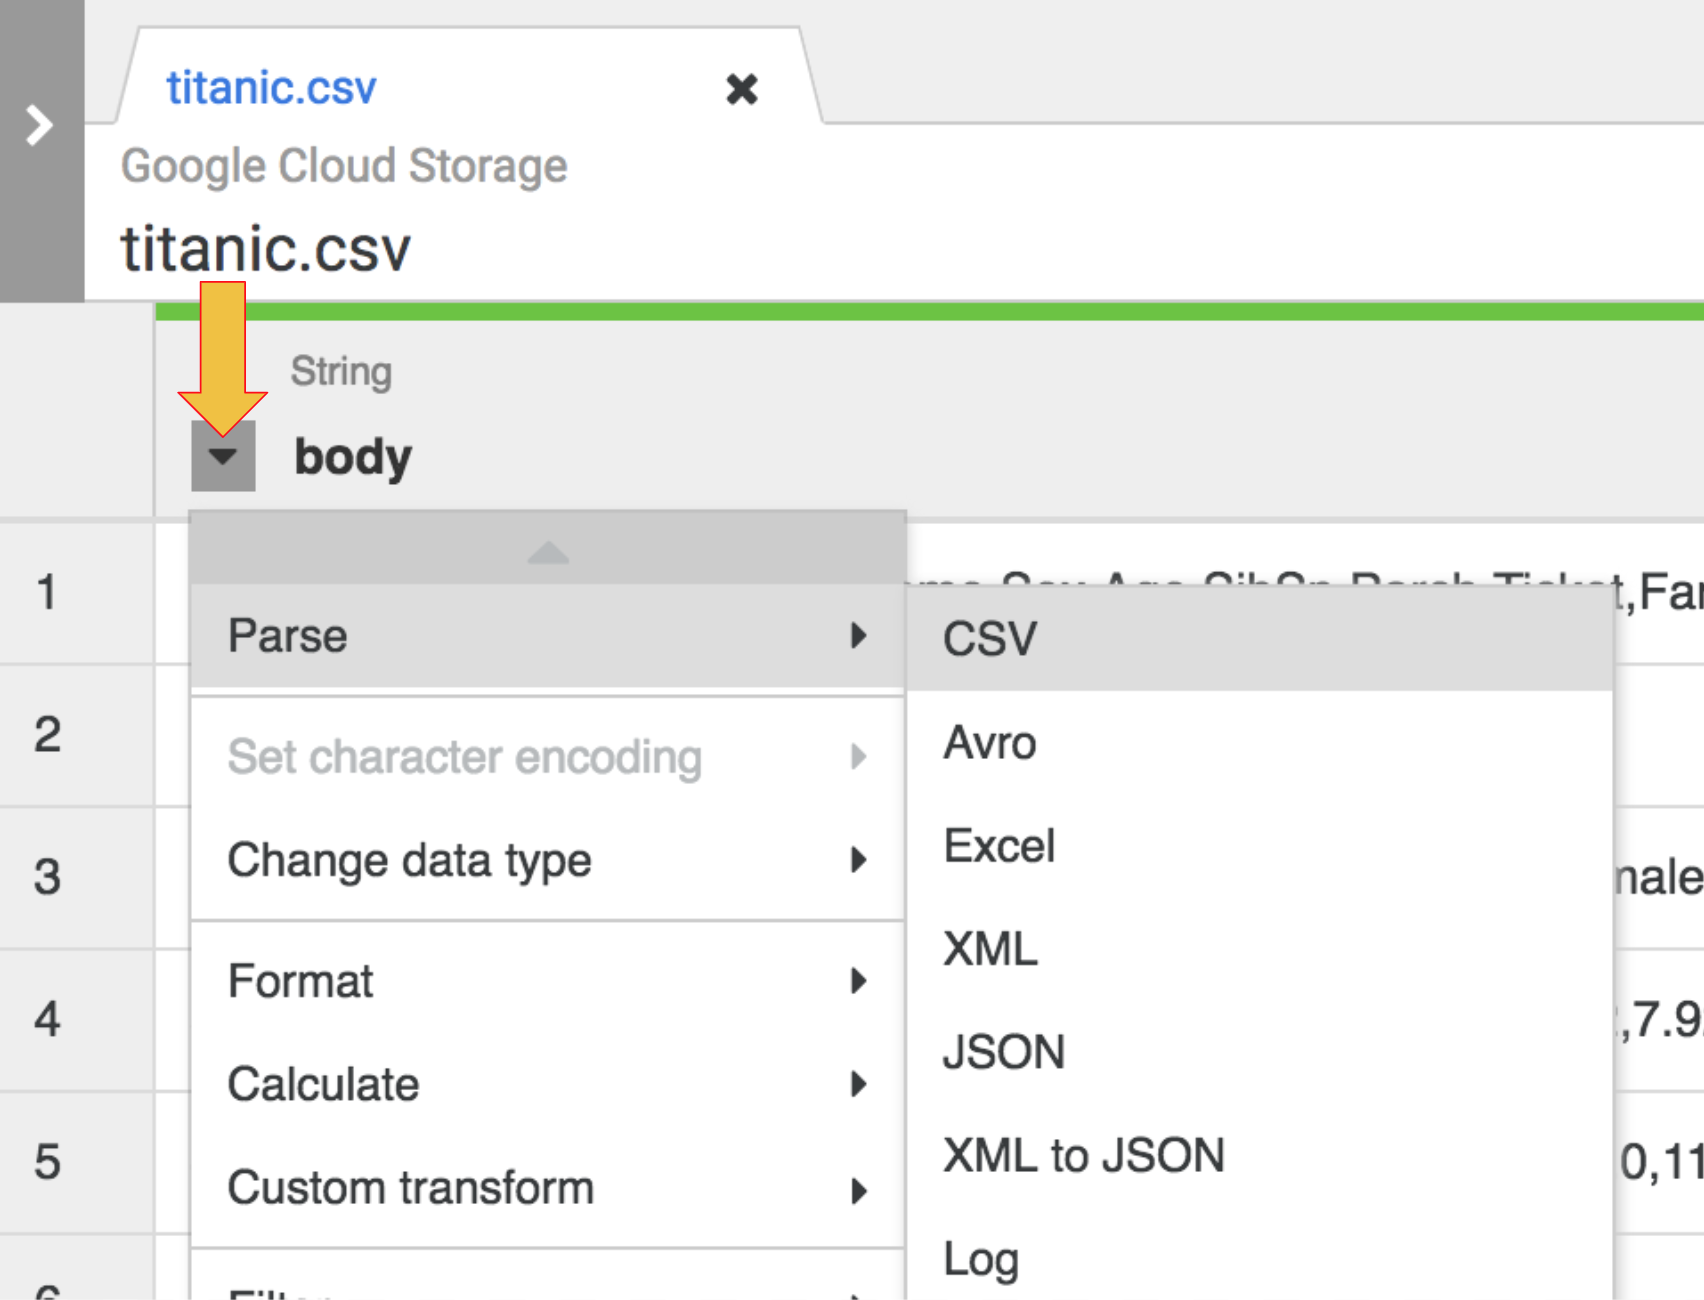
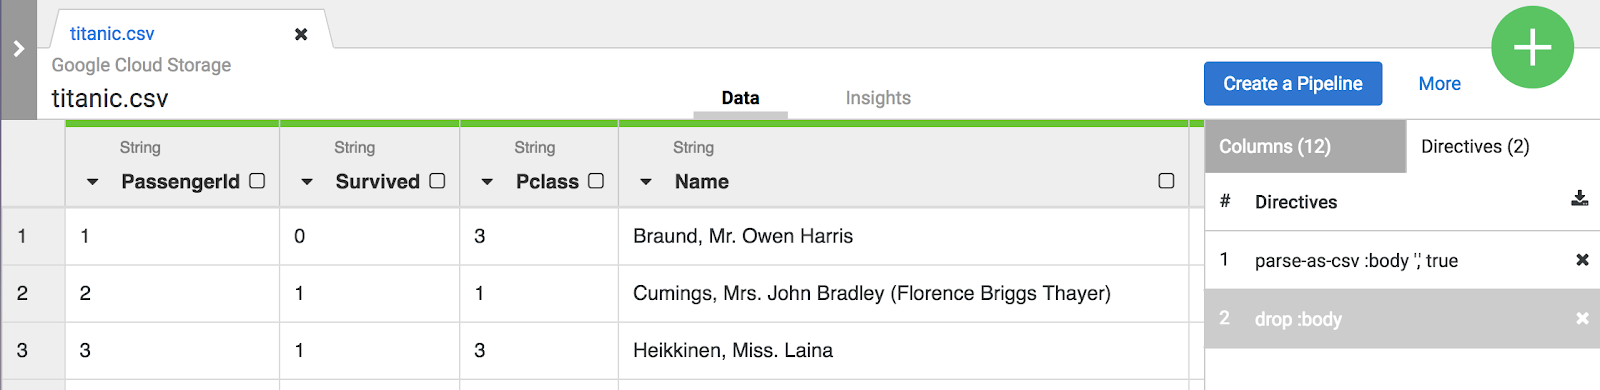
點選「body」欄標題旁的箭頭,然後依序選取「Parse」>「CSV」,將原始 CSV 資料剖析為表格格式。
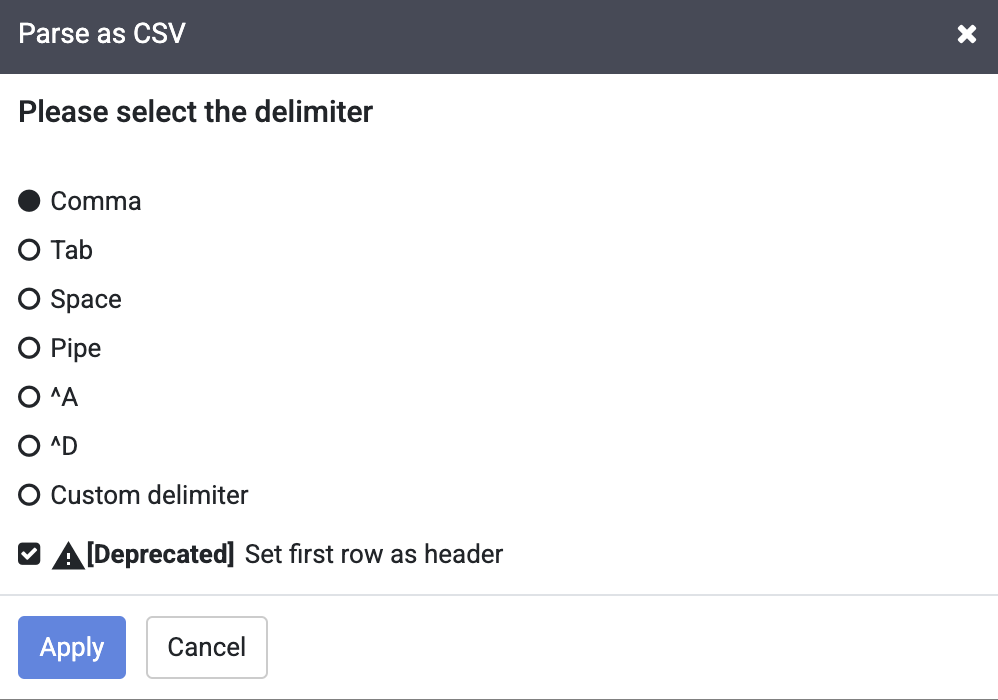
在「Parse as CSV」對話方塊,勾選「Set first row as header」核取方塊,然後點選「Apply」。
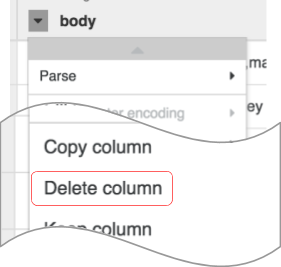
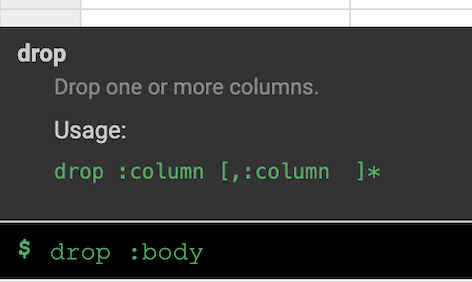
drop :body 指令。
在本實驗室中,只要有這兩項轉換 (即 recipe),就足以建立 ETL 管道。下一步是將這個 recipe 整合至管道建構步驟,發揮 ETL 中「T」(轉換) 的功能。
點選「Create a Pipeline」按鈕,前往下一節開始建立管道,屆時您將瞭解 ETL 管道如何串連運作。
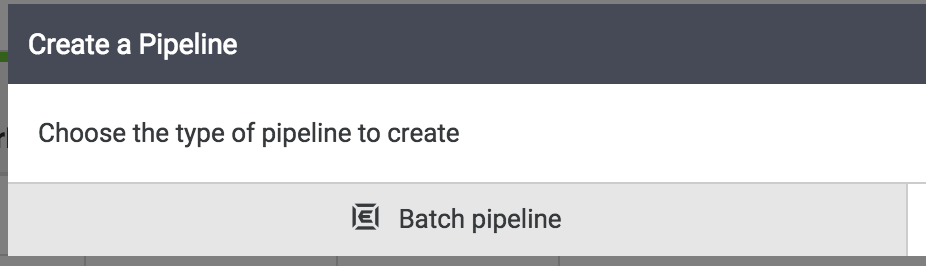
出現下一個對話方塊時,選取「Batch pipeline」繼續操作。
其餘的管道建構工作都會在 Pipeline Studio 進行,您可以透過這個視覺化介面來編排資料管道。現在,Studio 畫面上應該會出現 ETL 管道的主要建構模塊。
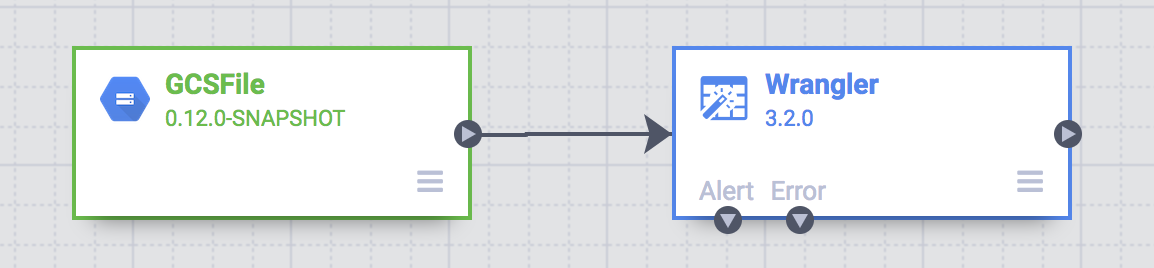
目前,管道中可以看到兩個節點:GCSFile 外掛程式會從 Google Cloud Storage 讀取 CSV 檔案;Wrangler 外掛程式則包含轉換 recipe。
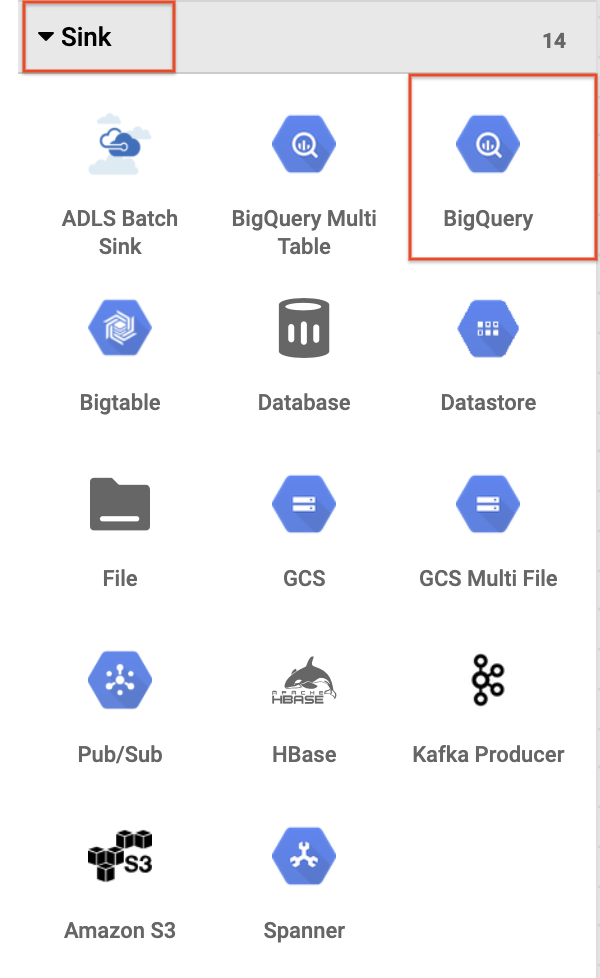
這兩個外掛程式 (節點) 分別代表 ETL 管道的 E (擷取) 和 T (轉換) 部分。想要順利完成這個管道,必須新增 BigQuery 接收器,也就是 ETL 的 L (載入) 部分。
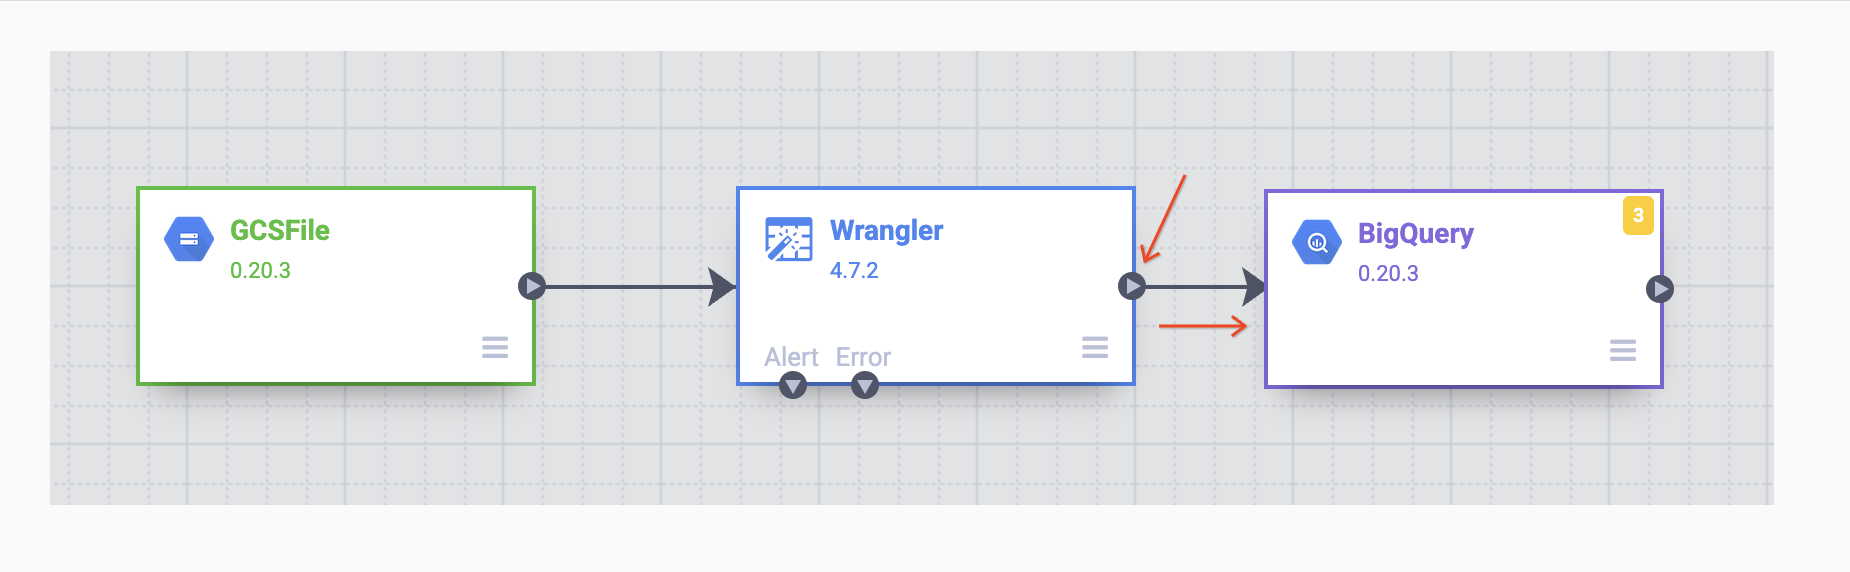
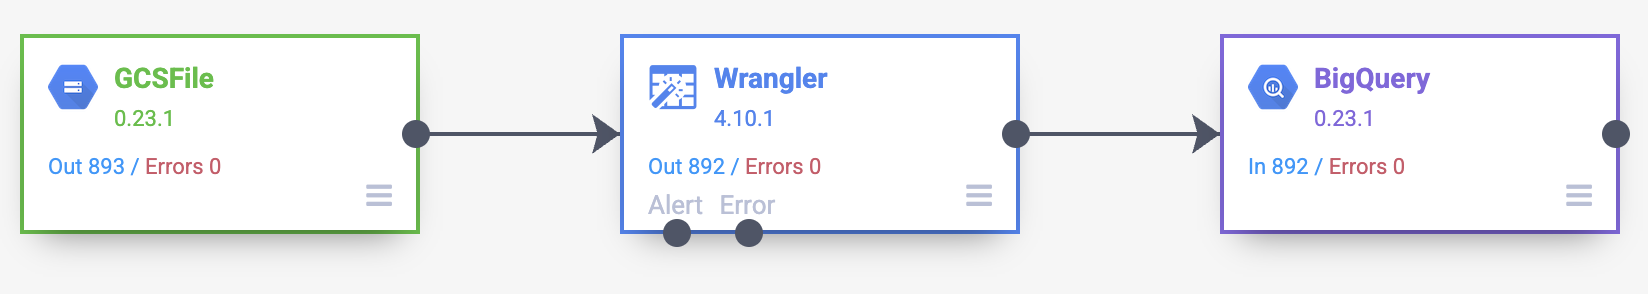
在資料畫布放好 BigQuery 接收器後,將 Wrangler 節點連至 BigQuery 節點。如下圖所示,只要把 Wrangler 節點上的箭頭拖曳到 BigQuery 節點即可。最後再指定一些設定選項,就能將資料寫入所需的資料集。
現在,讓我們開始設定管道。請開啟每個節點的屬性,確認相關設定是否正確,並視需要進一步調整。
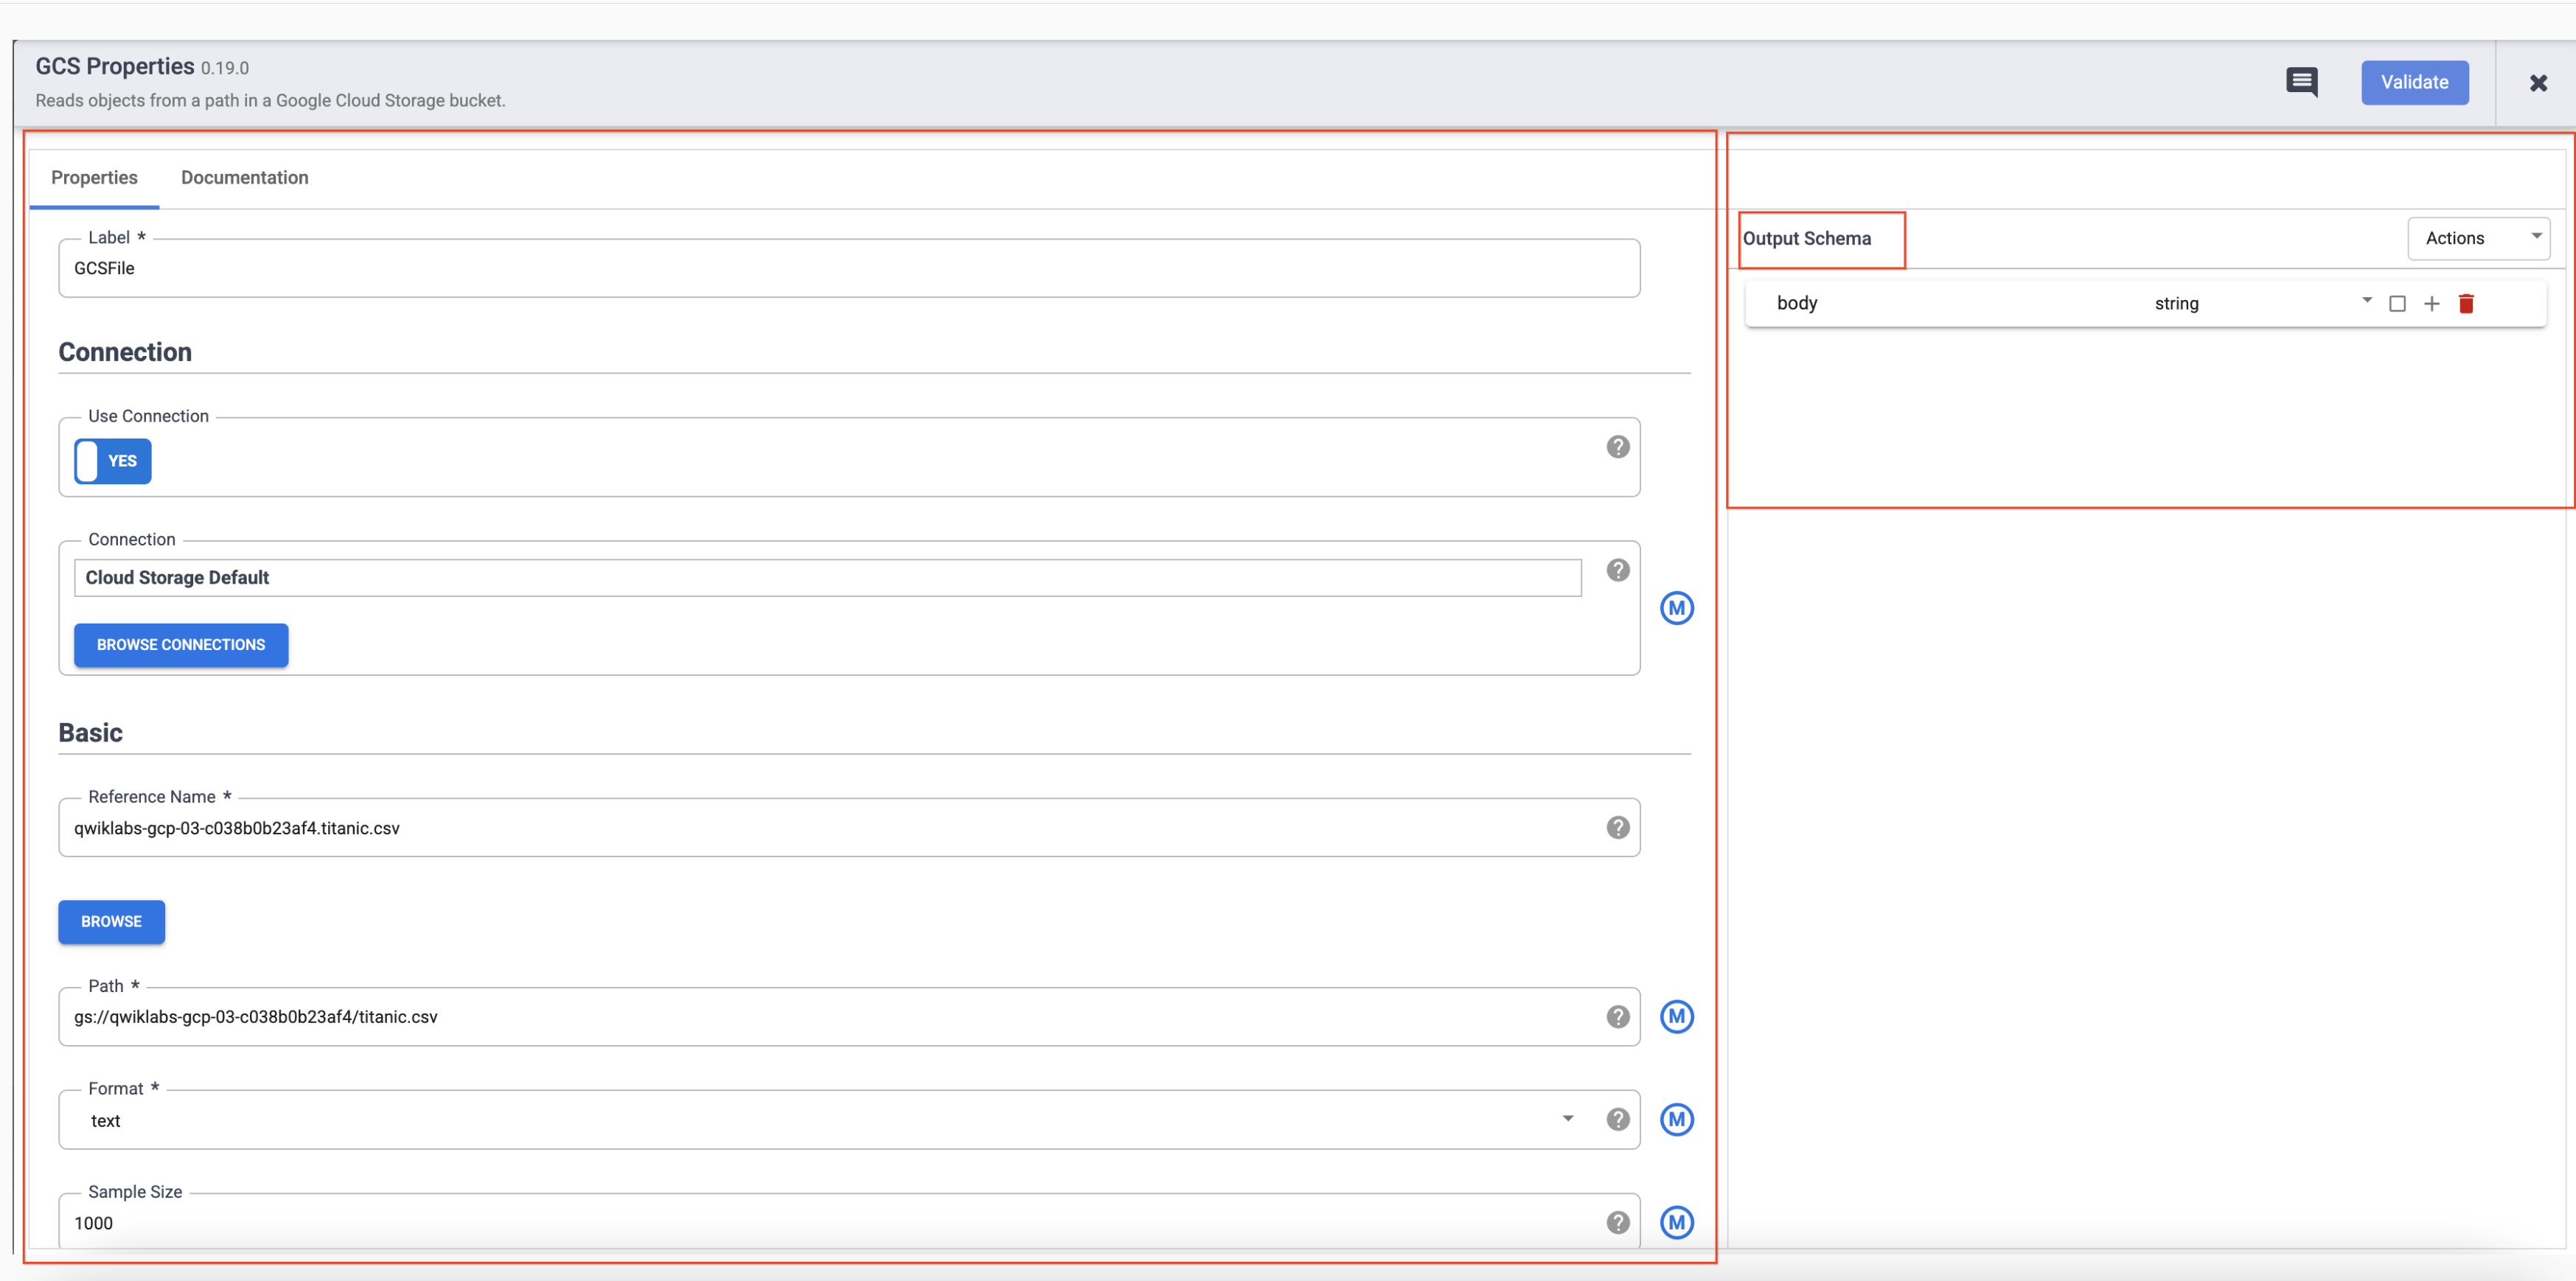
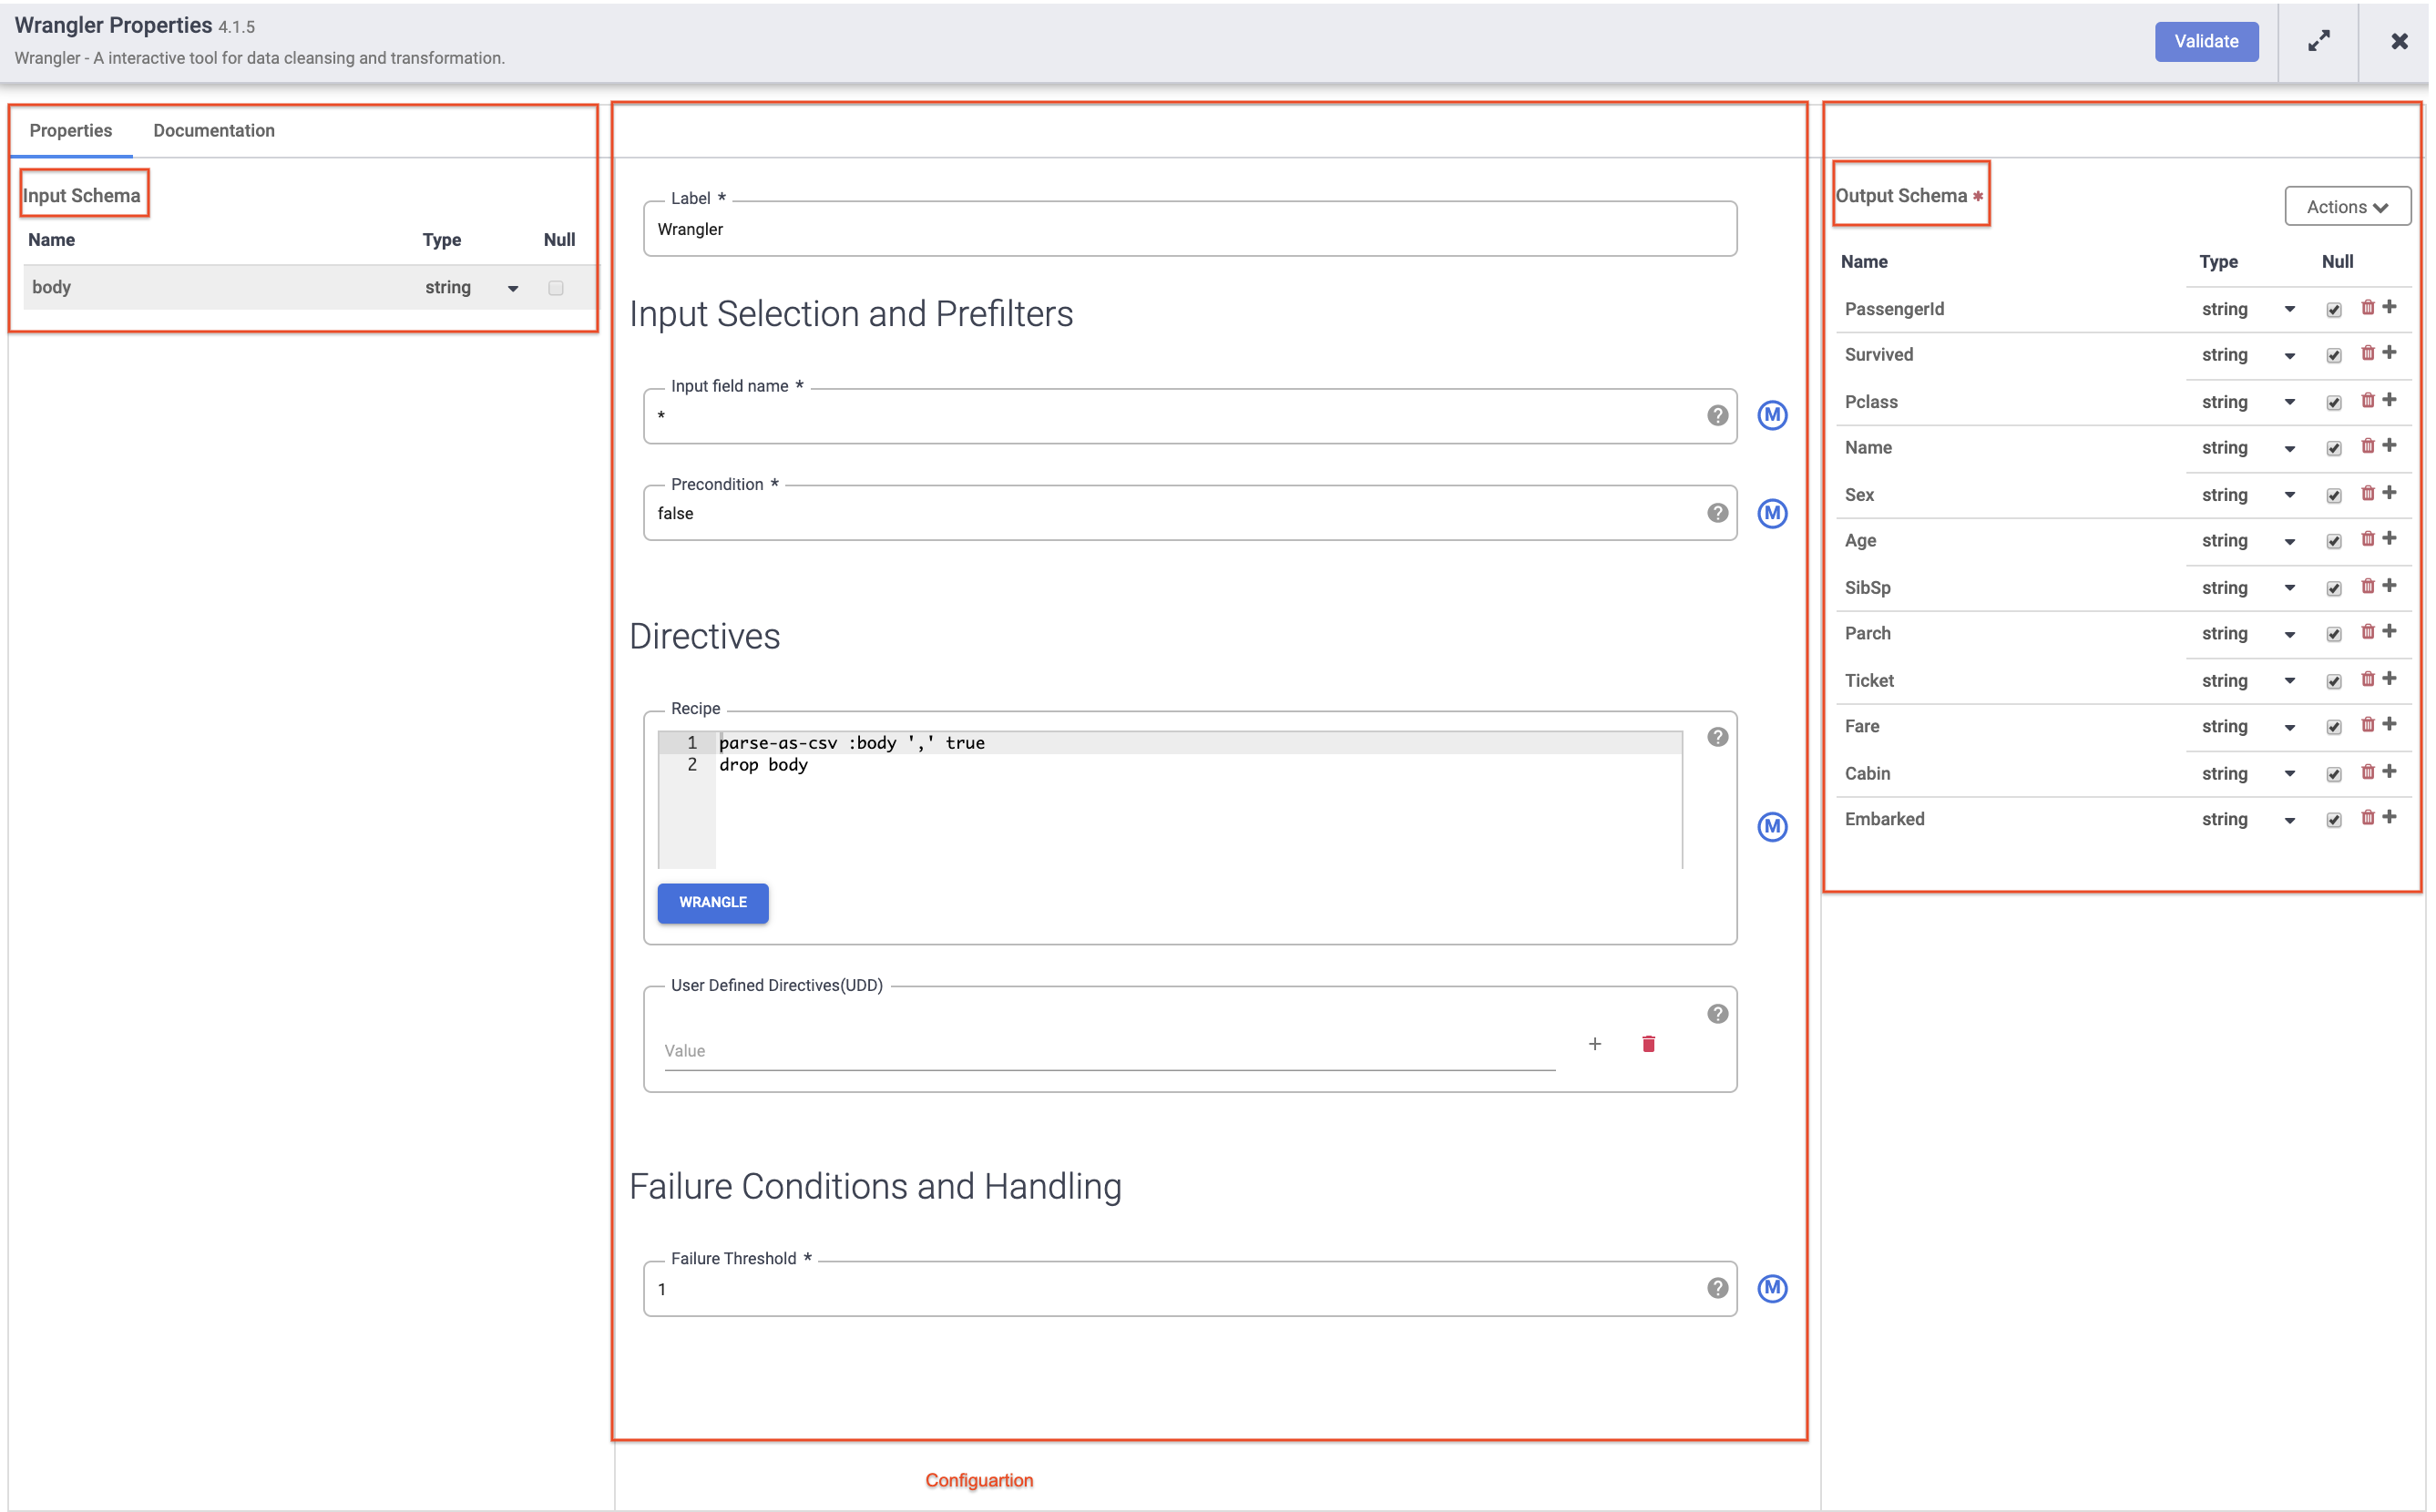
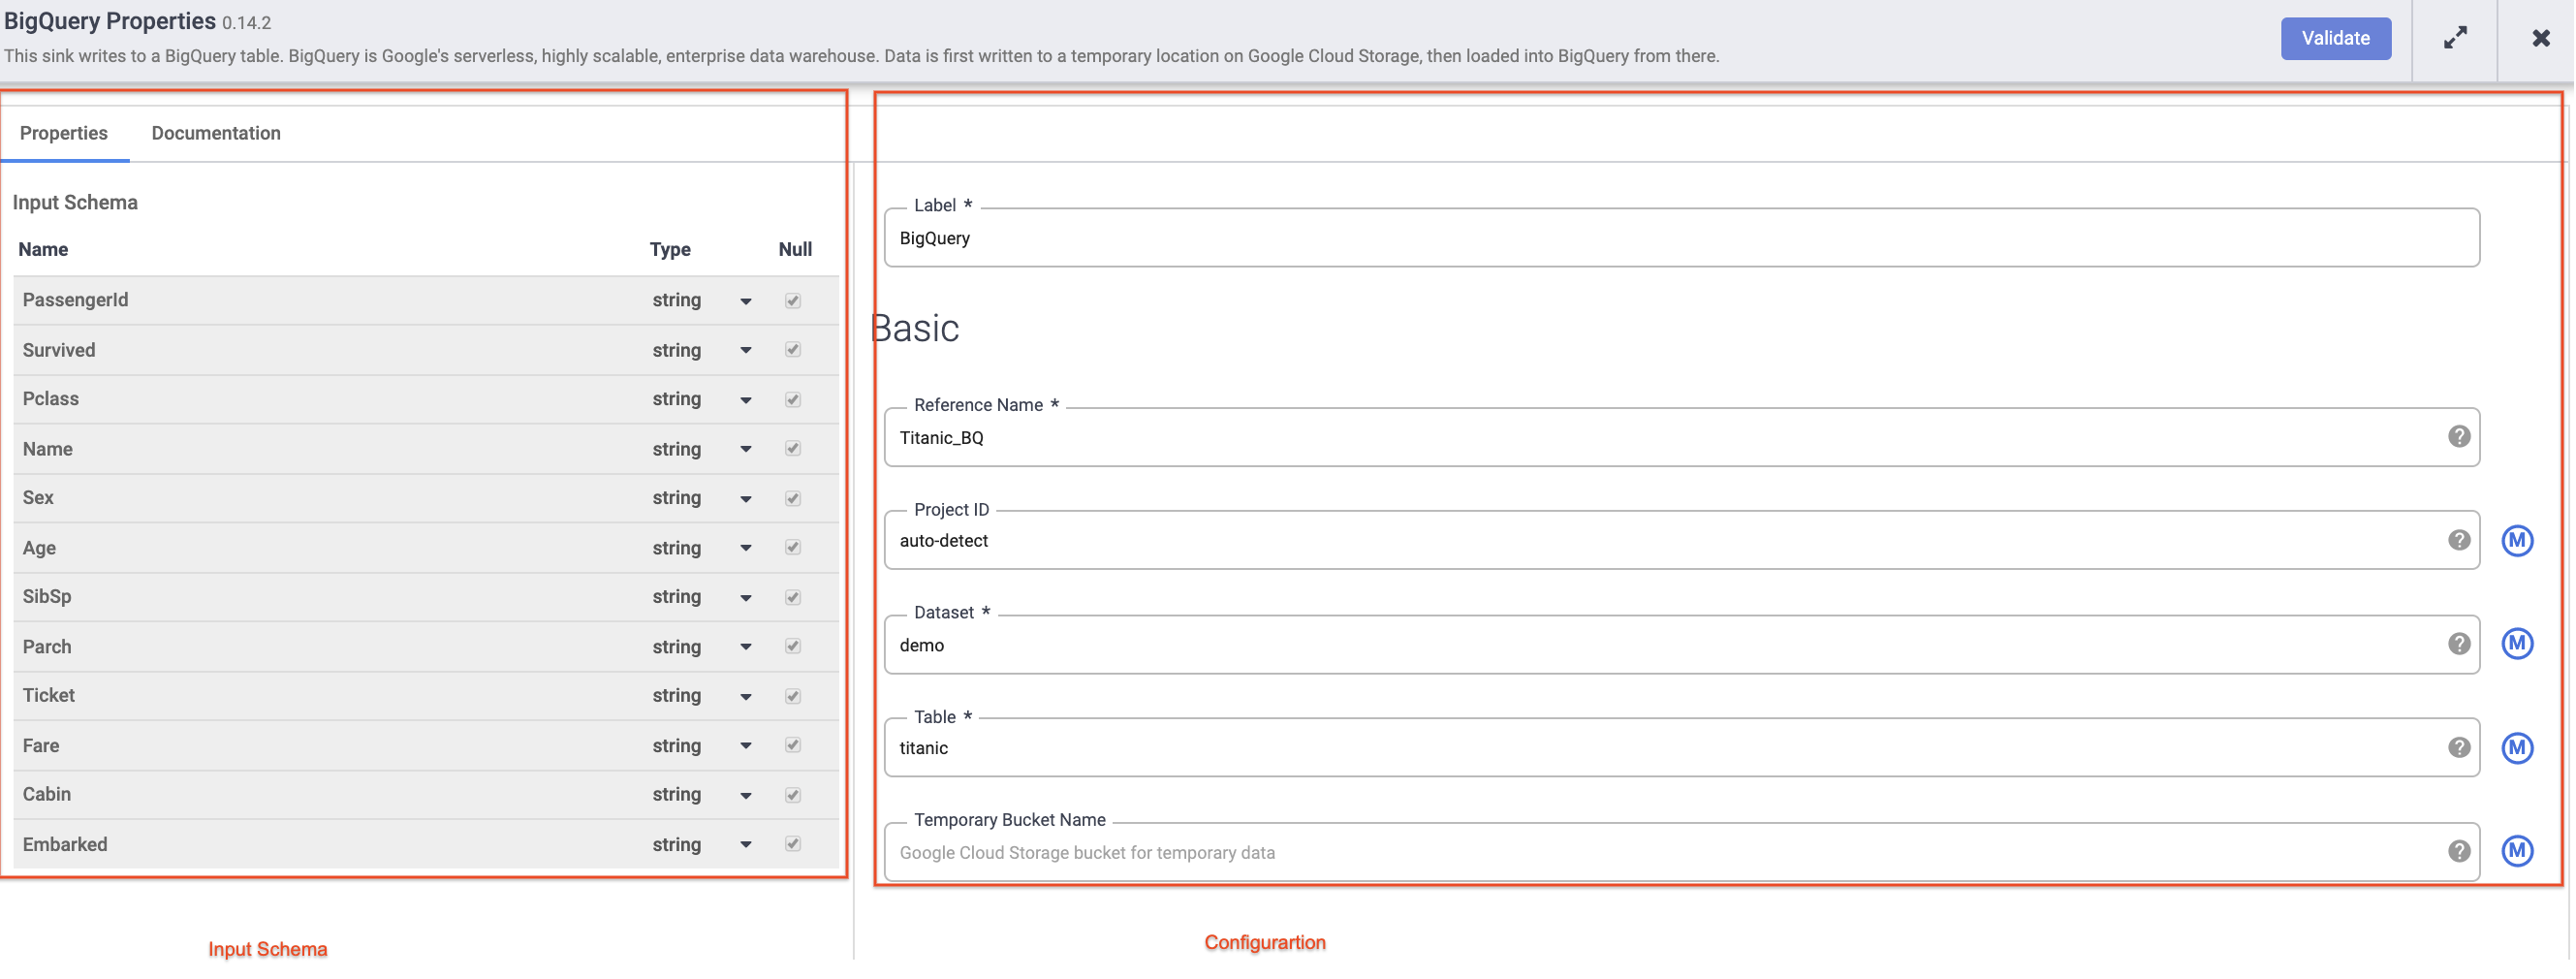
每個外掛程式都有幾個必填欄位,並以星號 (*) 標示。視使用的外掛程式而定,您可能會看到左側的「Input Schema」(輸入內容的結構定義)、中間的「Configuration」(設定) 部分,以及右側的「Output Schema」(輸出內容的結構定義)。
您會發現「接收器」外掛程式沒有輸出內容的結構定義,而「來源」外掛程式沒有輸入內容的結構定義。不過,這兩種外掛程式都有必填的「Reference Name」欄位,用來識別歷程的資料來源/接收器。
每個外掛程式都包含「Label」欄位,這個標籤會顯示在資料畫布的管道節點上,方便您識別。
點選右上方的「X」,關閉「Properties」方塊。
接著將滑鼠游標懸停在「Wrangler」節點上,然後點選「Properties」。
點選右上方的「X」,關閉「Properties」方塊。
將滑鼠游標懸停在 BigQuery 節點上,點選「Properties」,然後按照下列指示輸入設定:
在「Reference Name」部分,輸入 Titanic_BQ。
在「Dataset」部分,輸入 demo。
在「Table」部分,輸入 titanic。
點選右上方的「X」,關閉「Properties」方塊。
最後一步是測試管道能否正常運作。但在開始前,請務必先命名並儲存草稿,以免工作進度遺失。
點選右上角選單中的「Save」,系統會提示您為管道命名並新增說明。
ETL-batch-pipeline 做為管道名稱。ETL pipeline to parse CSV, transform and write output to BigQuery 做為說明。點選「Save」。
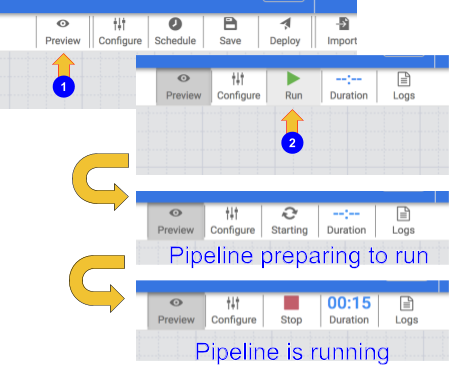
點選「Preview」圖示來測試管道,這時按鈕列會顯示「Run」圖示,點選後即可在預覽模式中執行管道。
點選「Run」圖示。以預覽模式執行管道時,資料不會真的寫入 BigQuery 資料表,但您能藉此確認資料讀取作業是否正常,並確保部署管道後,資料會如預期寫入。「Preview」按鈕是切換鈕,操作完畢後請再次點選,才能退出預覽模式。
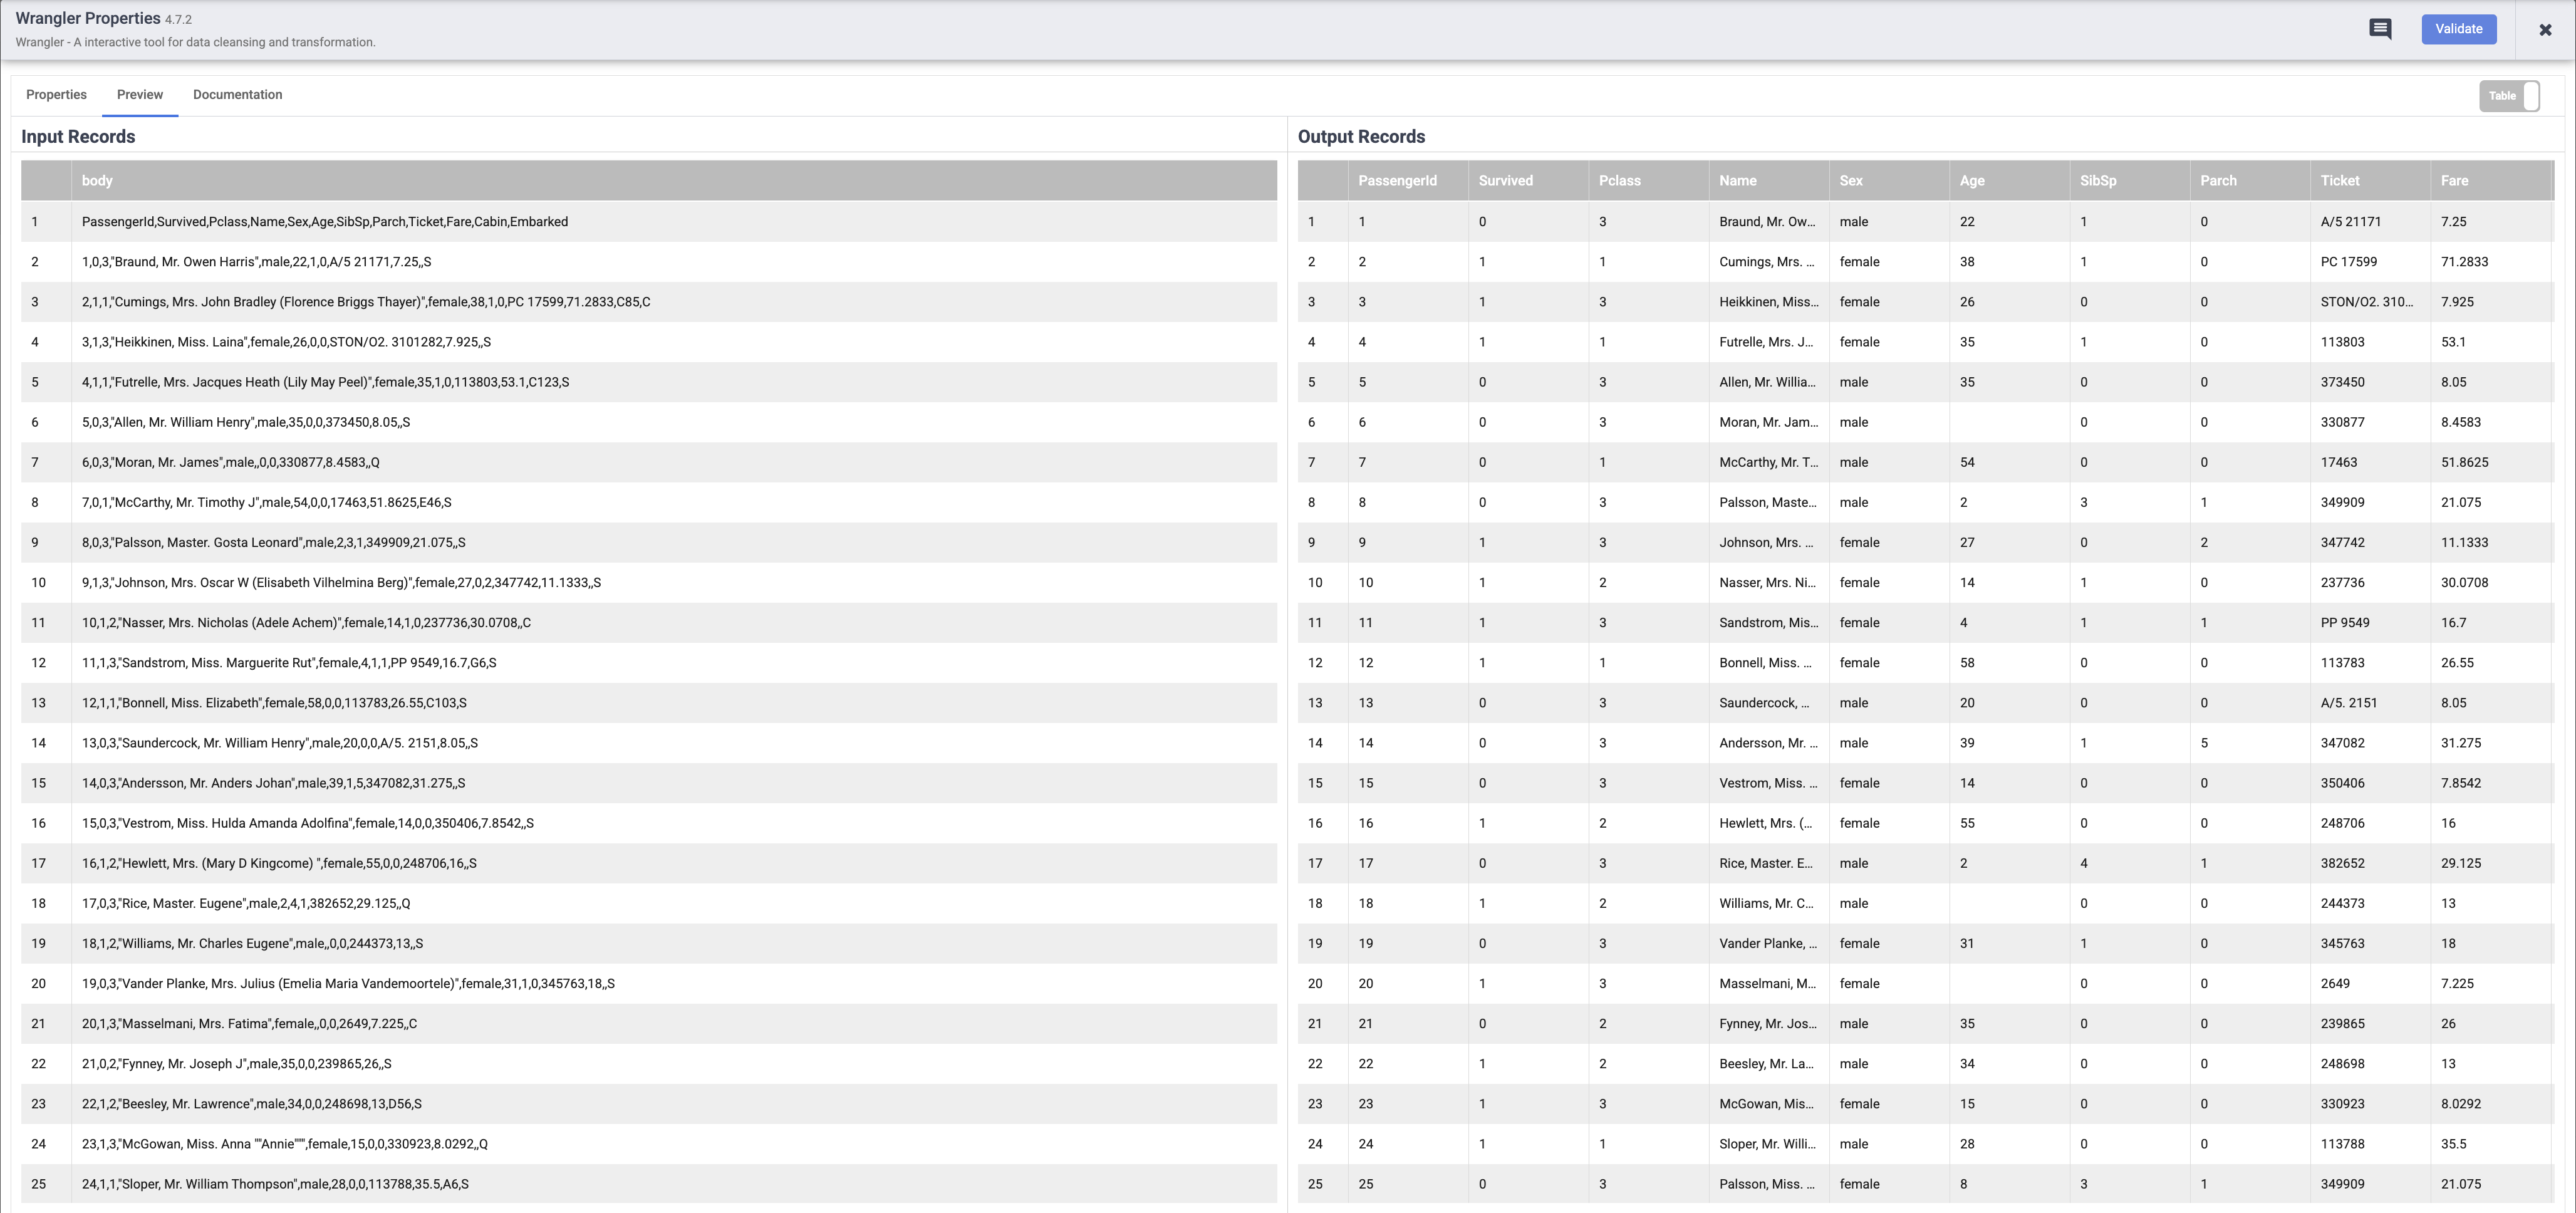
管道執行完畢後,將滑鼠游標懸停在 Wrangler 節點上,然後依序點選「Properties」>「Preview」分頁標籤。如果執行順利,您應該會看到來自輸入端 (左側節點) 的原始資料,以及即將輸出至右側節點的剖析記錄。確認後,請點選右上方的「X」,關閉「Properties」方塊。
再次點選「Preview」圖示,退出預覽模式。
如果目前為止都沒問題,請點選右上方的「Deploy」圖示 
確認對話方塊會隨即顯示,指出正在部署管道:
成功部署後,您就能執行 ETL 管道,將部分資料載入 BigQuery。
點選「Run」圖示,執行 ETL 工作。
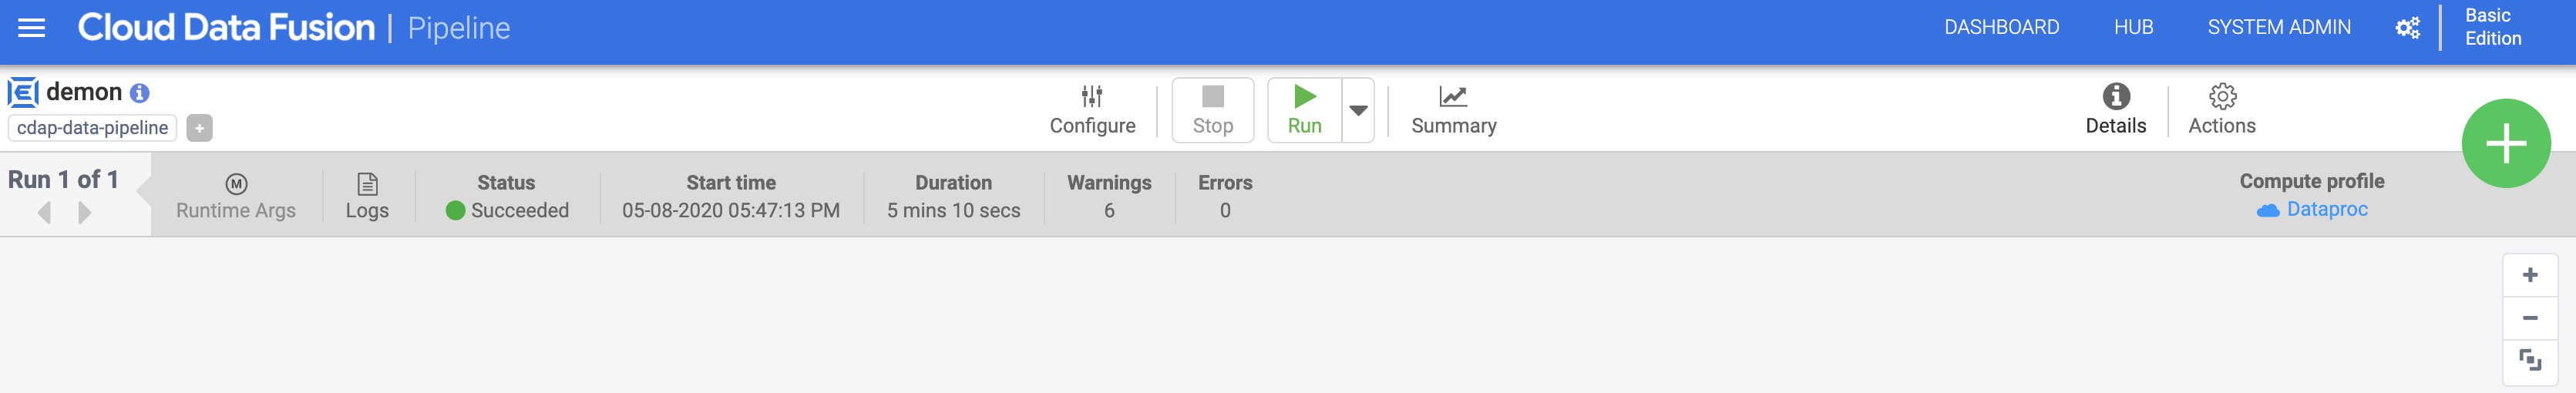
執行完成後,管道狀態應該會變更為「Succeeded」,代表管道已順利執行。
管道在處理資料時,各個節點都會產生指標,指出目前處理完成的記錄筆數。您會發現剖析作業只顯示 892 筆記錄,但來源卻有 893 筆記錄,這是因為第一列資料會用於設定欄標題,扣除掉這一列,剩下的 892 筆才是真正要處理的資料。
點選「Check my progress」,確認目標已達成
管道會將輸出內容寫入 BigQuery 資料表,您可以按照下列步驟確認。
在新的分頁,前往 Cloud 控制台開啟 BigQuery UI,或是對控制台分頁按一下滑鼠右鍵,然後選取「複製」,再從「導覽選單」選取「BigQuery」。看到提示訊息後,請點選「完成」。
在左側窗格的「傳統版 Explorer」部分,點選專案 ID (開頭為 qwiklabs)。
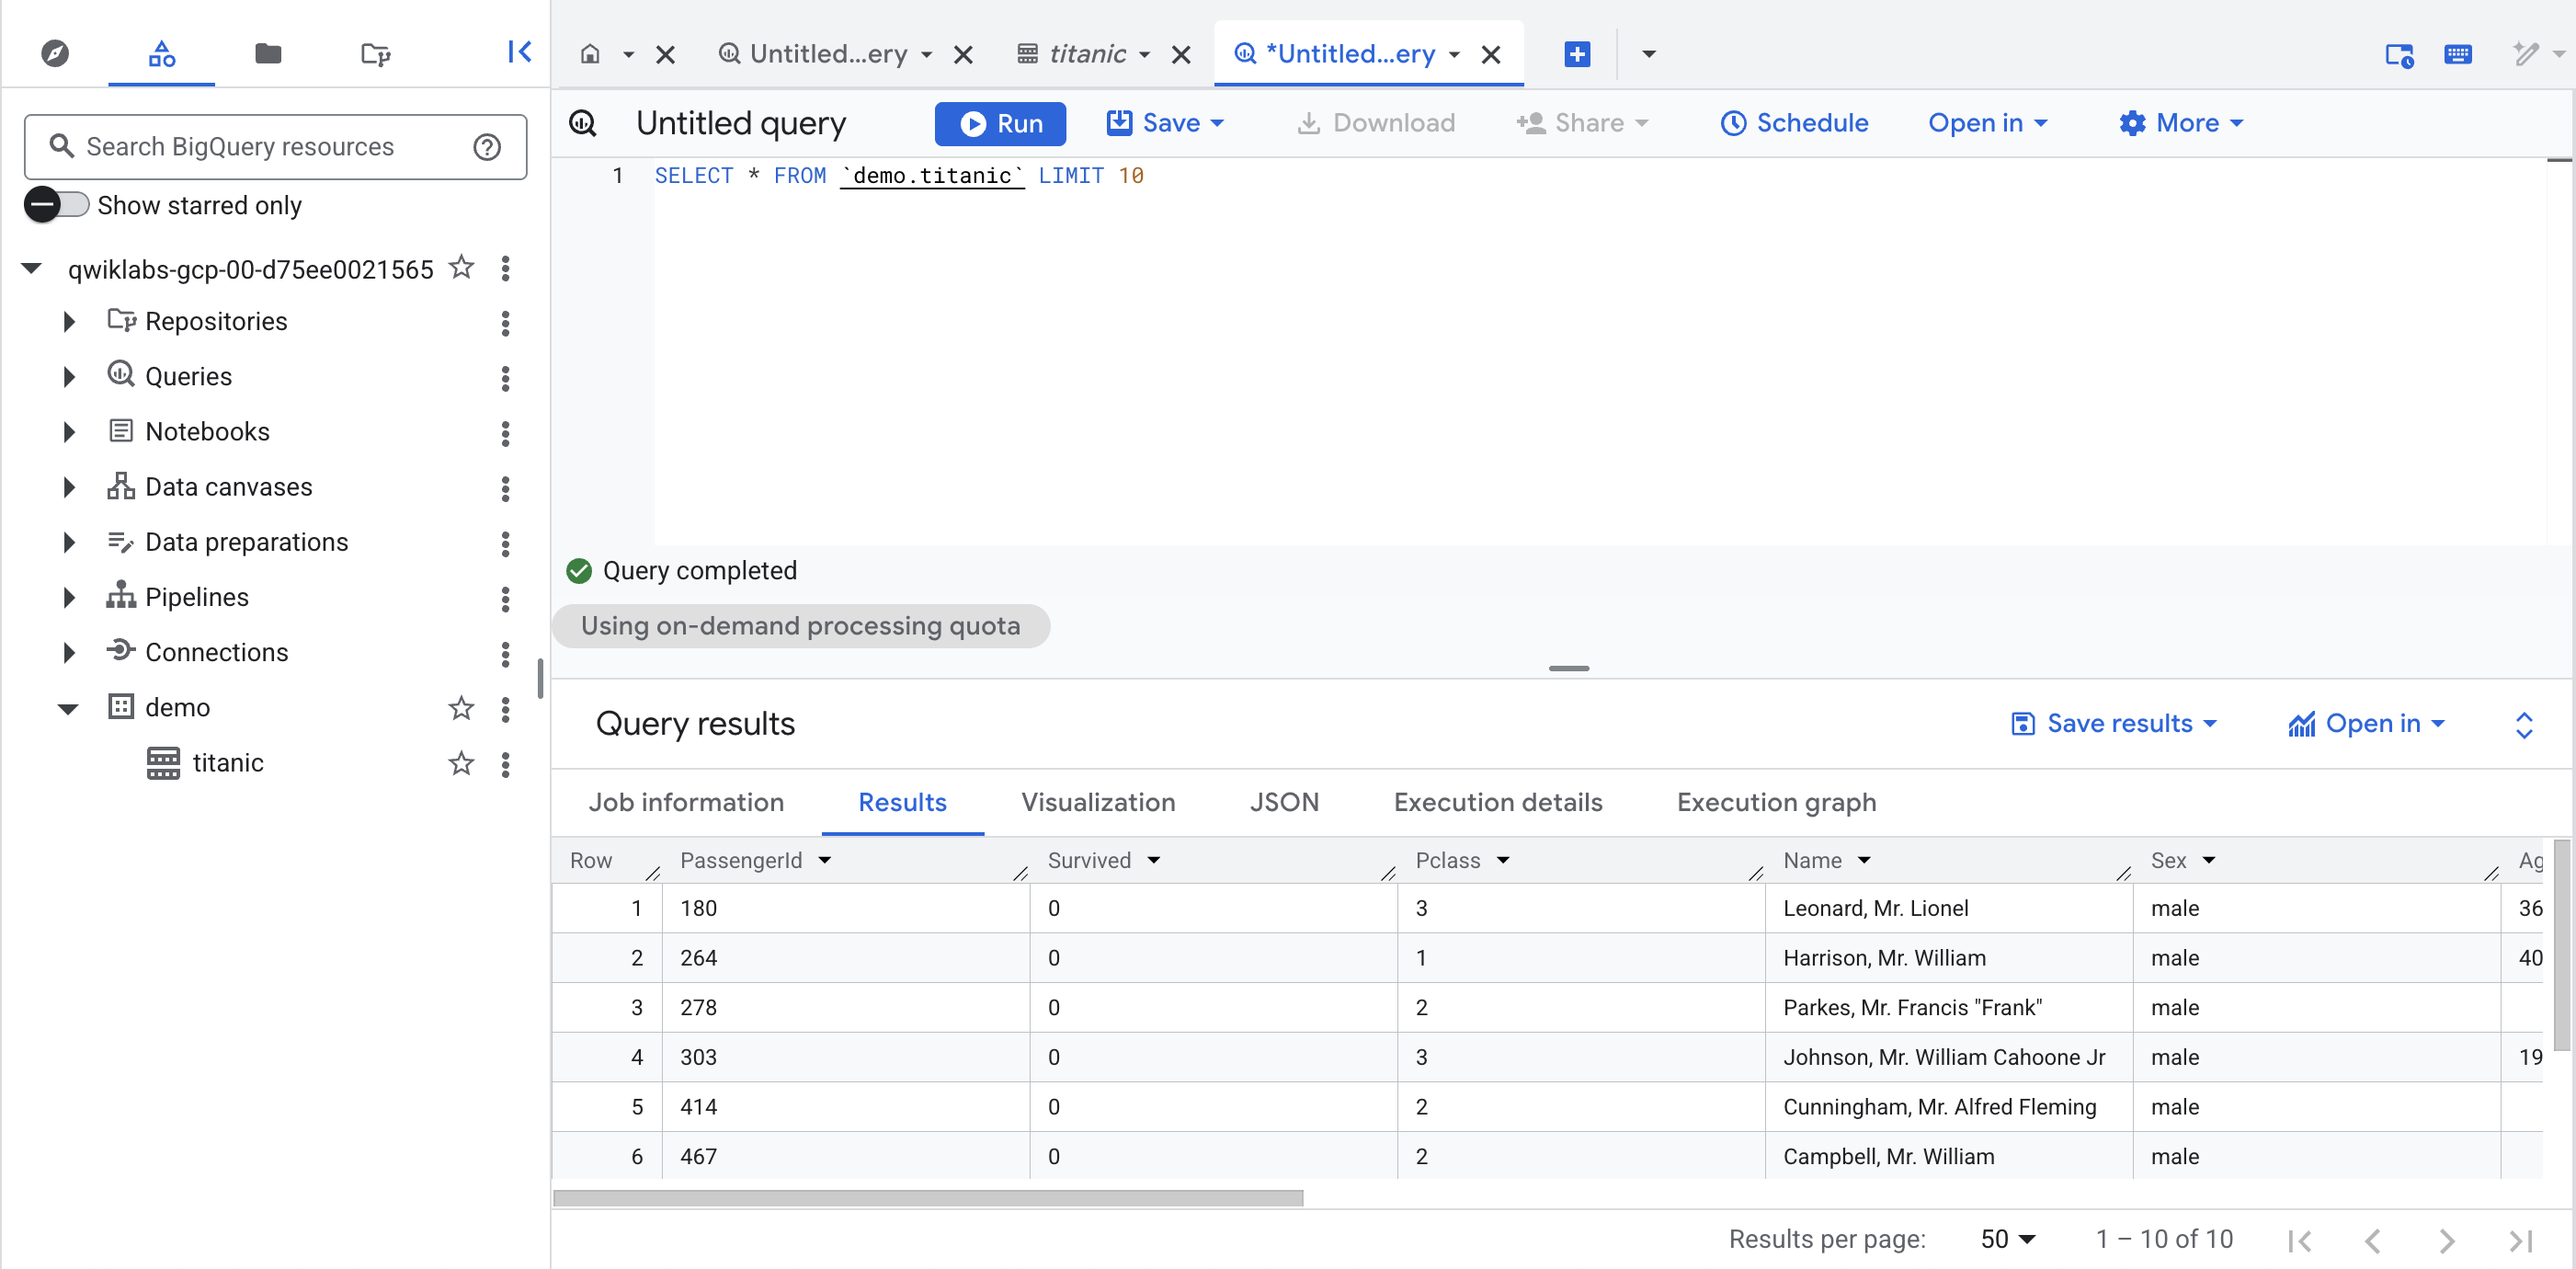
在專案的「demo」資料集下方,依序點選「titanic」資料表 >「+」圖示 (SQL 查詢),然後執行簡單的查詢,例如:
點選「Check my progress」,確認目標已達成
您已學會使用 Cloud Data Fusion 的 Pipeline Studio 建構模塊來建立批次管道,也瞭解如何透過 Wrangler 建立資料轉換步驟。
請繼續進行「在 Cloud Data Fusion 運用 Wrangler 建構轉換並準備資料」實驗室。
使用手冊上次更新日期:2026 年 7 月 14 日
實驗室上次測試日期:2026 年 7 月 14 日
Copyright 2026 Google LLC 保留所有權利。Google 和 Google 標誌是 Google LLC 的商標,其他公司和產品名稱則有可能是其關聯公司的商標。



This content is not currently available
We can notify you via email when it becomes available

Great!
We can contact you via email if it becomes available


One lab at a time
Confirm to end all existing labs and start this one