
准备工作
- 实验会创建一个 Google Cloud 项目和一些资源,供您使用限定的一段时间
- 实验有时间限制,并且没有暂停功能。如果您中途结束实验,则必须重新开始。
- 在屏幕左上角,点击开始实验即可开始

Create a GCS bucket
/ 25
Create an instance template
/ 25
Create an instance group
/ 25
Configure autoscaling for the instance group
/ 25
Create a GCS bucket
/ 25
Create an instance template
/ 25
Create an instance group
/ 25
Configure autoscaling for the instance group
/ 25


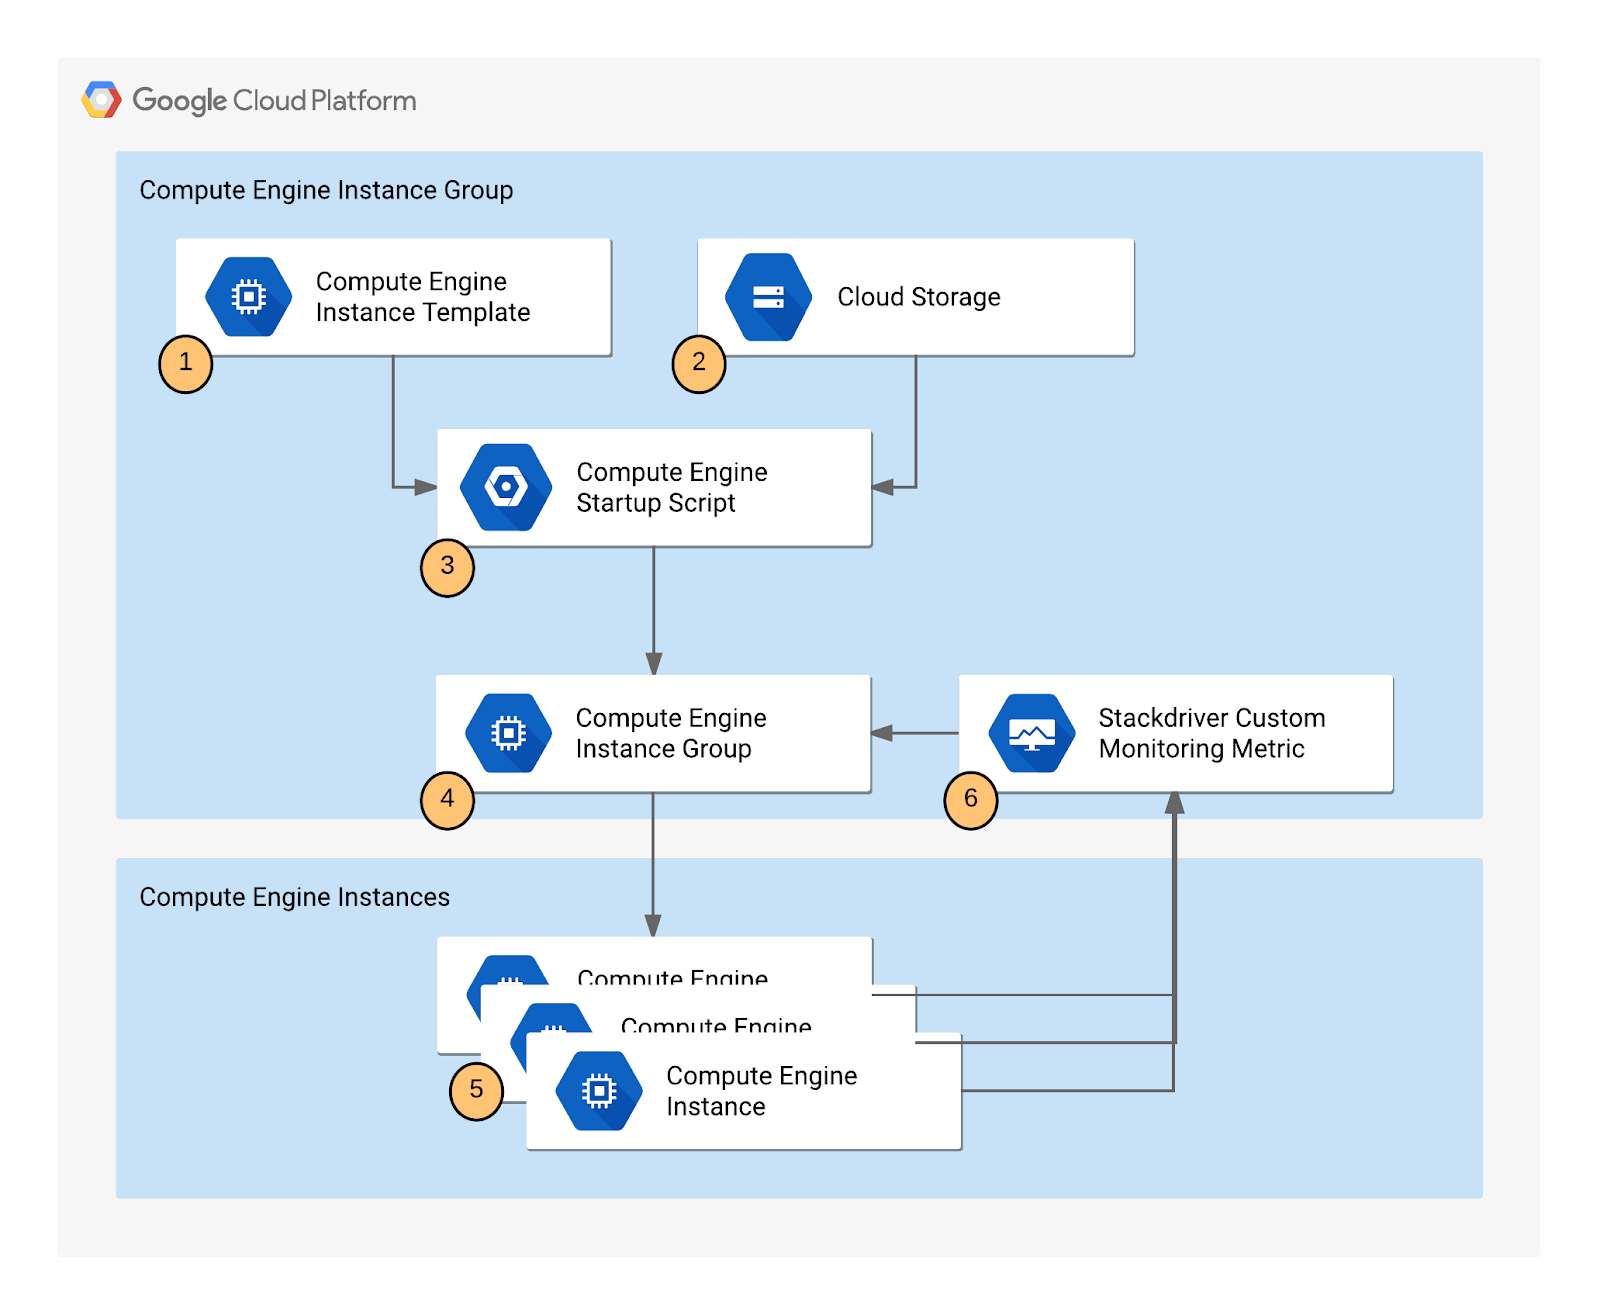
通过在 Compute Engine 托管式实例组 (MIG) 中使用自动扩缩功能,可根据用户需求自动调整容量,从而确保应用的可靠性和成本效益。
在本实验中,您将部署一个基于指标自动扩缩的托管式实例组,然后使用 Monitoring 确认您的应用能否自动管理其容量。
在本实验中,您将学习如何执行以下任务:
请阅读以下说明。实验是计时的,并且您无法暂停实验。计时器在您点击开始实验后即开始计时,显示 Google Cloud 资源可供您使用多长时间。
此实操实验可让您在真实的云环境中开展实验活动,免受模拟或演示环境的局限。为此,我们会向您提供新的临时凭据,您可以在该实验的规定时间内通过此凭据登录和访问 Google Cloud。
为完成此实验,您需要:
点击开始实验按钮。如果该实验需要付费,系统会打开一个对话框供您选择支付方式。右侧是实验设置和访问权限面板,其中包含以下内容:
请注意,实验计时器位于页面顶部附近,将显示剩余时间。
点击打开 Google Cloud 控制台(如果您使用的是 Chrome 浏览器,请右键点击并选择在无痕式窗口中打开链接)。
该实验会启动资源并打开另一个标签页,显示“登录”页面。
提示:可以将这些标签页分别放在不同的窗口中,并排显示。
如有必要,请复制下方的用户名,然后将其粘贴到登录对话框中。
您也可以在实验设置和访问权限面板中找到“用户名”。
点击下一步。
复制下面的密码,然后将其粘贴到欢迎对话框中。
您也可以在实验设置和访问权限面板中找到“密码”。
点击下一步。
依次点击进入后续页面:
片刻之后,系统会在此标签页中打开 Google Cloud 控制台。
Cloud Shell 是一种装有开发者工具的虚拟机。它提供了一个永久性的 5GB 主目录,并且在 Google Cloud 上运行。Cloud Shell 提供可用于访问您的 Google Cloud 资源的命令行工具。
点击 Google Cloud 控制台顶部的激活 Cloud Shell 
在弹出的窗口中执行以下操作:
如果您连接成功,即表示您已通过身份验证,且项目 ID 会被设为您的 Project_ID
gcloud 是 Google Cloud 的命令行工具。它已预先安装在 Cloud Shell 上,且支持 Tab 自动补全功能。
输出:
输出:
gcloud 的完整文档,请参阅 gcloud CLI 概览指南。
实例模板需要通过某种方式在所创建的每个新虚拟机上安装必要的应用和脚本。Cloud Storage 为启动脚本 (startup.sh) 提供了一个稳定且易于访问的来源,该脚本会在新实例启动时执行。
您将复制本实验所用示例应用的启动脚本和应用文件。该应用会将特定的数据模式推送到自定义指标中,随后您可以将该指标配置为控制自动扩缩行为的依据。
在 Cloud 控制台中,从导航菜单中选择 Cloud Storage > 存储桶,然后点击创建。
为存储桶指定唯一名称,不要使用您可能会在其他项目中使用的名称。如需详细了解如何命名存储桶,请参阅存储桶命名准则。您可以使用项目 ID + "bucket" 作为存储桶名称。在本实验中,此存储桶将统称为 YOUR_BUCKET。
接受默认值,然后点击创建。
如果出现 Public access will be prevented 弹出式窗口,请点击确认。
存储桶创建后,系统会打开存储桶详情页面。
验证您已完成的任务
点击检查我的进度,验证您已完成的任务。如果您成功创建了 Cloud Storage 存储桶,则会看到一个评估分数。
<YOUR BUCKET> 替换为您刚刚创建的存储桶的名称:Startup.sh - 一种 Shell 脚本,用于在 Compute Engine 实例被添加到托管式实例组时,为每个实例安装必要的组件。writeToCustomMetric.js - 一个 Node.js 代码段,用于创建自定义监控指标,该指标的值可触发扩缩行为。在生产环境中,这部分内容将由您的实际应用代码替代,而其报告的值 (appdemo_queue_depth_01) 则会是一项关键的业务指标,例如:队列中待处理的消息数、打开的数据库连接数或批处理任务的积压长度。Config.json - 一个 Node.js 配置文件,用于指定自定义监控指标的值,供 writeToCustomMetric.js 使用。Package.json - 一种 Node.js 软件包文件,用于指定 writeToCustomMetric.js 的标准安装配置和依赖项。writeToCustomMetric.sh - 一种 Shell 脚本,用于在每个 Compute Engine 实例上连续运行 writeToCustomMetric.js 程序。实例模板是实例组中所有虚拟机的蓝图。自动扩缩通过销毁和创建实例来实现,因此它必须确切地知道如何重建这些实例。该模板定义了机器类型、操作系统映像,最重要的是,还定义了指向 Cloud Storage 存储桶中 startup.sh 脚本的元数据。
在 Cloud 控制台中,点击导航菜单 > Compute Engine > 实例模板。
点击页面顶部的创建实例模板。
将实例模板命名为 autoscaling-instance01。
将位置设置为 Global。
在机器配置部分,选择 E2 作为机器家族,选择 e2-medium 作为机器类型。
向下滚动并点击高级选项。
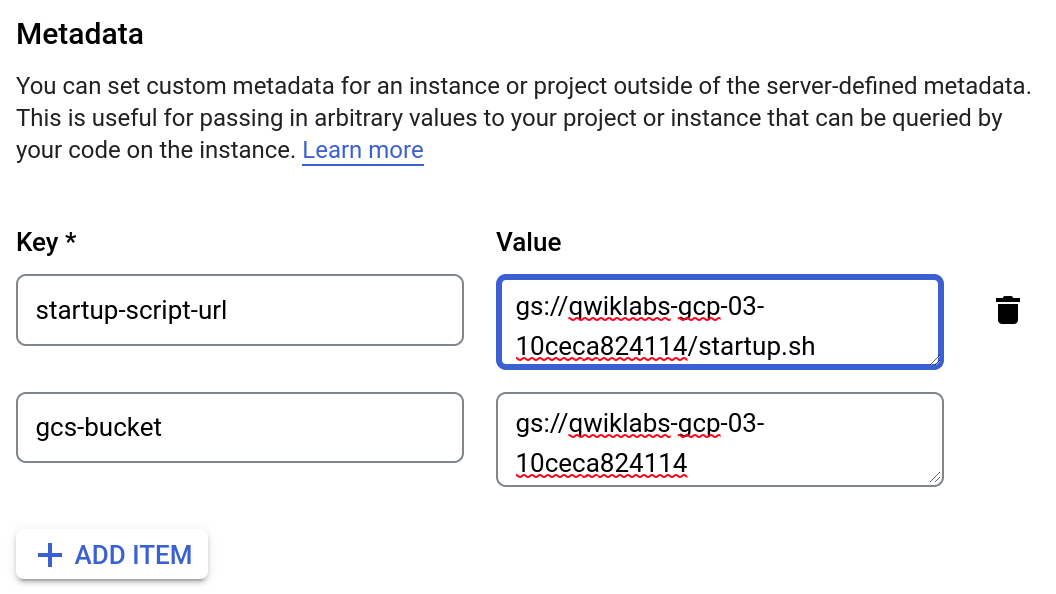
在管理标签页的元数据部分,输入以下元数据键值对,每输入一个请点击一次 + 添加项按钮。记得将 [YOUR_BUCKET_NAME] 占位符替换为存储桶名称:
| 键 | 值 |
|---|---|
| startup-script-url | gs://[YOUR_BUCKET_NAME]/startup.sh |
| gcs-bucket | gs://[YOUR_BUCKET_NAME] |
验证您已完成的任务
点击检查我的进度,验证您已完成的任务。如果您已成功创建实例模板,则会看到一个评估分数。
实例组是虚拟机舰队的容器和控制器。自动扩缩模式最初设置为关闭,以便您控制环境,并确保在启用自动扩缩之前,第一个实例已成功运行自定义指标脚本。
在左侧窗格中,点击实例组。
点击页面顶部的创建实例组。
名称:autoscaling-instance-group-1。
对于实例模板,选择您刚刚创建的实例模板。
对于位置,选择单个可用区,并分别使用
将自动扩缩模式设置为关闭:不自动扩缩。
您将在实例组创建完成后修改自动扩缩设置。将其他设置保留为默认值。
Autoscaling is turned off. The number of instances in the group won't change automatically. The autoscaling configuration is preserved. 警告。验证您已完成的任务
点击检查我的进度,验证您已完成的任务。如果您已成功创建实例组,则会看到一个评估分数。
请耐心等待,直到您刚刚创建的新实例组旁边出现绿色对勾标记。启动脚本可能需要几分钟时间才能完成安装并开始报告值。
您必须确认单个测试实例正在成功运行 writeToCustomMetric.js 脚本,并且数据正常流入 Cloud Monitoring。如果未报告指标数据,自动扩缩器将无法做出回应。若在虚拟机日志中看到 nodeapp: available,则说明此数据流水线已正常运行。
如果耗时超过数分钟,请点击刷新。
在“实例组”窗口中,点击 autoscaling-instance-group-1 的名称,即可查看该组中正在运行的实例。
向下滚动并点击相应实例名称。由于自动扩缩实例组尚未启动其他实例,因此只有一个实例在运行。
在详细信息标签页的日志部分中,点击日志记录链接以查看该虚拟机实例的日志。
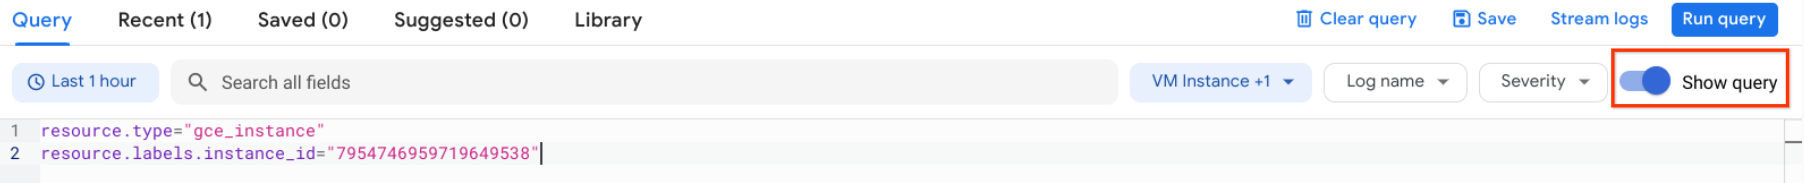
等待 1 到 2 分钟,以便累积一些数据。开启显示查询切换开关,您将在查询预览框中看到 resource.type 和 resource.labels.instance_id。
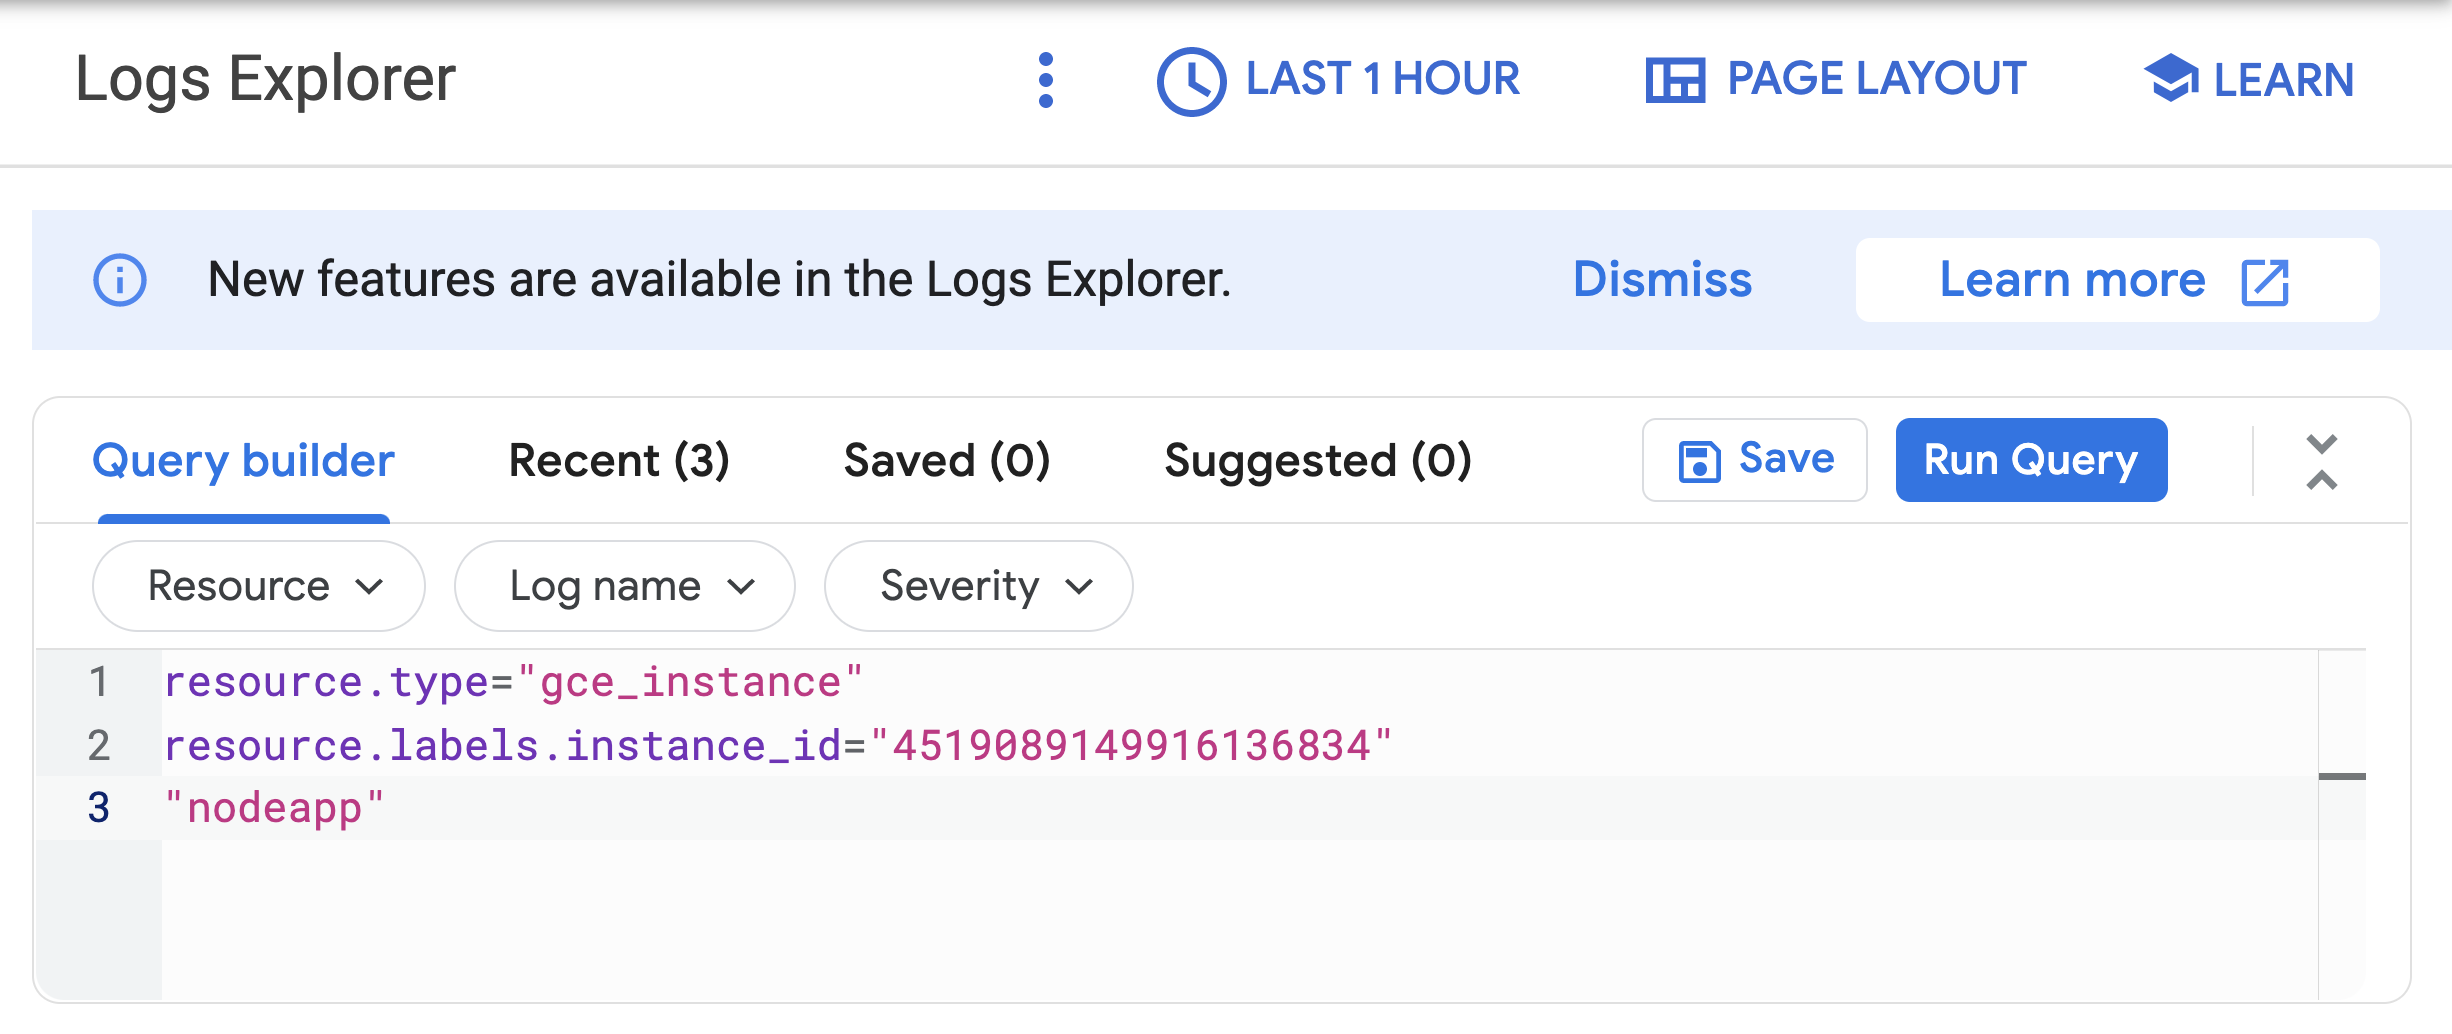
"nodeapp",使代码如下所示:如果 Compute Engine 实例正在执行 Node.js 脚本,系统会向 API 发送一个请求,并显示内容为 nodeapp: available 的日志条目。
在验证自定义指标已成功报告第一个实例中的数据后,即可将实例组配置为根据自定义指标的值自动扩缩。
在 Cloud 控制台中,前往 Compute Engine > 实例组。
点击 autoscaling-instance-group-1 实例组。
点击修改。
在自动扩缩下,将自动扩缩模式设置为开启:在实例组中添加和移除实例。
将实例数下限设置为 1,将实例数上限设置为 3
这定义了成本和性能保证的下限和上限。您至少需要为 1 个实例付费,并且可以保证实例数量不会超过 3 个,从而控制您的费用。
在自动扩缩信号下,点击添加信号以修改指标。设置以下字段,并将其他字段保留为默认值。
Cloud Monitoring metric。点击配置。150
当自定义监控指标值高于或低于目标值时,自动扩缩器会通过增加或减少实例数量来扩缩托管式实例组。目标值可以是任何 double 类型的值,但在本实验中,我们选择了 150,因为它与自定义监控指标报告的值相匹配。
Gauge。点击选择。GAUGE:根据所有实例中指标的当前平均值进行扩缩。(例如:“平均队列深度为 200,超过了 150 的目标值,因此我需要再增加一台机器。”)这适用于队列深度或 CPU 利用率等指标。(相比之下,将目标模式设置为 DELTA_PER_MINUTE 或 DELTA_PER_SECOND 时,系统会根据观察到的变化率而不是平均值自动扩缩。)
点击保存。
验证您已完成的任务
点击检查我的进度,验证您已完成的任务。如果您已成功为实例组配置自动扩缩,则会看到一个评估分数。
Node.js 脚本会随着时间的推移而改变从每个实例报告的自定义指标值。如果指标值上升,实例组将通过添加虚拟机进行扩容。如果该值下降,实例组也会检测到,并通过移除实例进行缩容。该脚本模拟真实指标,其数值也会像真实指标一样上下波动。
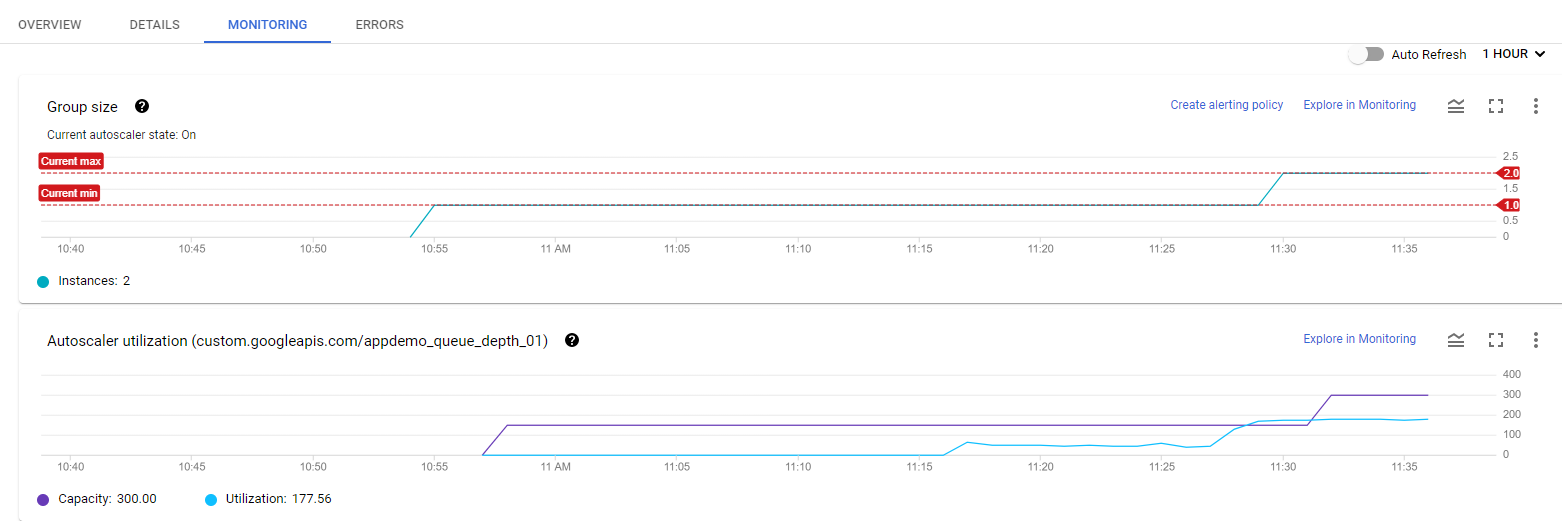
接下来,点击 Monitoring 标签页以查看自动扩缩的实例数图表,观察实例组如何根据指标进行扩缩。
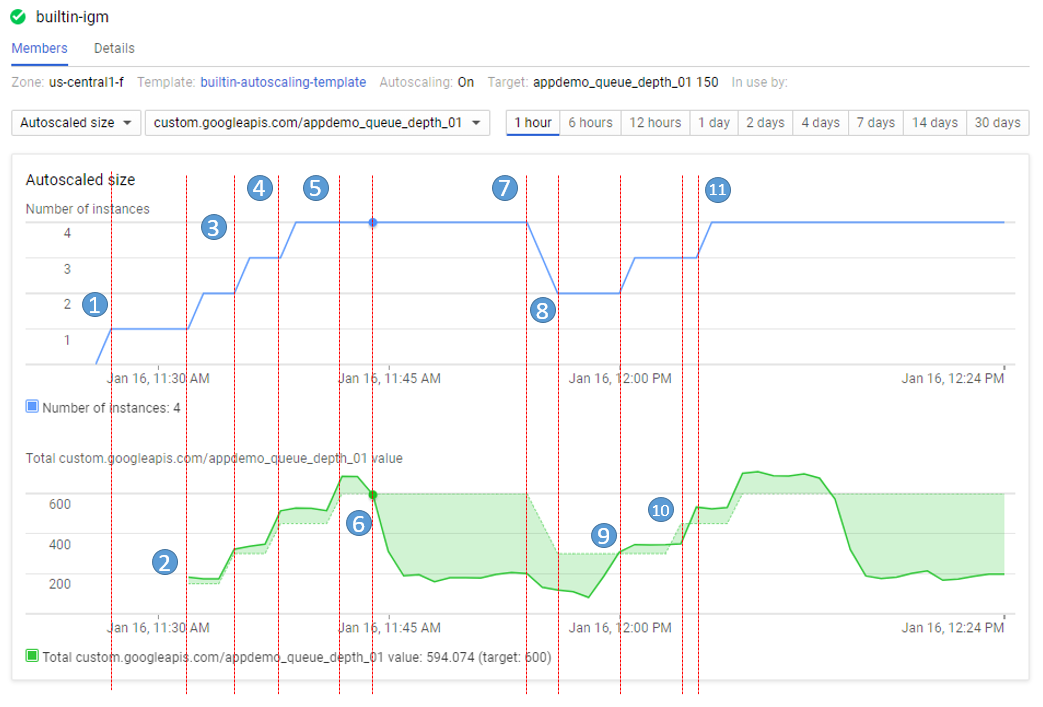
builtin-igm 实例组。由于此实例组已抢先运行,您可以在自动扩缩图表中直接看到该组的自动扩缩详细信息。自动扩缩器大约需要 5 分钟才能正确识别自定义指标,而脚本可能需要长达 10-15 分钟的时间来生成足够的数据,以触发自动扩缩行为。
将鼠标悬停在图表上即可查看更多详细信息。
您可以切换回自己创建的实例组,查看其运行情况(实验剩余时间可能不足,您未必能观察到该实例组的自动扩缩行为)。
在实验剩余时间内,您可以观察自动扩缩图表如何随着实例的添加和移除而波动。
请浏览此自动扩缩示例,了解在规模更大的环境中,容量和自动扩缩的实例数是如何运作的。
上方图表显示的实例数量会随着下方图表报告的自定义指标属性值的汇总水平变化而变化。每个实例启动后,最长会有五分钟的延迟,然后该实例才会开始报告其自定义指标值。在自动扩缩功能启动期间,请浏览此图表,以深入了解即将发生的情况:
脚本首先会生成较大的值(持续约 15 分钟),以触发扩容行为。
恭喜!在本实验中,您创建了一个 Compute Engine 托管式实例组,该实例组会根据自定义 Cloud Monitoring 指标的值自动扩缩。您还学习了如何使用 Cloud 控制台直观呈现自定义指标和实例组大小。
…可帮助您充分利用 Google Cloud 技术。我们的课程会讲解各项技能与最佳实践,可帮助您迅速上手使用并继续学习更深入的知识。我们提供从基础到高级的全方位培训,并有点播、直播和虚拟三种方式选择,让您可以按照自己的日程安排学习时间。各项认证可以帮助您核实并证明您在 Google Cloud 技术方面的技能与专业知识。
本手册最后更新时间:2026 年 5 月 20 日
本实验最后测试时间:2026 年 2 月 25 日
版权所有 2026 Google LLC 保留所有权利。Google 和 Google 徽标是 Google LLC 的商标。其他所有公司名和产品名可能是其各自相关公司的商标。



此内容目前不可用
一旦可用,我们会通过邮件告知您

太好了!
一旦可用,我们会通过邮件联系您


一次一个实验
确认结束所有现有实验并开始此实验