Create the connection resource

检查我的进度

/ 20

Set up access to a Cloud Storage data lake

检查我的进度

/ 30

Create the Lakehouse table

检查我的进度

/ 20

Create the external table

检查我的进度

/ 10

Update external table to Lakehouse table

检查我的进度

/ 20

此实验可能会提供 AI 工具来支持您学习。

GSP1040

Google Cloud 自学实验

概览

Lakehouse 是一个统一存储引擎,通过为多云存储和开放格式提供一致、精细的访问权限控制,可简化数据仓库和数据湖的数据访问。

Lakehouse 将 BigQuery 的精细行级和列级安全性扩展到存储在 Amazon S3、Azure Data Lake Storage Gen2 和 Google Cloud Storage 等数据驻留对象存储区中的表。通过委托访问权限,Lakehouse 将对表的访问权限与对底层云存储数据的访问权限分离开来。此功能可让您安全地向组织中的用户和流水线授予行级和列级访问权限,而无需向其提供对表的完整访问权限。

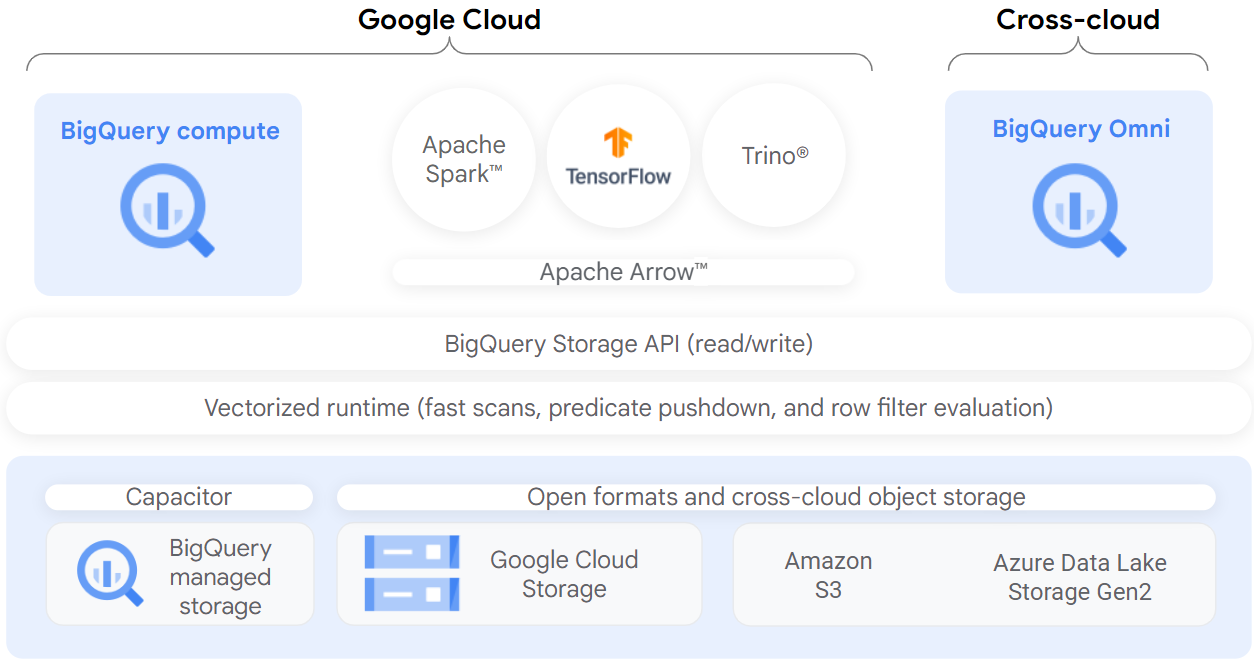
创建 Lakehouse 表后,您可以像查询其他 BigQuery 表一样对其进行查询。BigQuery 会强制执行行级和列级访问权限控制,并且每个用户只能看到他们有权查看的数据切片。所有通过 BigQuery API 进行的数据访问都会受到治理政策的约束。例如,BigQuery Storage API 允许用户使用 Apache Spark 等开源查询引擎访问已获授权的数据,如下图所示:

Lakehouse 概览图

目标

在本实验中,您将执行以下操作:

  • 创建和查看连接资源。
  • 设置对 Cloud Storage 数据湖的访问权限。
  • 创建 Lakehouse 表。
  • 通过 BigQuery 查询 Lakehouse 表。
  • 设置访问权限控制政策。
  • 将外部表升级为 Lakehouse 表。

设置和要求

点击“开始实验”按钮前的注意事项

请阅读以下说明。实验是计时的,并且您无法暂停实验。计时器在您点击开始实验后即开始计时,显示 Google Cloud 资源可供您使用多长时间。

此实操实验可让您在真实的云环境中开展实验活动,免受模拟或演示环境的局限。为此,我们会向您提供新的临时凭据,您可以在该实验的规定时间内通过此凭据登录和访问 Google Cloud。

为完成此实验,您需要:

  • 能够使用标准的互联网浏览器(建议使用 Chrome 浏览器)。
注意:请使用无痕模式(推荐)或无痕浏览器窗口运行此实验。这可以避免您的个人账号与学生账号之间发生冲突,这种冲突可能导致您的个人账号产生额外费用。
  • 完成实验的时间 - 请注意,实验开始后无法暂停。
注意:请仅使用学生账号完成本实验。如果您使用其他 Google Cloud 账号,则可能会向该账号收取费用。

如何开始实验并登录 Google Cloud 控制台

  1. 点击开始实验按钮。如果该实验需要付费,系统会打开一个对话框供您选择支付方式。右侧是实验设置和访问权限面板,其中包含以下内容:

    • 打开 Google Cloud 控制台按钮
    • 您在本实验中必须使用的临时凭证(用户名和密码)
    • 帮助您逐步完成该实验所需的其他信息(如果需要)

    请注意,实验计时器位于页面顶部附近,将显示剩余时间。

  2. 点击打开 Google Cloud 控制台(如果您使用的是 Chrome 浏览器,请右键点击并选择在无痕式窗口中打开链接)。

    该实验会启动资源并打开另一个标签页,显示“登录”页面。

    提示:可以将这些标签页分别放在不同的窗口中,并排显示。

    注意:如果您看见选择账号对话框,请点击使用其他账号
  3. 如有必要,请复制下方的用户名,然后将其粘贴到登录对话框中。

    {{{user_0.username | "<用户名>"}}}

    您也可以在实验设置和访问权限面板中找到“用户名”。

  4. 点击下一步

  5. 复制下面的密码,然后将其粘贴到欢迎对话框中。

    {{{user_0.password | "<密码>"}}}

    您也可以在实验设置和访问权限面板中找到“密码”。

  6. 点击下一步

    重要提示:您必须使用实验提供的凭证。请勿使用您的 Google Cloud 账号凭证。 注意:在本实验中使用您自己的 Google Cloud 账号可能会产生额外费用。
  7. 依次点击进入后续页面:

    • 接受条款及条件。
    • 由于这是临时账号,请勿添加账号恢复选项或双重身份验证。
    • 请勿注册免费试用。

片刻之后,系统会在此标签页中打开 Google Cloud 控制台。

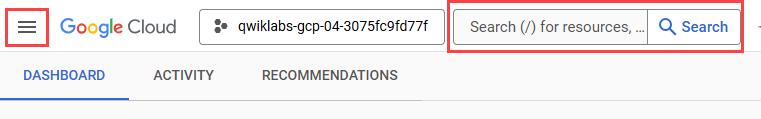
注意:如需访问 Google Cloud 产品和服务,请点击导航菜单,或在搜索字段中输入服务或产品的名称。 “导航菜单”图标和“搜索”字段

激活 Cloud Shell

Cloud Shell 是一种装有开发者工具的虚拟机。它提供了一个永久性的 5GB 主目录,并且在 Google Cloud 上运行。Cloud Shell 提供可用于访问您的 Google Cloud 资源的命令行工具。

  1. 点击 Google Cloud 控制台顶部的激活 Cloud Shell “激活 Cloud Shell”图标

  2. 在弹出的窗口中执行以下操作:

    • 继续完成 Cloud Shell 信息窗口中的设置。
    • 授权 Cloud Shell 使用您的凭据进行 Google Cloud API 调用。

如果您连接成功,即表示您已通过身份验证,且项目 ID 会被设为您的 Project_ID 。输出内容中有一行说明了此会话的 Project_ID

Your Cloud Platform project in this session is set to {{{project_0.project_id | "PROJECT_ID"}}}

gcloud 是 Google Cloud 的命令行工具。它已预先安装在 Cloud Shell 上,且支持 Tab 自动补全功能。

  1. (可选)您可以通过此命令列出活跃账号名称:
gcloud auth list
  1. 点击授权

输出:

ACTIVE: * ACCOUNT: {{{user_0.username | "ACCOUNT"}}} To set the active account, run: $ gcloud config set account `ACCOUNT`
  1. (可选)您可以通过此命令列出项目 ID:
gcloud config list project

输出:

[core] project = {{{project_0.project_id | "PROJECT_ID"}}} 注意:如需查看在 Google Cloud 中使用 gcloud 的完整文档,请参阅 gcloud CLI 概览指南

任务 1. 创建连接资源

Lakehouse 表使用连接资源来访问 Google Cloud Storage 数据。连接资源可以与项目中的单个表或任意一组表相关联。

  1. 在导航菜单中,前往 BigQuery > Studio。点击完成

  2. 要创建连接,请切换到探索器标签页,接着点击 + 添加数据。然后,在数据源搜索栏中搜索 Agent Platform。点击搜索结果中的 Agent Platform

  3. 在“就地访问外部数据”部分,选择 BigQuery 联合

  4. 在“连接类型”列表中,选择 Agent Platform 远程模型、远程函数、Lakehouse 和 Spanner(Cloud 资源)

  5. 在“连接 ID”字段中,输入 my-connection

  6. 对于“位置类型”,请选择多区域,然后从下拉菜单中选择美国(美国的多个区域)

  7. 点击创建连接

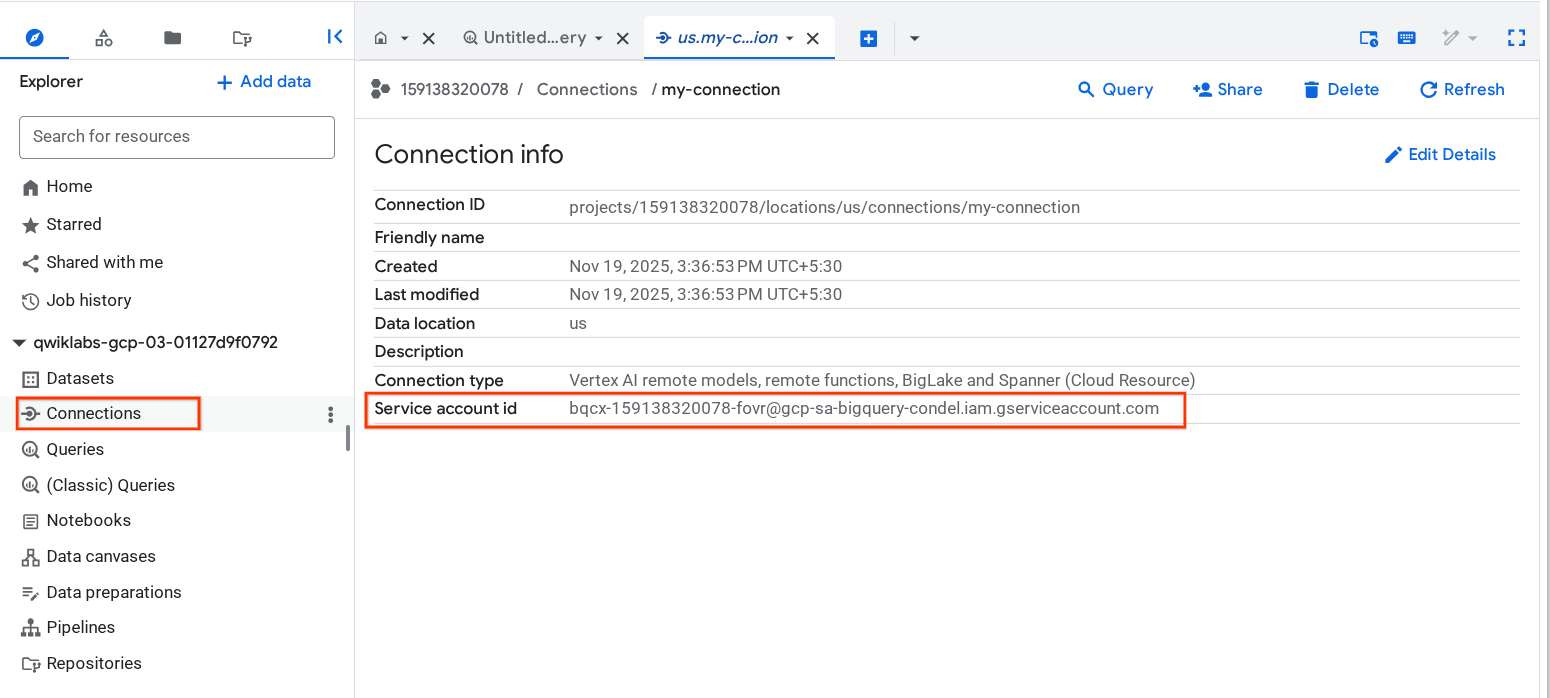
  8. 如需查看连接信息,请在导航菜单中选择该连接。

“我的连接”探索器

  1. 连接信息部分,复制服务账号 ID。下一部分中将会用到此 ID。

点击“检查我的进度”以验证是否完成了以下目标: 创建连接资源

任务 2. 设置对 Cloud Storage 数据湖的访问权限

在本部分,您将向新的连接资源授予对 Cloud Storage 数据湖的只读权限,以便 BigQuery 能够代表用户访问 Cloud Storage 文件。我们建议您向连接资源服务账号授予 Storage Object Viewer IAM 角色,以便该服务账号访问 Cloud Storage 存储桶。

  1. 在导航菜单中,前往 IAM 和管理 > IAM

  2. 点击 + 授予访问权限

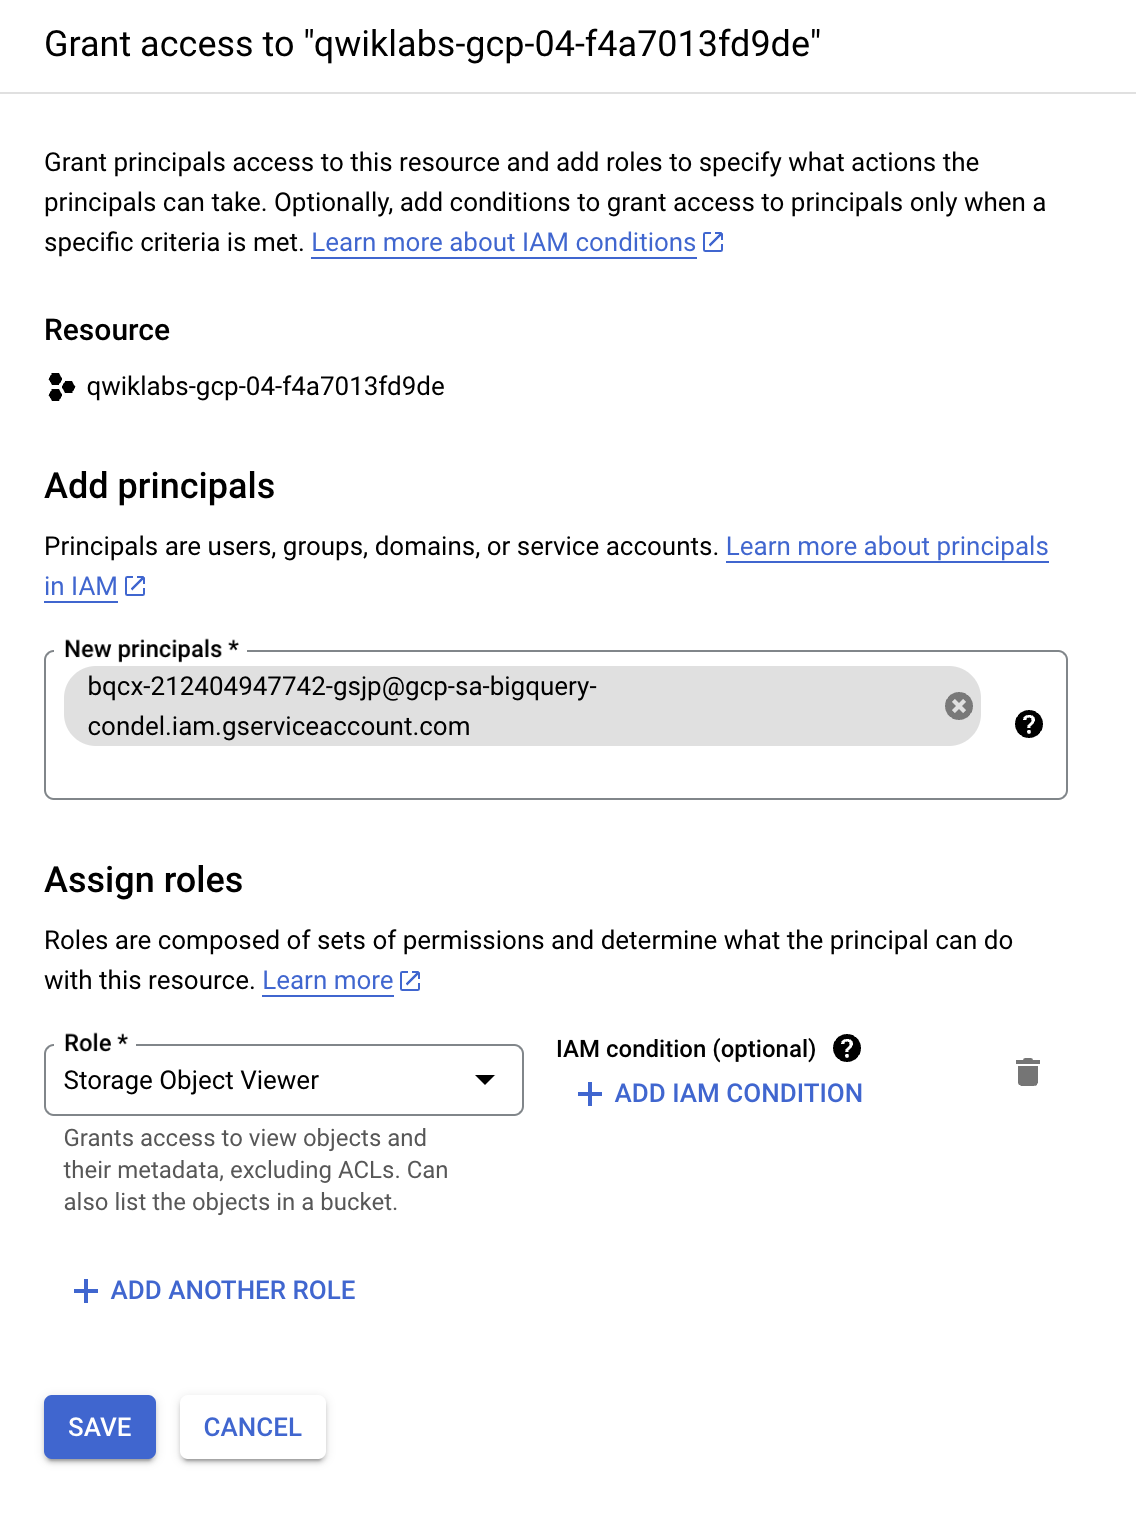
  3. 新的主账号字段中,输入您之前复制的服务账号 ID。

  4. 选择角色字段中,选择 Cloud Storage,然后选择 Storage Object Viewer

添加主账号对话框

  1. 点击保存
注意:将用户迁移到 Lakehouse 表后,请取消现有用户对 Cloud Storage 的直接访问权限。直接文件访问权限能够让用户绕过对 Lakehouse 表设置的治理政策(例如行级和列级安全性)。

点击“检查我的进度”以验证是否完成了以下目标: 设置对 Cloud Storage 数据湖的访问权限

任务 3. 创建 Lakehouse 表

以下示例使用 CSV 文件格式,但您也可以使用 Lakehouse 支持的任何格式,具体请参阅限制。如果您熟悉如何在 BigQuery 中创建表,则此过程与之类似。唯一的区别是您需要指定关联的 Cloud 资源连接。

注意:为了获得最佳性能,我们建议使用 Cloud Storage 单区域或双区域存储桶,而不是多区域存储桶。

如果未提供架构,且服务账号在上一步中未被授予对存储桶的访问权限,则此步骤将失败并显示“访问被拒绝”消息。

创建数据集

  1. 返回到 BigQuery > Studio

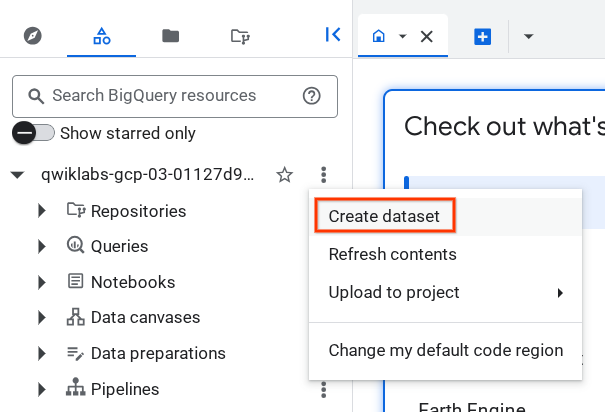
  2. 切换到传统版探索器,然后点击项目名称旁边的三点图标,然后选择创建数据集

创建数据集

  1. 对于数据集 ID,请输入 demo_dataset

  2. 对于“位置类型”,请选择多区域,然后从下拉菜单中选择美国(美国的多个区域)

  3. 将其余字段保留默认值,然后点击创建数据集

    现在您已经创建了一个数据集,下面就可以将 Cloud Storage 中的现有数据集复制到 BigQuery。

创建表

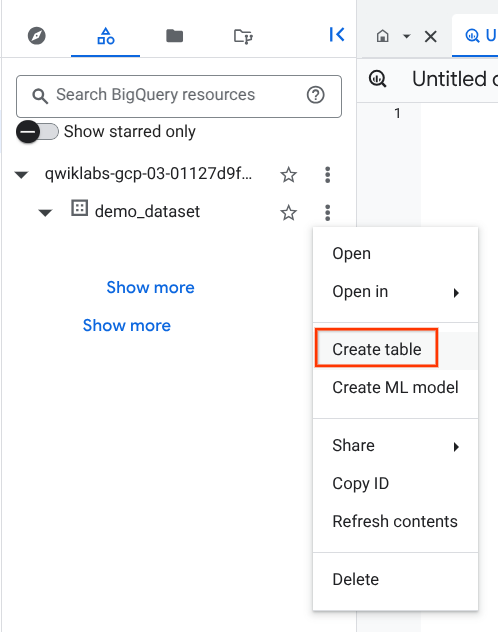
  1. 点击 demo_dataset 旁边的三点图标,然后选择创建表

create-table-1

  1. 基于以下数据源创建表部分,从下拉菜单中选择 Google Cloud Storage
注意:本实验已预先创建了一个 Cloud Storage 存储桶,其中包含两个可供您使用的数据集。
  1. 点击浏览来选择数据集。找到名为 的存储桶,并点击要导入到 BigQuery 的 customer.csv 文件,然后点击选择

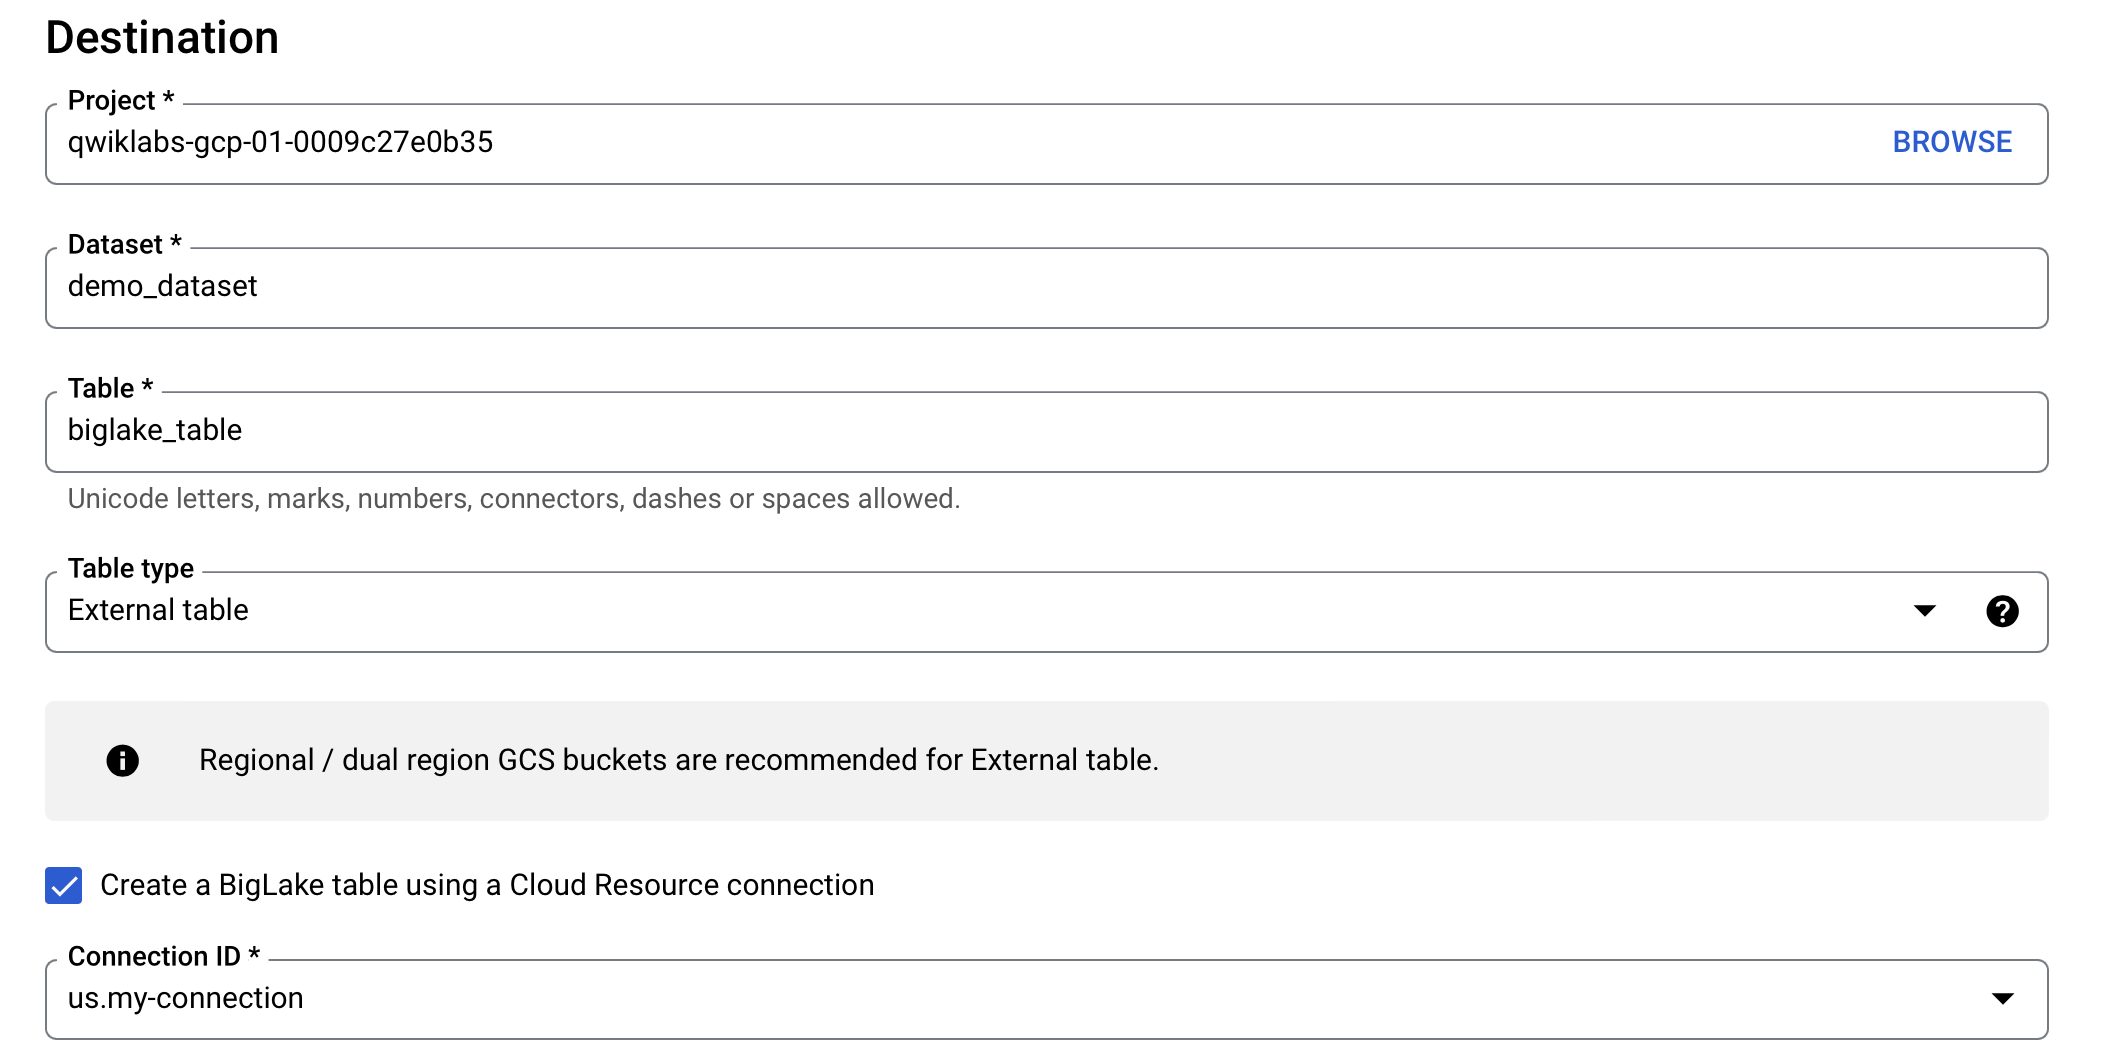
  2. 目标位置部分,请确认已选中您的实验项目,并且正在使用 demo_dataset

  3. 在“表名”部分,输入 biglake_table

  4. 将表类型设置为外部表

  5. 勾选使用 Cloud 资源连接创建 Lakehouse 表

    确认已选择连接 ID us.my-connection。您的配置应如下所示:

目标表

  1. 架构部分,启用以文本形式修改,并将以下架构复制并粘贴到文本框中:
[ { "name": "customer_id", "type": "INTEGER", "mode": "REQUIRED" }, { "name": "first_name", "type": "STRING", "mode": "REQUIRED" }, { "name": "last_name", "type": "STRING", "mode": "REQUIRED" }, { "name": "company", "type": "STRING", "mode": "NULLABLE" }, { "name": "address", "type": "STRING", "mode": "NULLABLE" }, { "name": "city", "type": "STRING", "mode": "NULLABLE" }, { "name": "state", "type": "STRING", "mode": "NULLABLE" }, { "name": "country", "type": "STRING", "mode": "NULLABLE" }, { "name": "postal_code", "type": "STRING", "mode": "NULLABLE" }, { "name": "phone", "type": "STRING", "mode": "NULLABLE" }, { "name": "fax", "type": "STRING", "mode": "NULLABLE" }, { "name": "email", "type": "STRING", "mode": "REQUIRED" }, { "name": "support_rep_id", "type": "INTEGER", "mode": "NULLABLE" } ] 注意:数据湖通常没有预定义架构。但在本实验中,为了更清晰地展示如何设置列级政策,我们使用了一个预定义架构。
  1. 点击创建表

点击“检查我的进度”以验证是否完成了以下目标: 创建 Lakehouse 表

任务 4. 通过 BigQuery 查询 Lakehouse 表

现在您已经创建了 Lakehouse 表,接下来就可以使用任何 BigQuery 客户端提交查询了。

  1. 点击 demo_dataset 中的 biglake_table

  2. biglake_table 预览工具栏中,点击查询

  3. 运行以下命令,通过 BigQuery 编辑器查询 Lakehouse 表:

SELECT * FROM `{{{project_0.project_id|Project ID}}}.demo_dataset.biglake_table`
  1. 点击运行

  2. 确认您可以查看结果表中的所有列和数据。

任务 5. 设置访问权限控制政策

Lakehouse 表创建完成后,其管理方式与 BigQuery 表类似。如需为 Lakehouse 表创建访问权限控制政策,您首先需要在 BigQuery 中创建政策标记分类。然后,将政策标记应用于敏感行或列。在本部分,您将创建一个列级政策。如需了解如何设置行级安全性,请参阅行级安全性指南

为了满足上述目的,本实验中已为您创建了一个名为 的 BigQuery 分类,以及与其相关联的政策标记 biglake-policy

为列添加政策标记

现在,您将使用所创建的政策标记来限制对 BigQuery 表中某些列的访问。在本例中,您将限制对地址、邮政编码和电话号码等敏感信息的访问。

  1. 在导航菜单中,前往 BigQuery > Studio

  2. 依次选择 demo-dataset > biglake_table,然后点击该表来打开表架构页。

  3. 点击修改架构

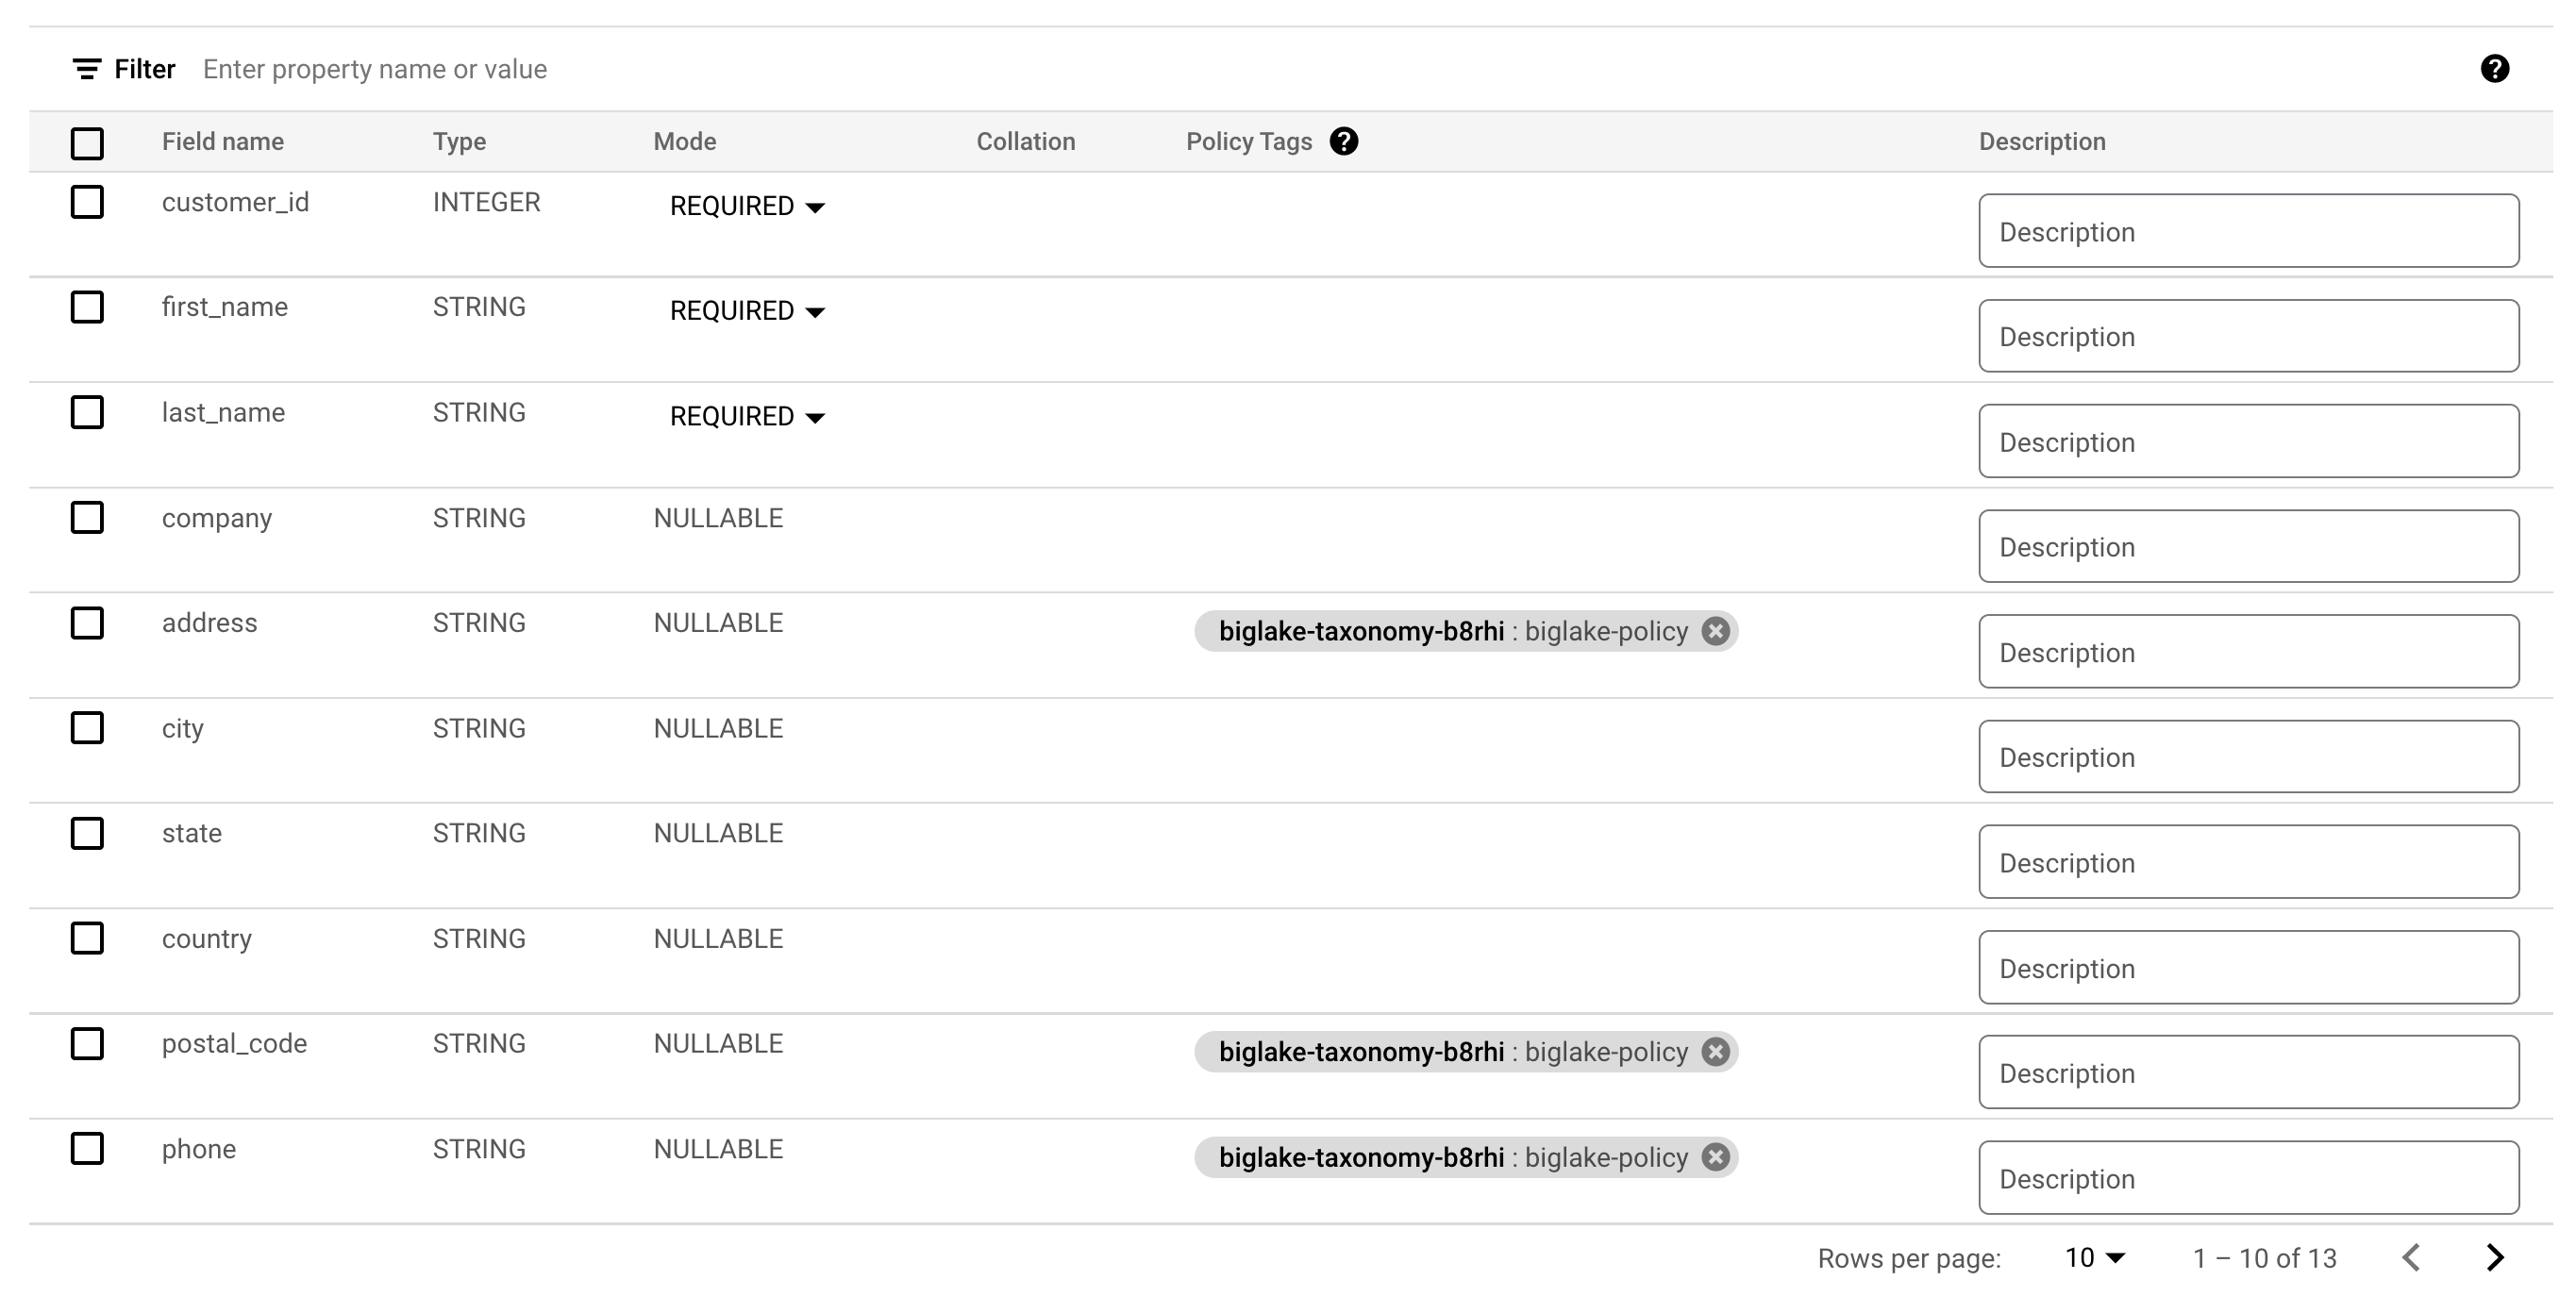
  4. 勾选 addresspostal_codephone 字段旁边的复选框。

  5. 点击添加政策标记

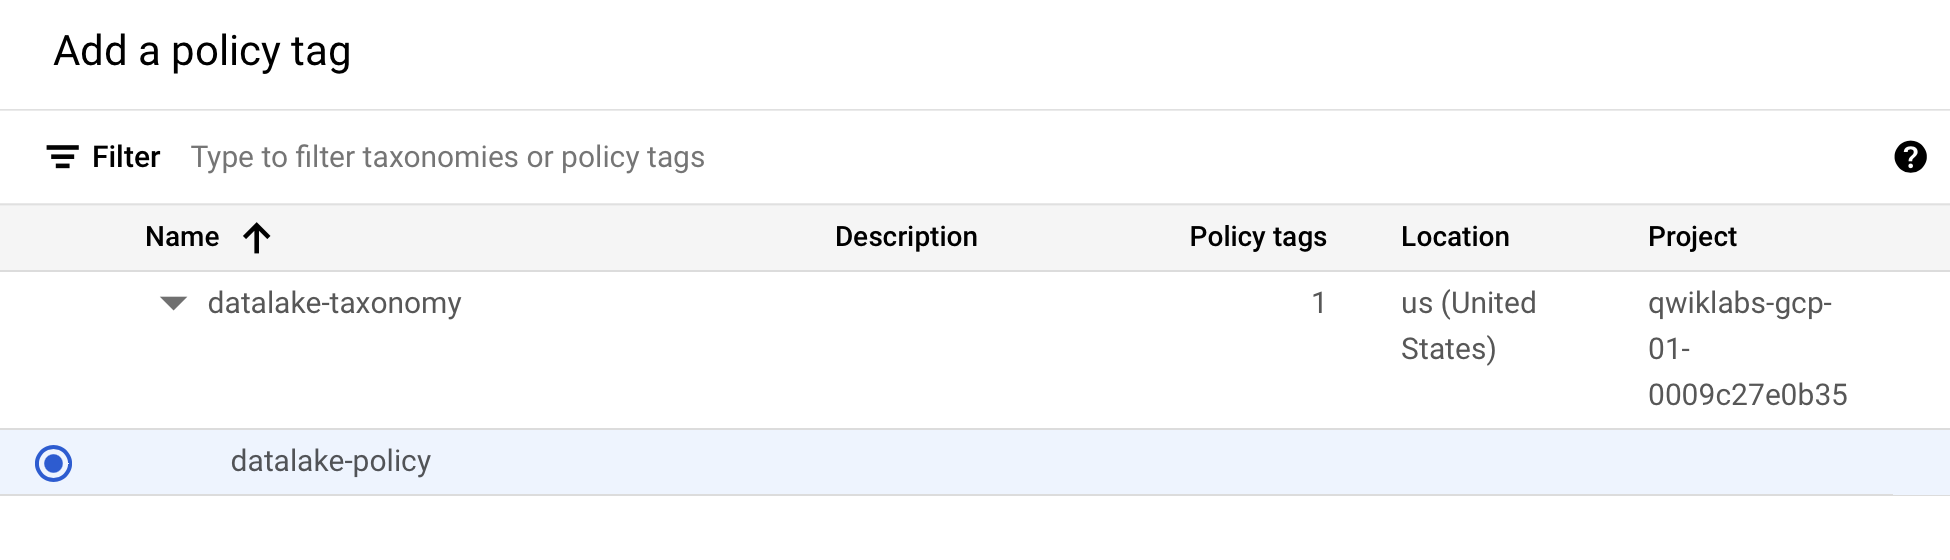
  6. 点击 将其展开,然后选择 biglake-policy

为列添加政策标记

  1. 点击选择

    现在,这些列应该已附加了政策标记。

已附加政策标记

  1. 点击保存

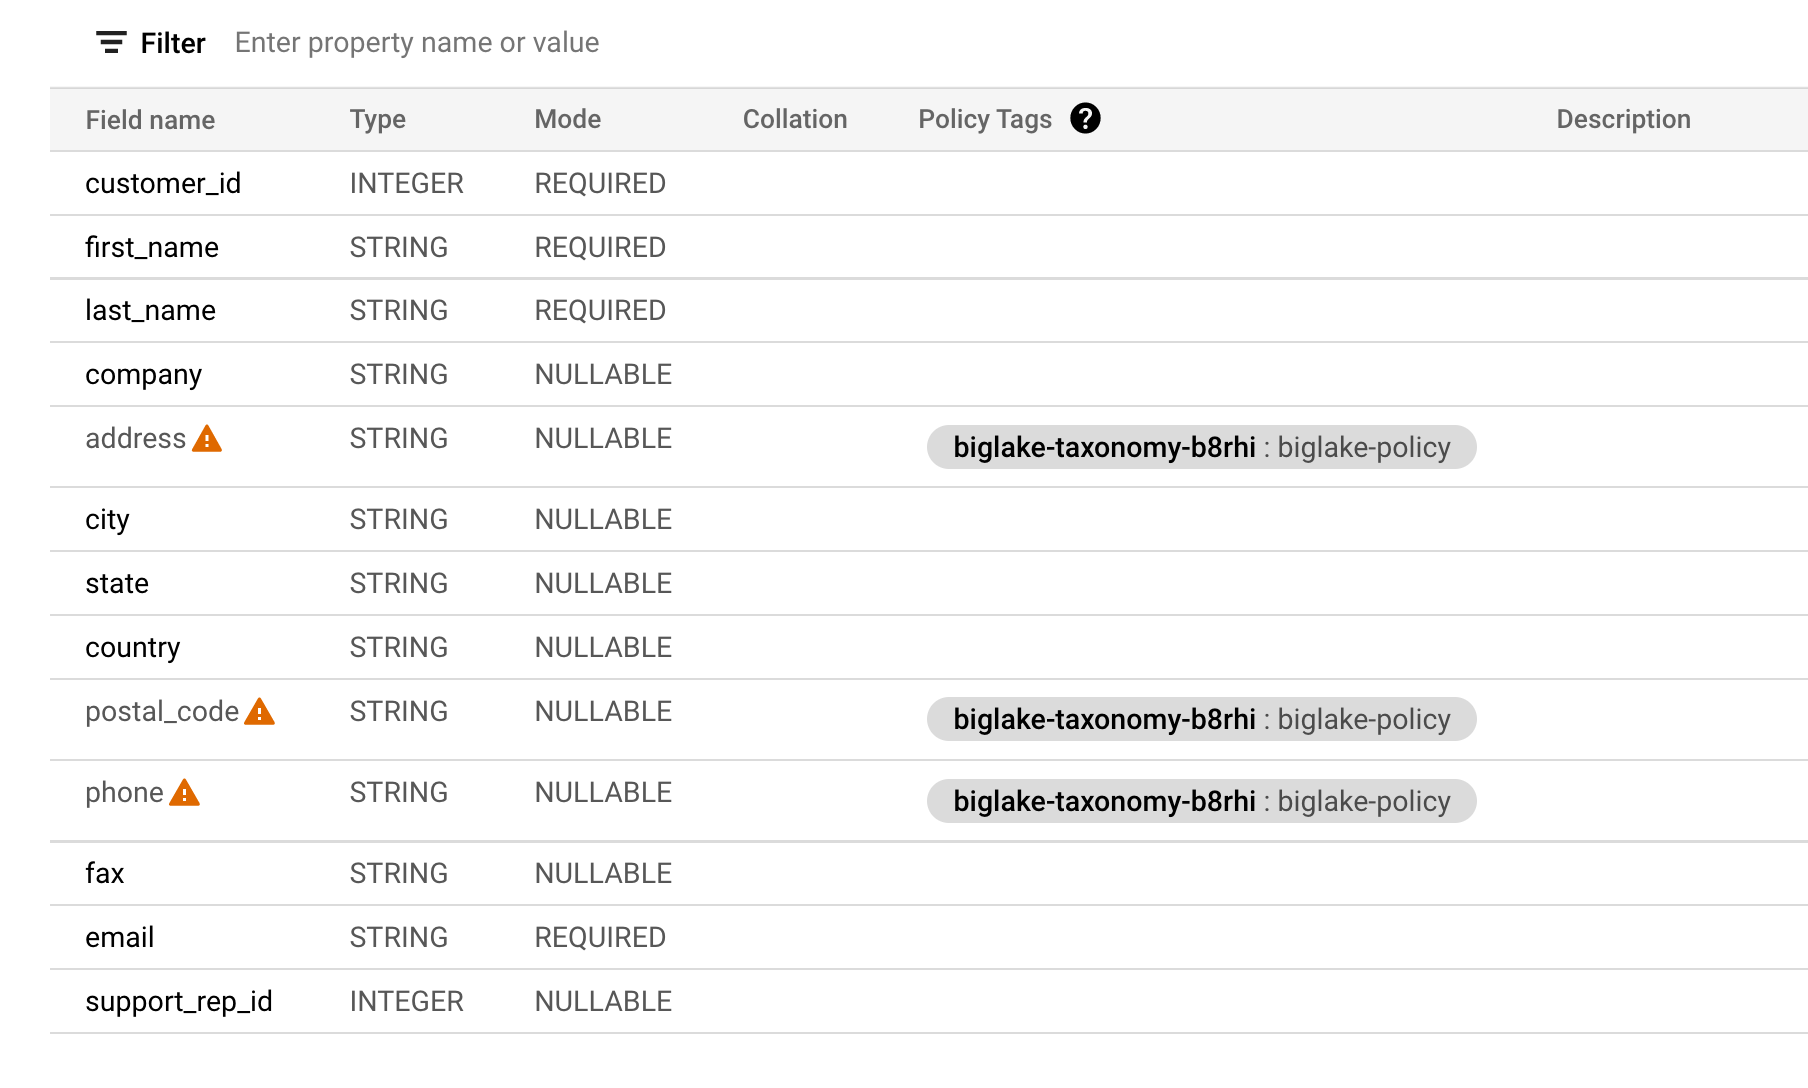
  2. 确认您的表架构现在如下所示。

更新后的表架构

注意:列上的警告图标表示根据现行的安全政策,您无权访问这些特定字段。

验证列级安全性

  1. 打开 biglake_table 的查询编辑器。

  2. 运行以下命令,通过 BigQuery 编辑器查询 Lakehouse 表:

SELECT * FROM `{{{project_0.project_id|Project ID}}}.demo_dataset.biglake_table`
  1. 点击运行

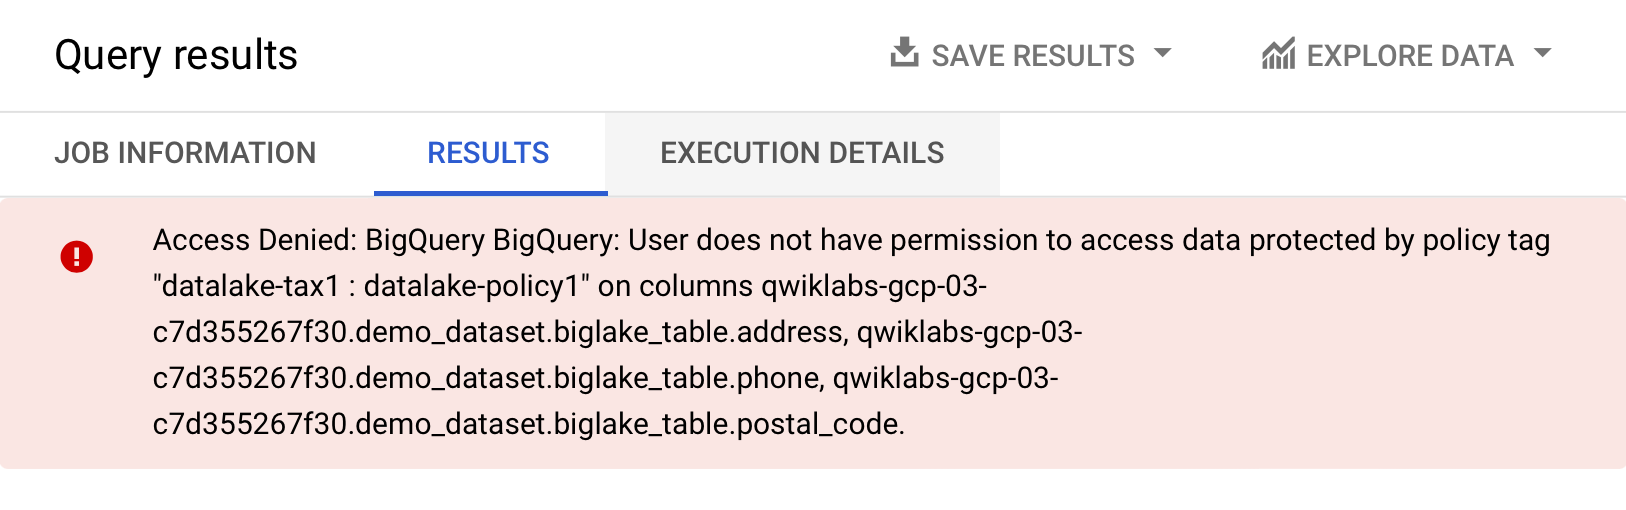
    您应该会收到访问被拒绝的错误消息:

“访问被拒绝”错误

  1. 现在,运行以下查询,并排除您无权访问的列:
SELECT * EXCEPT(address, phone, postal_code) FROM `{{{project_0.project_id|Project ID}}}.demo_dataset.biglake_table`

该查询应能正常运行且不报错,并返回您有权访问的列。本例表明,通过 BigQuery 强制执行的列级安全性同样适用于 Lakehouse 表。

任务 6. 将外部表升级为 Lakehouse 表

通过将现有表与 Cloud 资源连接相关联,您可以将其升级为 Lakehouse 表。如需查看标志和参数的完整列表,请参阅 bq updatebq mkdef

创建外部表

  1. 点击 demo_dataset 旁边的三点图标,然后选择创建表

  2. 基于以下数据源创建表部分,从下拉菜单中选择 Google Cloud Storage

  3. 点击浏览来选择数据集。找到名为 的存储桶和要导入到 BigQuery 的文件 invoice.csv,然后点击选择

  4. 目标位置部分,请确认已选中您的实验项目,并且正在使用 demo_dataset

  5. 在“表名”部分,输入 external_table

  6. 将表类型设置为外部表

注意:请暂时不要指定 Cloud 资源连接。
  1. 架构部分,启用以文本形式修改,并将以下架构复制并粘贴到文本框中:
[ { "name": "invoice_id", "type": "INTEGER", "mode": "REQUIRED" }, { "name": "customer_id", "type": "INTEGER", "mode": "REQUIRED" }, { "name": "invoice_date", "type": "TIMESTAMP", "mode": "REQUIRED" }, { "name": "billing_address", "type": "STRING", "mode": "NULLABLE" }, { "name": "billing_city", "type": "STRING", "mode": "NULLABLE" }, { "name": "billing_state", "type": "STRING", "mode": "NULLABLE" }, { "name": "billing_country", "type": "STRING", "mode": "NULLABLE" }, { "name": "billing_postal_code", "type": "STRING", "mode": "NULLABLE" }, { "name": "total", "type": "NUMERIC", "mode": "REQUIRED" } ]
  1. 点击创建表

点击“检查我的进度”以验证是否完成了以下目标: 创建外部表

将外部表更新为 Lakehouse 表

  1. 打开一个新的 Cloud Shell 窗口,运行以下命令来生成新的外部表定义,以指定要使用的连接:
export PROJECT_ID=$(gcloud config get-value project) bq mkdef \ --autodetect \ --connection_id=$PROJECT_ID.US.my-connection \ --source_format=CSV \ "gs://$PROJECT_ID/invoice.csv" > /tmp/tabledef.json
  1. 确认已创建表定义:
cat /tmp/tabledef.json
  1. 从表中获取架构:
bq show --schema --format=prettyjson demo_dataset.external_table > /tmp/schema
  1. 使用新的外部表定义更新表:
bq update --external_table_definition=/tmp/tabledef.json --schema=/tmp/schema demo_dataset.external_table

点击“检查我的进度”以验证是否完成了以下目标: 将外部表更新为 Lakehouse 表

验证更新后的表

  1. 在导航菜单中,前往 BigQuery > Studio

  2. 选择 demo-dataset 并点击 external_table

  3. 打开详情标签页。

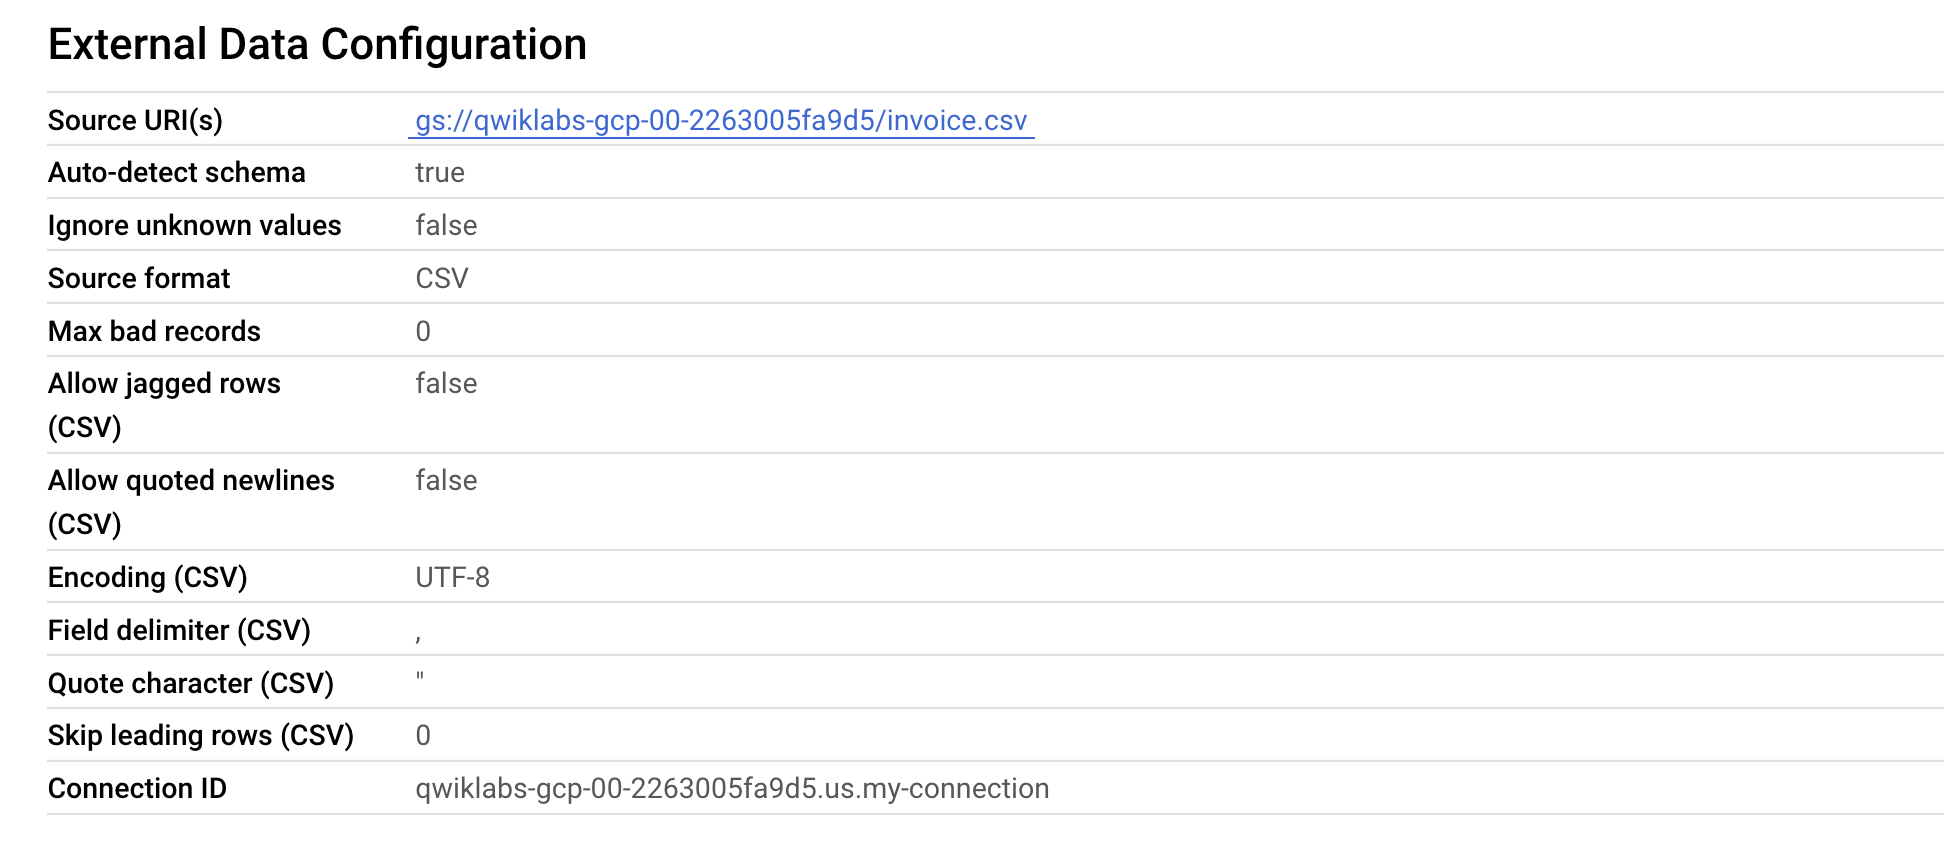
  4. 在“外部数据配置”下,确认该表目前使用了正确的连接 ID。

外部数据配置

太棒了!您已通过将现有的外部表与 Cloud 资源连接相关联,成功将其升级为 Lakehouse 表。

恭喜!

在本实验中,您创建了连接资源,设置了对 Cloud Storage 数据湖的访问权限,并基于该数据湖创建了一个 Lakehouse 表。接着,您通过 BigQuery 查询了 Lakehouse 表,并设置了列级访问权限控制政策。最后,您使用连接资源将现有的外部表更新为了 Lakehouse 表。

后续步骤/了解详情

请务必参阅以下文档,进一步练习使用 Lakehouse:

Google Cloud 培训和认证

…可帮助您充分利用 Google Cloud 技术。我们的课程会讲解各项技能与最佳实践,可帮助您迅速上手使用并继续学习更深入的知识。我们提供从基础到高级的全方位培训,并有点播、直播和虚拟三种方式选择,让您可以按照自己的日程安排学习时间。各项认证可以帮助您核实并证明您在 Google Cloud 技术方面的技能与专业知识。

本手册最后更新时间:2026 年 8 月 10 日

本实验最后测试时间:2026 年 8 月 10 日

版权所有 2026 Google LLC 保留所有权利。Google 和 Google 徽标是 Google LLC 的商标。其他所有公司名和产品名可能是其各自相关公司的商标。

准备工作

  1. 实验会创建一个 Google Cloud 项目和一些资源,供您使用限定的一段时间
  2. 实验有时间限制,并且没有暂停功能。如果您中途结束实验,则必须重新开始。
  3. 在屏幕左上角,点击开始实验即可开始

使用无痕浏览模式

  1. 复制系统为实验提供的用户名密码
  2. 在无痕浏览模式下,点击打开控制台

登录控制台

  1. 使用您的实验凭证登录。使用其他凭证可能会导致错误或产生费用。
  2. 接受条款,并跳过恢复资源页面
  3. 除非您已完成此实验或想要重新开始,否则请勿点击结束实验,因为点击后系统会清除您的工作并移除该项目

此内容目前不可用

一旦可用,我们会通过电子邮件告知您

太好了!

一旦可用,我们会通过电子邮件告知您
一次一个实验

确认结束所有现有实验并开始此实验

使用无痕浏览模式运行实验

使用无痕模式或无痕浏览器窗口是运行此实验的最佳方式。这可以避免您的个人账号与学生账号之间发生冲突,这种冲突可能导致您的个人账号产生额外费用。