GSP290

Ringkasan
Dataflow adalah
layanan Google Cloud yang menyediakan pemrosesan data batch dan streaming
terpadu dalam skala besar. Layanan ini dibuat di project Apache Beam, yang
merupakan model open source untuk menentukan pipeline pemrosesan paralel data
batch dan streaming. Dengan menggunakan salah satu Apache Beam SDK open
source, Anda dapat membangun program yang menentukan pipeline, lalu
menggunakan Dataflow untuk menjalankan pipeline.
Di lab ini, Anda akan menggunakan Apache Beam SDK untuk Python guna membangun
dan menjalankan pipeline di Dataflow untuk menyerap data dari Cloud Storage ke
BigQuery, lalu mengubah dan memperkaya data di BigQuery.
Catatan: Pastikan untuk membuka file Python dan membaca komentarnya saat diminta. Hal ini akan memberikan pemahaman tentang hal yang dilakukan kode tersebut.
Yang akan Anda lakukan
Di lab ini, Anda akan mempelajari cara membangun dan menjalankan pipeline
Dataflow (Python) untuk melakukan tugas berikut:
- Menyerap data dari Cloud Storage ke BigQuery.
- Mentransformasi dan memperkaya data di BigQuery.
- Menggabungkan data di BigQuery dan menulis hasilnya ke tabel baru.
Penyiapan dan persyaratan
Sebelum mengklik tombol Start Lab
Baca petunjuk ini. Lab memiliki timer dan Anda tidak dapat menjedanya. Timer yang dimulai saat Anda mengklik Start Lab akan menampilkan durasi ketersediaan resource Google Cloud untuk Anda.
Lab interaktif ini dapat Anda gunakan untuk melakukan aktivitas lab di lingkungan cloud sungguhan, bukan di lingkungan demo atau simulasi. Untuk mengakses lab ini, Anda akan diberi kredensial baru yang bersifat sementara dan dapat digunakan untuk login serta mengakses Google Cloud selama durasi lab.
Untuk menyelesaikan lab ini, Anda memerlukan:
- Akses ke browser internet standar (disarankan browser Chrome).
Catatan: Gunakan jendela Samaran (direkomendasikan) atau browser pribadi untuk menjalankan lab ini. Hal ini akan mencegah konflik antara akun pribadi Anda dan akun siswa yang dapat menyebabkan tagihan ekstra pada akun pribadi Anda.
- Waktu untuk menyelesaikan lab. Ingat, setelah dimulai, lab tidak dapat dijeda.
Catatan: Hanya gunakan akun siswa untuk lab ini. Jika Anda menggunakan akun Google Cloud yang berbeda, Anda mungkin akan dikenai tagihan ke akun tersebut.
Cara memulai lab dan login ke Konsol Google Cloud
-
Klik tombol Start Lab. Jika Anda perlu membayar lab, dialog akan terbuka untuk memilih metode pembayaran.
Di sebelah kanan terdapat panel Lab setup and access yang berisi hal-hal berikut:
- Tombol Open Google Cloud console
- Kredensial sementara (nama pengguna dan sandi) yang harus Anda gunakan untuk lab ini
- Informasi lain, jika diperlukan, untuk menyelesaikan lab ini
Perhatikan bahwa timer lab terletak di dekat bagian atas halaman, yang menampilkan waktu yang tersisa.
-
Klik Open Google Cloud console (atau klik kanan dan pilih Open Link in Incognito Window jika Anda menjalankan browser Chrome).
Lab akan menjalankan resource, lalu membuka tab lain yang menampilkan halaman Sign in.
Tips: Atur tab di jendela terpisah secara berdampingan.
Catatan: Jika Anda melihat dialog Choose an account, klik Use Another Account.
-
Jika perlu, salin Username di bawah dan tempel ke dialog Sign in.
{{{user_0.username | "Username"}}}
Anda juga dapat menemukan Username di panel Lab setup and access.
-
Klik Next.
-
Salin Password di bawah dan tempel ke dialog Welcome.
{{{user_0.password | "Password"}}}
Anda juga dapat menemukan Password di panel Lab setup and access.
-
Klik Next.
Penting: Anda harus menggunakan kredensial yang diberikan lab. Jangan menggunakan kredensial akun Google Cloud Anda.
Catatan: Penggunaan akun Google Cloud sendiri untuk lab ini mungkin dikenai biaya tambahan.
-
Klik untuk melanjutkan ke halaman berikutnya:
- Setujui persyaratan dan ketentuan.
- Jangan tambahkan opsi pemulihan atau autentikasi 2 langkah (karena ini akun sementara).
- Jangan daftar uji coba gratis.
Setelah beberapa saat, Konsol Google Cloud akan terbuka di tab ini.
Catatan: Untuk mengakses produk dan layanan Google Cloud, klik Navigation menu atau ketik nama layanan atau produk di kolom Search.

Mengaktifkan Cloud Shell
Cloud Shell adalah mesin virtual yang dilengkapi dengan berbagai alat pengembangan. Mesin virtual ini menawarkan direktori beranda persisten berkapasitas 5 GB dan berjalan di Google Cloud. Cloud Shell menyediakan akses command-line untuk resource Google Cloud Anda.
-
Klik Activate Cloud Shell  di bagian atas Konsol Google Cloud.
-
Klik jendela berikut:
- Lanjutkan melalui jendela informasi Cloud Shell.
- Beri otorisasi ke Cloud Shell untuk menggunakan kredensial Anda guna melakukan panggilan Google Cloud API.
Setelah terhubung, Anda sudah diautentikasi, dan project ditetapkan ke Project_ID, . Output berisi baris yang mendeklarasikan Project_ID untuk sesi ini:
Project Cloud Platform Anda dalam sesi ini disetel ke {{{project_0.project_id | "PROJECT_ID"}}}
gcloud adalah alat command line untuk Google Cloud. Alat ini sudah terinstal di Cloud Shell dan mendukung pelengkapan command line.
- (Opsional) Anda dapat menampilkan daftar nama akun yang aktif dengan perintah ini:
gcloud auth list
- Klik Authorize.
Output:
ACTIVE: *
ACCOUNT: {{{user_0.username | "ACCOUNT"}}}
Untuk menetapkan akun aktif, jalankan:
$ gcloud config set account `ACCOUNT`
- (Opsional) Anda dapat menampilkan daftar ID project dengan perintah ini:
gcloud config list project
Output:
[core]
project = {{{project_0.project_id | "PROJECT_ID"}}}
Catatan: Untuk mendapatkan dokumentasi gcloud yang lengkap di Google Cloud, baca panduan ringkasan gcloud CLI.
Tugas 1. Memastikan Dataflow API berhasil diaktifkan
gcloud services disable dataflow.googleapis.com --project {{{project_0.project_id|Project ID}}} --force
gcloud services enable dataflow.googleapis.com --project {{{project_0.project_id|Project ID}}}
Jika API telah diaktifkan kembali, halaman akan menampilkan opsi
Disable.
Klik Periksa progres saya untuk memverifikasi tugas yang
telah dijalankan.
Menonaktifkan dan mengaktifkan kembali Dataflow API.
Tugas 2. Mendownload kode awal
Download contoh Dataflow Python untuk digunakan di lab ini.
gcloud storage cp -r gs://spls/gsp290/dataflow-python-examples .
Tugas 3. Membuat bucket Cloud Storage dan menyalin file ke bucket
Di Cloud Shell, buat bucket Cloud Storage, lalu salin file ke bucket. File ini
adalah contoh Dataflow Python.
Membuat bucket Cloud Storage
-
Gunakan perintah untuk membuat bucket di Cloud Shell guna membuat bucket
regional baru di region
dalam project Anda:
gcloud storage buckets create gs://{{{ project_0.project_id | BUCKET_NAME }}} --location={{{ project_0.default_region | REGION }}}
Klik Periksa progres saya untuk memverifikasi tugas yang
telah dijalankan.
Membuat Bucket Cloud Storage.
Menyalin file ke bucket Anda
-
Di Cloud Shell, gunakan perintah
gcloud storage untuk menyalin file ke
bucket Cloud Storage yang baru saja Anda buat:
gcloud storage cp gs://spls/gsp290/data_files/usa_names.csv gs://{{{ project_0.project_id | BUCKET_NAME }}}/data_files/
gcloud storage cp gs://spls/gsp290/data_files/head_usa_names.csv gs://{{{ project_0.project_id | BUCKET_NAME }}}/data_files/
Klik Periksa progres saya untuk memverifikasi tugas yang
telah dijalankan.
Menyalin File ke Bucket Anda.
Tugas 4. Membuat set data BigQuery
Buat set data di BigQuery. Di sinilah tabel Anda akan dimuat di BigQuery.
- Di Cloud Shell, buat set data bernama
lake:
bq mk lake
Klik Periksa progres saya untuk memverifikasi tugas yang
telah dijalankan.
Membuat Set Data BigQuery bernama lake.
Tugas 5. Meninjau dan menjalankan pipeline penyerapan data
Dalam tugas ini, Anda akan meninjau kode pipeline untuk melihat cara kerjanya.
Kemudian, Anda akan menyiapkan dan menjalankan pipeline.
Pipeline penyerapan data menyerap data dari Cloud Storage ke tabel BigQuery
menggunakan sumber TextIO dan tujuan BigQueryIO. Secara khusus, tugas pipeline
adalah:
- Menyerap file dari Cloud Storage.
- Memfilter baris header dalam file.
- Mengonversi baris yang dibaca ke objek kamus.
- Menghasilkan output baris ke BigQuery.
Meninjau kode Python untuk pipeline penyerapan data
Gunakan Editor Kode Cloud Shell untuk meninjau kode pipeline.
-
Di panel menu Cloud Shell, klik Open Editor.
-
Buka dataflow_python_examples > dataflow_python_examples, lalu buka file data_ingestion.py.
-
Baca komentar dalam file yang menjelaskan hal yang dilakukan kode tersebut.
Kode ini akan mengisi tabel BigQuery dengan file data dari Cloud Storage.
- Untuk kembali ke Cloud Shell, klik Open Terminal.
Menyiapkan container Docker untuk tugas Dataflow
Di bagian ini, Anda akan kembali ke sesi Cloud Shell untuk menyiapkan library
Python yang diperlukan.
Tugas Dataflow di lab ini memerlukan Python3.8. Untuk memastikan
kesesuaian versi, jalankan proses Dataflow di container Docker Python 3.8.
-
Jalankan perintah berikut di Cloud Shell untuk memulai container Python:
cd ~
docker run -it -e PROJECT={{{ project_0.project_id | PROJECT_ID }}} -v $(pwd)/dataflow-python-examples:/dataflow python:3.8 /bin/bash
Perintah ini akan mengambil container Docker dengan versi stabil terbaru
Python 3.8 dan mengeksekusi shell perintah untuk menjalankan perintah
berikutnya dalam container. Flag -v menyediakan kode sumber
sebagai volume untuk container sehingga memungkinkan kita
melakukan pengeditan di editor Cloud Shell sambil tetap mengaksesnya dalam
container yang sedang berjalan.
-
Setelah selesai mengambil container dan mulai menjalankannya di Cloud Shell,
jalankan perintah berikut untuk menginstal
apache-beam pada
container yang sedang berjalan tersebut:
pip install apache-beam[gcp]==2.59.0
-
Selanjutnya, di container yang sedang berjalan di Cloud Shell, ubah
direktori ke lokasi tempat Anda menautkan kode sumber:
cd dataflow/
Menjalankan pipeline penyerapan data di cloud
- Jalankan kode berikut untuk menjalankan pipeline penyerapan data:
python dataflow_python_examples/data_ingestion.py \
--project={{{ project_0.project_id | PROJECT_ID }}} \
--region={{{ project_0.default_region | REGION }}} \
--runner=DataflowRunner \
--machine_type=e2-standard-2 \
--staging_location=gs://{{{ project_0.project_id | BUCKET_NAME }}}/test \
--temp_location gs://{{{ project_0.project_id | BUCKET_NAME }}}/test \
--input gs://{{{ project_0.project_id | BUCKET_NAME }}}/data_files/head_usa_names.csv \
--save_main_session
Kode ini akan menjalankan worker yang diperlukan, lalu menghentikannya setelah
pipeline selesai.
-
Di kolom judul konsol, ketik Dataflow di kolom
Search, lalu klik Dataflow di hasil
penelusuran.
Saat halaman Dataflow terbuka, lihat status tugas Anda.
- Klik nama tugas tersebut untuk melihat progresnya.
Setelah Job Status Anda berstatus Succeeded,
Anda dapat melanjutkan proses ke langkah berikutnya. Pipeline penyerapan ini
memerlukan waktu sekitar lima menit untuk memulai, menyelesaikan tugas, dan
melakukan penghentian.
-
Buka BigQuery (Navigation menu > BigQuery) untuk melihat
bahwa data Anda telah diisi.
-
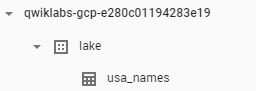
Klik nama project untuk melihat tabel usa_names di bagian
set data lake.
-
Klik tabel, lalu buka tab Preview untuk melihat contoh data
usa_names.
Catatan: Jika Anda tidak melihat tabel usa_names, coba refresh halaman atau lihat tabel menggunakan UI BigQuery klasik.
Klik Periksa progres saya untuk memverifikasi tugas yang
telah dijalankan.
Membangun pipeline penyerapan data.
Tugas 6. Meninjau dan menjalankan pipeline transformasi data
Dalam tugas ini, Anda akan meninjau pipeline transformasi data untuk
mempelajari cara kerjanya. Kemudian, Anda akan menjalankan pipeline untuk
memproses file Cloud Storage dan menampilkan hasilnya ke BigQuery.
Pipeline transformasi data juga menyerap data dari Cloud Storage ke tabel
BigQuery menggunakan sumber TextIO dan tujuan BigQueryIO, tetapi dengan
transformasi data tambahan. Secara khusus, tugas pipeline adalah:
- Menyerap file dari Cloud Storage.
- Mengonversi baris yang dibaca ke objek kamus.
-
Mengubah data yang berisi tahun menjadi format yang dipahami BigQuery
sebagai tanggal.
- Menghasilkan output baris ke BigQuery.
Menjalankan pipeline penyerapan data di cloud
- Jalankan kode berikut untuk menjalankan pipeline penyerapan data:
python dataflow_python_examples/data_ingestion.py \
--project={{{ project_0.project_id | PROJECT_ID }}} \
--region={{{ project_0.default_region | REGION }}} \
--runner=DataflowRunner \
--machine_type=e2-standard-2 \
--staging_location=gs://{{{ project_0.project_id | BUCKET_NAME }}}/test \
--temp_location gs://{{{ project_0.project_id | BUCKET_NAME }}}/test \
--input gs://{{{ project_0.project_id | BUCKET_NAME }}}/data_files/head_usa_names.csv \
--save_main_session
Kode ini akan menjalankan worker yang diperlukan, lalu menghentikannya setelah
pipeline selesai.
-
Di kolom judul konsol, ketik Dataflow di kolom
Search, lalu klik Dataflow di hasil
penelusuran.
Saat halaman Dataflow terbuka, lihat status tugas Anda.
- Klik nama tugas tersebut untuk melihat progresnya.
Setelah Job Status Anda berstatus Succeeded,
Anda dapat melanjutkan proses ke langkah berikutnya. Pipeline penyerapan ini
memerlukan waktu sekitar lima menit untuk memulai, menyelesaikan tugas, dan
melakukan penghentian.
-
Buka BigQuery (Navigation menu > BigQuery) untuk melihat
bahwa data Anda telah diisi.
-
Klik nama project untuk melihat tabel usa_names di bagian
set data lake.
-
Klik tabel, lalu buka tab Preview untuk melihat contoh data
usa_names.
Catatan: Jika Anda tidak melihat tabel usa_names, coba refresh halaman atau lihat tabel menggunakan UI BigQuery klasik.
Klik Periksa progres saya untuk memverifikasi tugas yang
telah dijalankan.
Membangun pipeline penyerapan data.
Tugas 6. Meninjau dan menjalankan pipeline transformasi data
Dalam tugas ini, Anda akan meninjau pipeline transformasi data untuk
mempelajari cara kerjanya. Kemudian, Anda akan menjalankan pipeline untuk
memproses file Cloud Storage dan menampilkan hasilnya ke BigQuery.
Pipeline transformasi data juga menyerap data dari Cloud Storage ke tabel
BigQuery menggunakan sumber TextIO dan tujuan BigQueryIO, tetapi dengan
transformasi data tambahan. Secara khusus, tugas pipeline adalah:
- Menyerap file dari Cloud Storage.
- Mengonversi baris yang dibaca ke objek kamus.
-
Mengubah data yang berisi tahun menjadi format yang dipahami BigQuery
sebagai tanggal.
- Menghasilkan output baris ke BigQuery.
Meninjau kode Python untuk pipeline transformasi data
- Di Editor Kode, buka
data_transformation.py. Baca komentar dalam file yang menjelaskan hal yang dilakukan kode tersebut.
Menjalankan pipeline transformasi data di cloud
-
Masukkan perintah berikut di Terminal Cloud Shell untuk menjalankan pipeline
transformasi data:
python dataflow_python_examples/data_transformation.py \
--project={{{ project_0.project_id | PROJECT_ID }}} \
--region={{{ project_0.default_region | REGION }}} \
--runner=DataflowRunner \
--machine_type=e2-standard-2 \
--staging_location=gs://{{{ project_0.project_id | BUCKET_NAME }}}/test \
--temp_location gs://{{{ project_0.project_id | BUCKET_NAME }}}/test \
--input gs://{{{ project_0.project_id | BUCKET_NAME }}}/data_files/head_usa_names.csv \
--save_main_session
-
Di kolom judul Konsol Google Cloud, ketik Dataflow di
kolom Search, lalu klik Dataflow dari
hasil penelusuran.
-
Klik nama tugas ini untuk melihat status tugas Anda.
Pipeline Dataflow ini memerlukan waktu sekitar lima menit untuk memulai,
menyelesaikan tugas, dan melakukan penghentian.
-
Setelah Job Status Anda berstatus
Succeeded di layar Dataflow Job Status, buka
BigQuery untuk memeriksa apakah data Anda telah diisi atau
belum.
Anda akan melihat tabel usa_names_transformed di bagian set
data lake.
-
Klik tabel dan buka tab Preview untuk melihat contoh data
usa_names_transformed.
Catatan: Jika Anda tidak melihat tabel usa_names_transformed, coba refresh halaman atau lihat tabel menggunakan UI BigQuery klasik.
Klik Periksa progres saya untuk memverifikasi tugas yang
telah dijalankan.
Membangun pipeline transformasi data.
Tugas 7. Meninjau dan menjalankan pipeline pengayaan data
Sekarang Anda akan membangun pipeline pengayaan data untuk mencapai hal
berikut:
- Menyerap file dari Cloud Storage.
- Memfilter baris header dalam file.
- Mengonversi baris yang dibaca pada objek kamus.
- Menghasilkan output baris ke BigQuery.
Meninjau dan mengedit kode Python untuk pipeline pengayaan data
-
Di Editor Kode, buka data_enrichment.py.
-
Baca komentar yang menjelaskan hal yang dilakukan kode tersebut. Kode ini mengisi data di BigQuery.
Baris 83 saat ini akan terlihat seperti berikut:
values = [x.decode('utf8') for x in csv_row]
- Edit baris tersebut agar terlihat seperti berikut:
values = [x for x in csv_row]
- Setelah selesai mengedit baris ini, jangan lupa untuk Save (menyimpan) file yang telah diupdate ini dengan memilih opsi File di Editor Kode dan mengklik Save.
Menjalankan pipeline pengayaan data
-
Masukkan perintah berikut di Terminal Cloud Shell untuk menjalankan pipeline
pengayaan data:
python dataflow_python_examples/data_enrichment.py \
--project={{{ project_0.project_id | PROJECT_ID }}} \
--region={{{ project_0.default_region | REGION }}} \
--runner=DataflowRunner \
--machine_type=e2-standard-2 \
--staging_location=gs://{{{ project_0.project_id | BUCKET_NAME }}}/test \
--temp_location gs://{{{ project_0.project_id | BUCKET_NAME }}}/test \
--input gs://{{{ project_0.project_id | BUCKET_NAME }}}/data_files/head_usa_names.csv \
--save_main_session
-
Di halaman Dataflow, klik tugas Anda untuk melihat
Job status.
Pipeline Dataflow ini memerlukan waktu sekitar lima menit untuk memulai,
menyelesaikan tugas, dan melakukan penghentian.
-
Setelah Job Status Anda berstatus
Succeed di layar Dataflow Job Status, di
konsol, klik Navigation menu > BigQuery untuk memeriksa
apakah data Anda telah diisi atau belum.
Anda akan melihat tabel usa_names_enriched di bagian set data
lake.
-
Klik tabel dan buka tab Preview untuk melihat contoh data
usa_names_enriched.
Catatan: Jika Anda tidak melihat tabel usa_names_enriched, coba refresh halaman atau lihat tabel menggunakan UI BigQuery klasik.
Klik Periksa progres saya untuk memverifikasi tugas yang
telah dijalankan.
Membangun pipeline pengayaan data.
Tugas 8. Meninjau dan menjalankan pipeline data lake ke data mart
Sekarang, Anda akan membangun pipeline Dataflow yang membaca data dari dua
sumber data BigQuery, lalu menggabungkan keduanya. Secara spesifik, Anda akan:
- Menyerap file dari dua sumber BigQuery.
- Menggabungkan kedua sumber data tersebut.
- Memfilter baris header dalam file.
- Mengonversi baris yang dibaca pada objek kamus.
- Menghasilkan output baris ke BigQuery.
Menjalankan pipeline penyerapan data untuk melakukan penggabungan data dan
menulis tabel yang dihasilkan ke BigQuery
Pertama-tama, Anda akan meninjau kode data_lake_to_mart.py untuk
mendapatkan pemahaman tentang fungsinya. Kemudian, Anda akan menjalankan
pipeline di cloud.
-
Di Editor Kode, buka file
data_lake_to_mart.py.
Baca komentar dalam file yang menjelaskan hal yang dilakukan kode tersebut.
Kode ini menggabungkan dua tabel dan menulis hasilnya ke tabel baru di
BigQuery.
- Jalankan blok kode berikut untuk mengeksekusi pipeline:
python dataflow_python_examples/data_lake_to_mart.py \
--worker_disk_type="compute.googleapis.com/projects//zones//diskTypes/pd-ssd" \
--max_num_workers=4 \
--project={{{ project_0.project_id | PROJECT_ID }}} \
--runner=DataflowRunner \
--machine_type=e2-standard-2 \
--staging_location=gs://{{{ project_0.project_id | BUCKET_NAME }}}/test \
--temp_location gs://{{{ project_0.project_id | BUCKET_NAME }}}/test \
--save_main_session \
--region={{{ project_0.default_region | REGION }}}
-
Di kolom judul Konsol Google Cloud, ketik Dataflow di
kolom Search, lalu klik Dataflow dari
hasil penelusuran.
-
Klik tugas baru ini untuk melihat statusnya.
Pipeline Dataflow ini memerlukan waktu sekitar lima menit untuk memulai,
menyelesaikan tugas, dan melakukan penghentian.
-
Setelah Job Status Anda berstatus
Succeeded di layar Dataflow Job Status, klik
Navigation menu > BigQuery untuk memeriksa apakah data Anda
telah diisi atau belum.
Anda akan melihat tabel orders_denormalized_sideinput di
bagian set data lake.
-
Klik tabel dan buka bagian Preview untuk melihat contoh
data
orders_denormalized_sideinput.
Catatan: Jika Anda tidak melihat tabel orders_denormalized_sideinput, coba refresh halaman atau lihat tabel menggunakan UI BigQuery klasik.
Klik Periksa progres saya untuk memverifikasi tugas yang
telah dijalankan.
Membangun Pipeline Dataflow Data lake ke Data mart
Uji pemahaman Anda
Berikut ini beberapa pertanyaan pilihan ganda untuk memperkuat pemahaman Anda
terhadap konsep lab ini. Jawab pertanyaan tersebut sebaik mungkin.
Selamat!
Anda telah berhasil menjalankan kode Python menggunakan Dataflow untuk menyerap data dari Cloud Storage ke BigQuery,
lalu mengubah dan memperkaya data di BigQuery.
Langkah berikutnya/Pelajari lebih lanjut
Ingin mempelajari lebih lanjut? Baca dokumentasi resmi di:
Sertifikasi dan pelatihan Google Cloud
...membantu Anda mengoptimalkan teknologi Google Cloud. Kelas kami mencakup keterampilan teknis dan praktik terbaik untuk membantu Anda memahami dengan cepat dan melanjutkan proses pembelajaran. Kami menawarkan pelatihan tingkat dasar hingga lanjutan dengan opsi on demand, live, dan virtual untuk menyesuaikan dengan jadwal Anda yang sibuk. Sertifikasi membantu Anda memvalidasi dan membuktikan keterampilan serta keahlian Anda dalam teknologi Google Cloud.
Manual Terakhir Diperbarui pada 1 September 2025
Lab Terakhir Diuji pada 1 September 2025
Hak cipta 2026 Google LLC. Semua hak dilindungi undang-undang. Google dan logo Google adalah merek dagang dari Google LLC. Semua nama perusahaan dan produk lain mungkin adalah merek dagang masing-masing perusahaan yang bersangkutan.








