

始める前に
- ラボでは、Google Cloud プロジェクトとリソースを一定の時間利用します
- ラボには時間制限があり、一時停止機能はありません。ラボを終了した場合は、最初からやり直す必要があります。
- 画面左上の [ラボを開始] をクリックして開始します

Scale Up Hello App
/ 30
Create node pool
/ 30
Managing a Regional Cluster
/ 20
Simulate Traffic
/ 20
Scale Up Hello App
/ 30
Create node pool
/ 30
Managing a Regional Cluster
/ 20
Simulate Traffic
/ 20


Google Kubernetes Engine クラスタの基盤となるインフラストラクチャは、それぞれが Compute VM インスタンスであるノードで構成されます。このラボでは、クラスタのインフラストラクチャを最適化することで費用を抑え、アプリケーションのアーキテクチャをより効率的なものにする方法を説明します。
貴重なインフラストラクチャ リソースを最大限に活用する(そして、リソースが十分に活用されない事態を防ぐ)ために、ワークロードの例に適切な構成のマシンタイプを選択する戦略を学びます。使用するインフラストラクチャの種類だけでなく、インフラストラクチャの物理的な地理的位置も費用に影響します。この演習では、より高可用性のリージョン クラスタを管理するために費用対効果に優れた戦略を立てる方法も確認します。
このラボでは、次の方法について学びます。
こちらの説明をお読みください。ラボには時間制限があり、一時停止することはできません。タイマーは、Google Cloud のリソースを利用できる時間を示しており、[ラボを開始] をクリックするとスタートします。
このハンズオンラボでは、シミュレーションやデモ環境ではなく実際のクラウド環境を使って、ラボのアクティビティを行います。そのため、ラボの受講中に Google Cloud にログインおよびアクセスするための、新しい一時的な認証情報が提供されます。
このラボを完了するためには、下記が必要です。
[ラボを開始] ボタンをクリックします。ラボの料金をお支払いいただく必要がある場合は、表示されるダイアログでお支払い方法を選択してください。 右側の [ラボの設定とアクセス] パネルには、以下が表示されます。
ラボのタイマーはページの上部に表示され、残り時間が示されます。
[Google Cloud コンソールを開く] をクリックします(Chrome ブラウザを使用している場合は、右クリックして [シークレット ウィンドウで開く] を選択します)。
ラボでリソースがスピンアップし、別のタブで [ログイン] ページが表示されます。
ヒント: タブをそれぞれ別のウィンドウで開き、並べて表示しておきましょう。
必要に応じて、下のユーザー名をコピーして、[ログイン] ダイアログに貼り付けます。
[ラボの設定とアクセス] パネルでもユーザー名を確認できます。
[次へ] をクリックします。
以下のパスワードをコピーして、[ようこそ] ダイアログに貼り付けます。
[ラボの設定とアクセス] パネルでもパスワードを確認できます。
[次へ] をクリックします。
その後のページはクリックして先に進みます。
しばらくすると、このタブで Google Cloud コンソールが開きます。

このラボでは、小規模なクラスタを作成して使用します。クラスタのプロビジョニングには、2~5 分程度かかります。
[ラボを開始] ボタンを押した後で、青い文字の「resources being provisioned」というメッセージと、読み込み中であることを意味する円アイコンが表示される場合は、クラスタがまだ作成中です。
この待ち時間の間に次の指示と説明を読み始めても構いませんが、リソースのプロビジョニングが完了するまでシェルコマンドは実行できません。
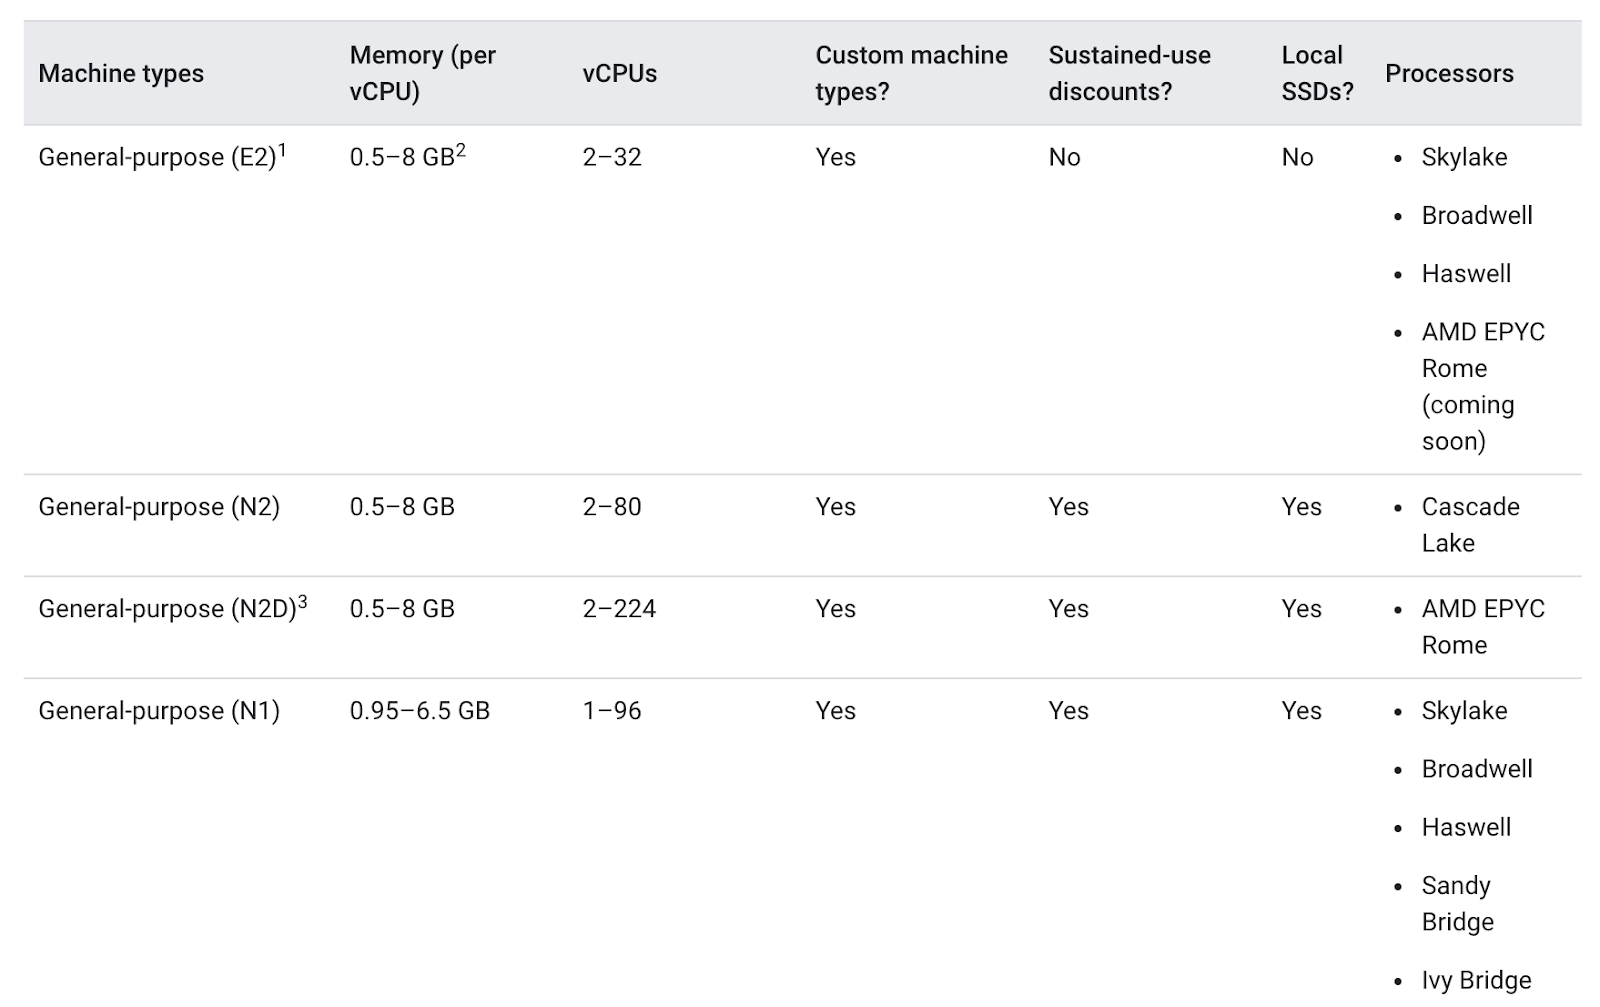
マシンタイプとは、システムメモリ サイズ、仮想 CPU(vCPU)数、永続ディスクの上限など、仮想マシン(VM)インスタンスで使用できる仮想ハードウェア リソースのセットのことです。マシンタイプはさまざまなワークロード向けにファミリー単位で選別され、グループ化されています。
ノードプールのマシンタイプを選択する場合、一般的に、汎用マシンタイプ ファミリーがさまざまなワークロードで優れたコスト パフォーマンスを発揮します。汎用マシンタイプは、N シリーズと E2 シリーズで構成されます。
マシンタイプの違いがアプリにとって有益なこともあれば、そうでないこともあります。一般的に、E2 は N1 と同程度のパフォーマンスを実現しますが、費用を重視して最適化されています。通常は E2 マシンタイプを使用するだけでも、費用を抑えられます。
ただし、クラスタでは、使用されるリソースがアプリケーションのニーズに応じて最適化されることが特に重要です。大幅にスケールする必要がある大規模なアプリケーションや Deployment の場合、ワークロードを多数の汎用マシンに分散するよりも、少数の最適化されたマシンにスタックする方が費用を抑えられることもあります。
この意思決定を行うには、アプリについて細部まで十分に理解している必要があります。アプリに固有の要件がある場合は、それに合わせてマシンタイプを構成できます。
次のセクションでは、デモアプリを確認し、適切な構成のマシンタイプを使用するノードプールにそのアプリを移行します。
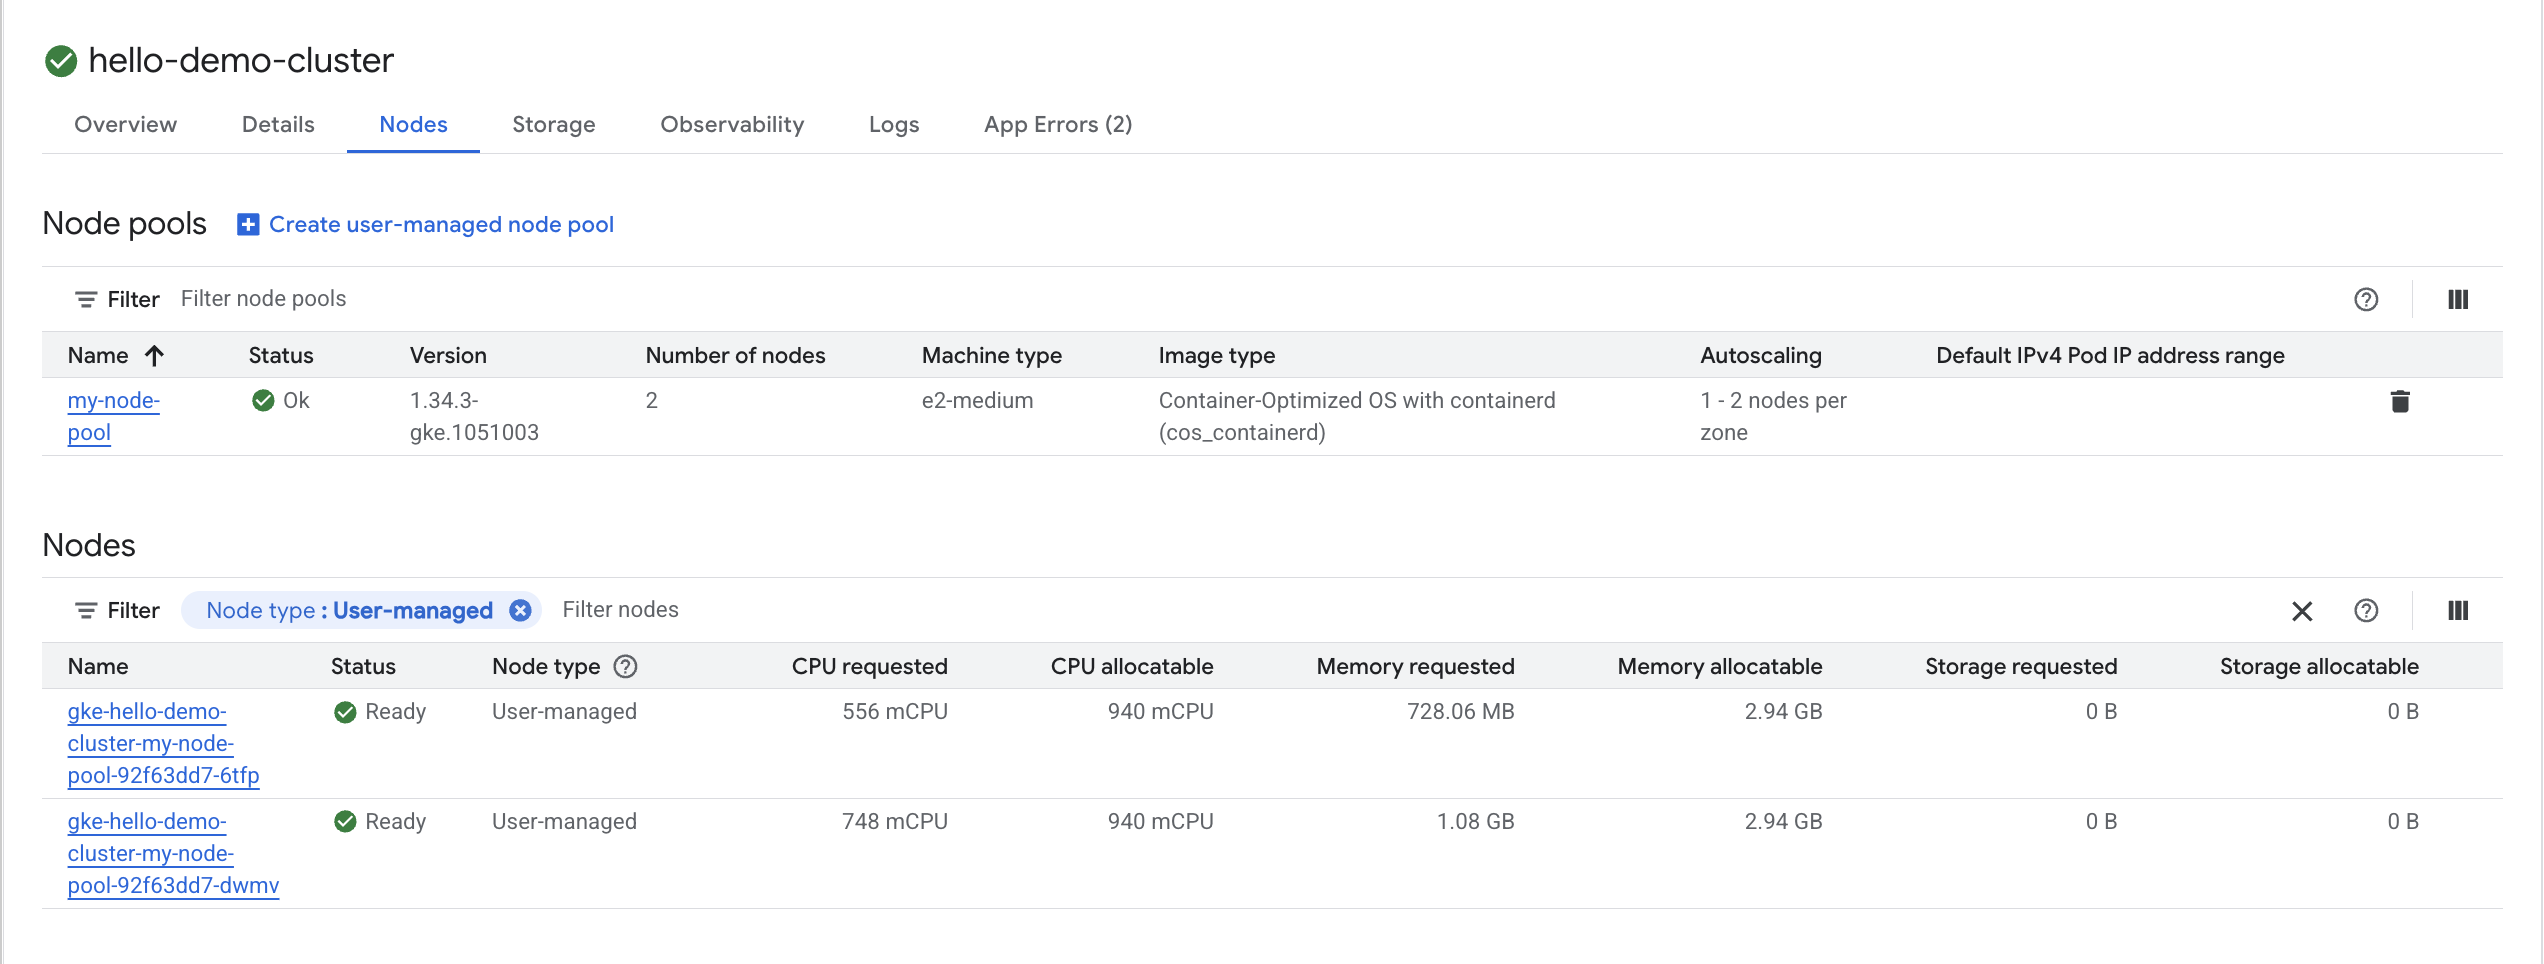
ラボの開始時に 2 つの e2-medium(vCPU × 2、メモリ 4 GB)ノードを使用して Hello デモクラスタが生成されました。このクラスタは、Hello App という簡単なウェブ アプリケーションのレプリカを 1 つデプロイします。これは Go で記述されたウェブサーバーで、すべてのリクエストに「Hello, World!」というメッセージで応答します。
[Kubernetes クラスタ] ウィンドウで、hello-demo-cluster を選択します。
次のウィンドウで、[ノード] タブを選択します。
クラスタのノード一覧が表示されます。
クラスタのリソースが GKE でどのように利用されているかを観察します。各ノードでリクエストされた CPU とメモリの量や、ノードで割り当て可能な容量がわかります。
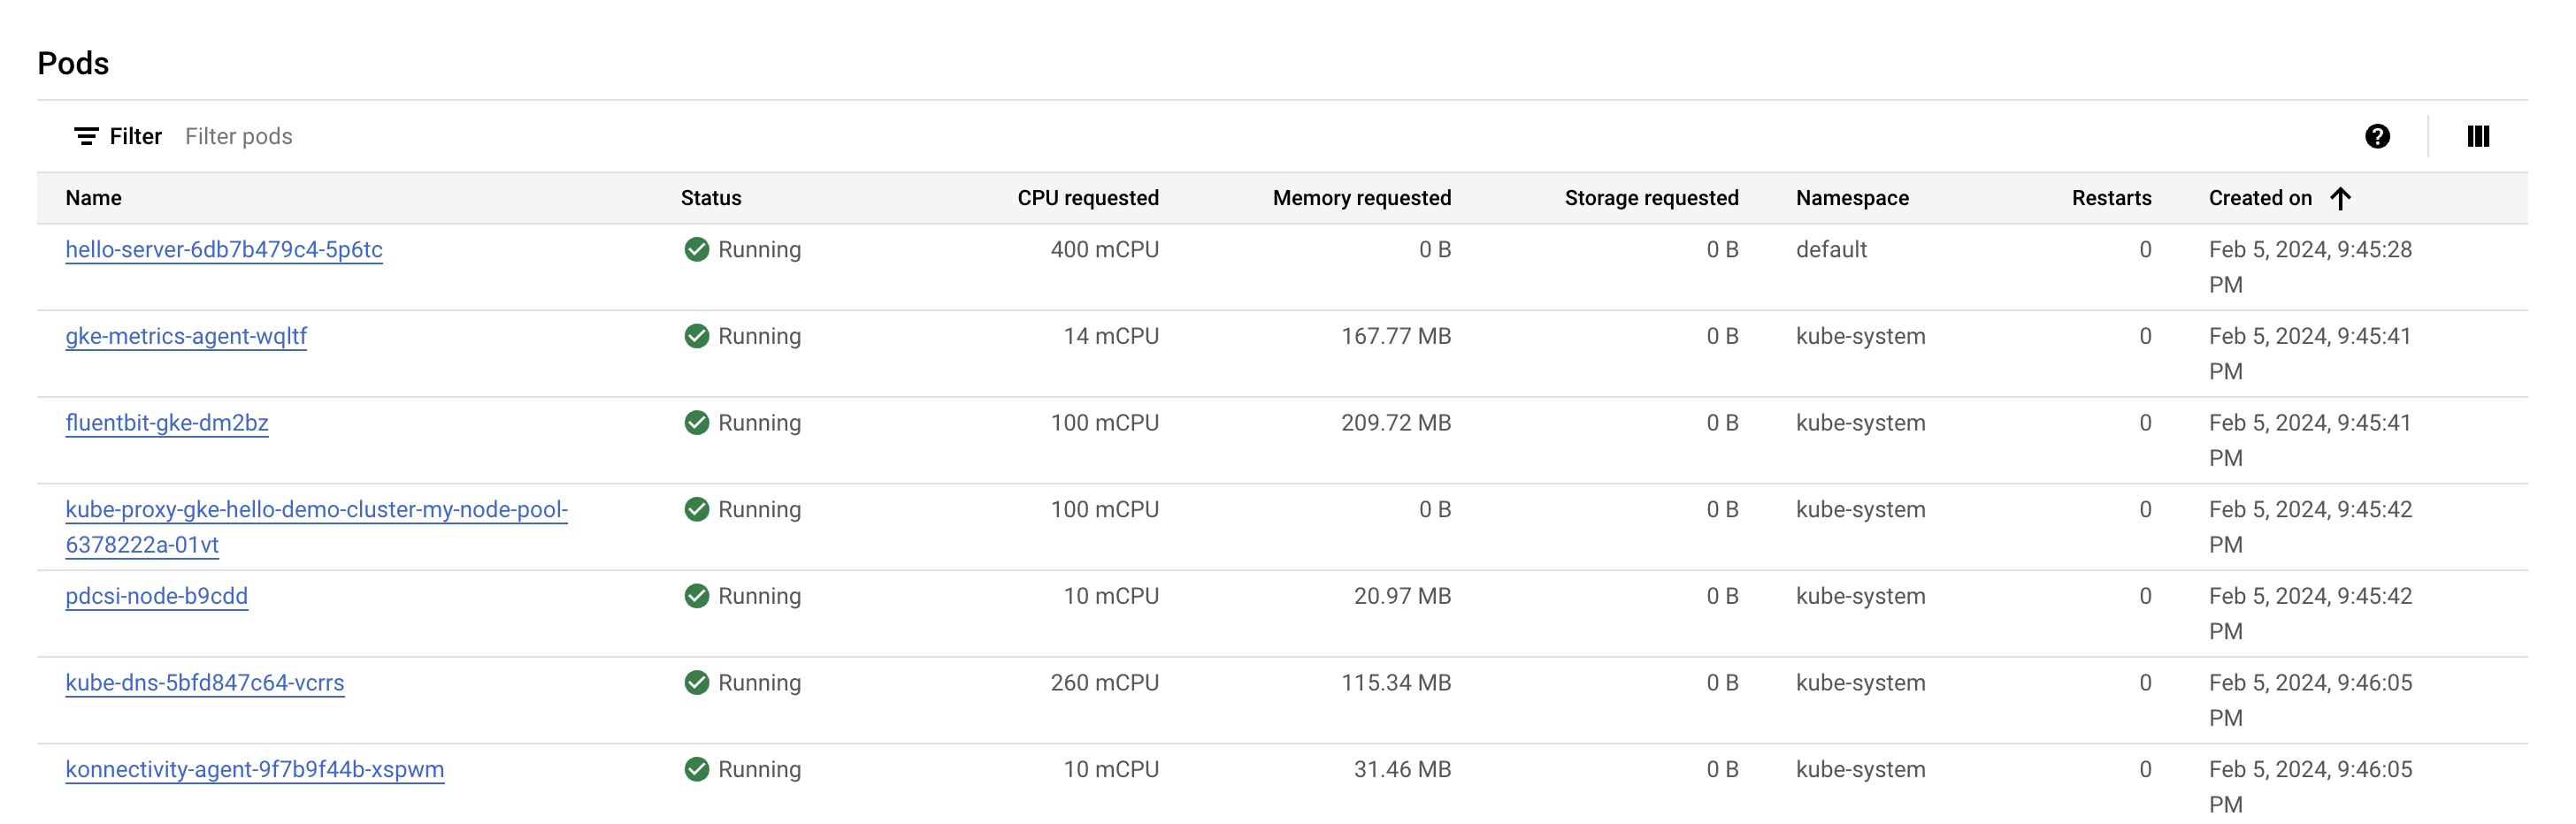
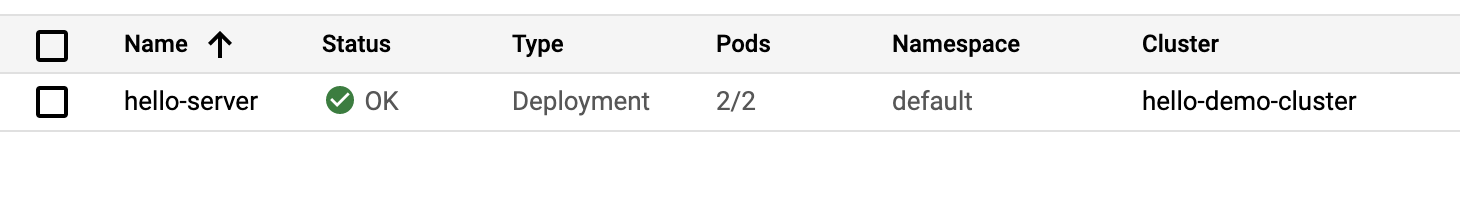
[Pod] セクションを見てください。hello-server Pod が default Namespace にあることがわかります。hello-server Pod が表示されない場合は、前に戻ってクラスタの 2 番目のノードを選択します。
hello-server Pod が 400 mCPU をリクエストしていることがわかります。他にも少数の kube-system Pod が実行中であることが確認できます。これらは GKE のクラスタ サービス(モニタリングなど)を実行するために読み込まれた Pod です。
Hello-App の 1 つのレプリカと基本的な kube-system サービスを実行するために、2 つの e2-medium ノードが必要であることがわかります。また、クラスタの CPU リソースは大部分が使用されていますが、割り当て可能なメモリは約 3 分の 1 しか使用されていません。
このアプリのワークロードがまったく変動しない場合は、必要な CPU とメモリの使用量も正確にわかるため、それに合わせてカスタマイズしたマシンタイプを作成することも可能でしょう。そのようにすると、クラスタ インフラストラクチャ全体の費用を抑えられます。
しかし実際には、GKE クラスタの実行するワークロードは複数あることが多く、ほとんどの場合スケールアップやスケールダウンが必要です。
Hello App のスケールアップが必要になった場合、何が起こるでしょうか。
Cloud Shell は、開発ツールと一緒に読み込まれる仮想マシンです。5 GB の永続ホーム ディレクトリが用意されており、Google Cloud で稼働します。Cloud Shell を使用すると、コマンドラインで Google Cloud リソースにアクセスできます。
Google Cloud コンソールの上部にある「Cloud Shell をアクティブにする」アイコン 
ウィンドウで次の操作を行います。
接続した時点で認証が完了しており、プロジェクトに各自の Project_ID、
gcloud は Google Cloud のコマンドライン ツールです。このツールは、Cloud Shell にプリインストールされており、タブ補完がサポートされています。
出力:
出力:
gcloud ドキュメントの全文については、gcloud CLI の概要ガイドをご覧ください。
Hello-Server をスケールアップします。[進行状況を確認] をクリックして、上記のタスクを実行したことを確認します。
hello-server に「Does not have minimum availability」というエラー ステータスが表示されます。
Insufficient cpu」と表示されます。これは予想どおりです。先ほど確認したとおり、クラスタには CPU リソースの余裕がほとんどない状態でしたが、hello-server の別のレプリカでさらに 400m をリクエストしました。
続行するかどうかを確認するメッセージが表示されたら、「y」と入力して Enter キーを押します。
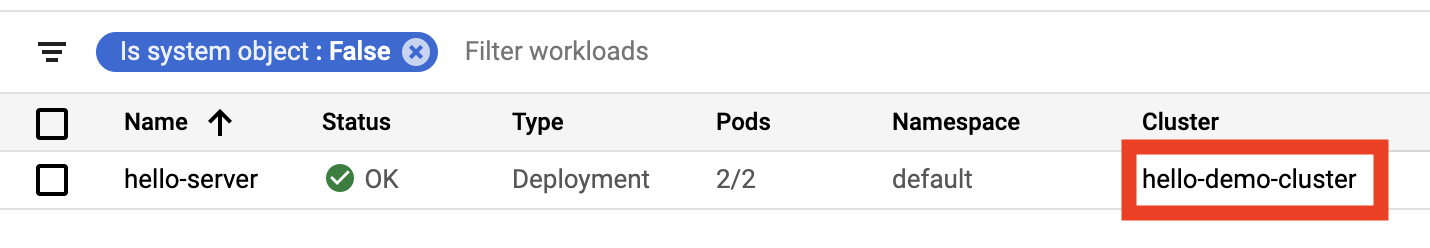
コンソールで、hello-server ワークロードのステータスが「OK」に変わるまで、[ワークロード] ページを更新します。
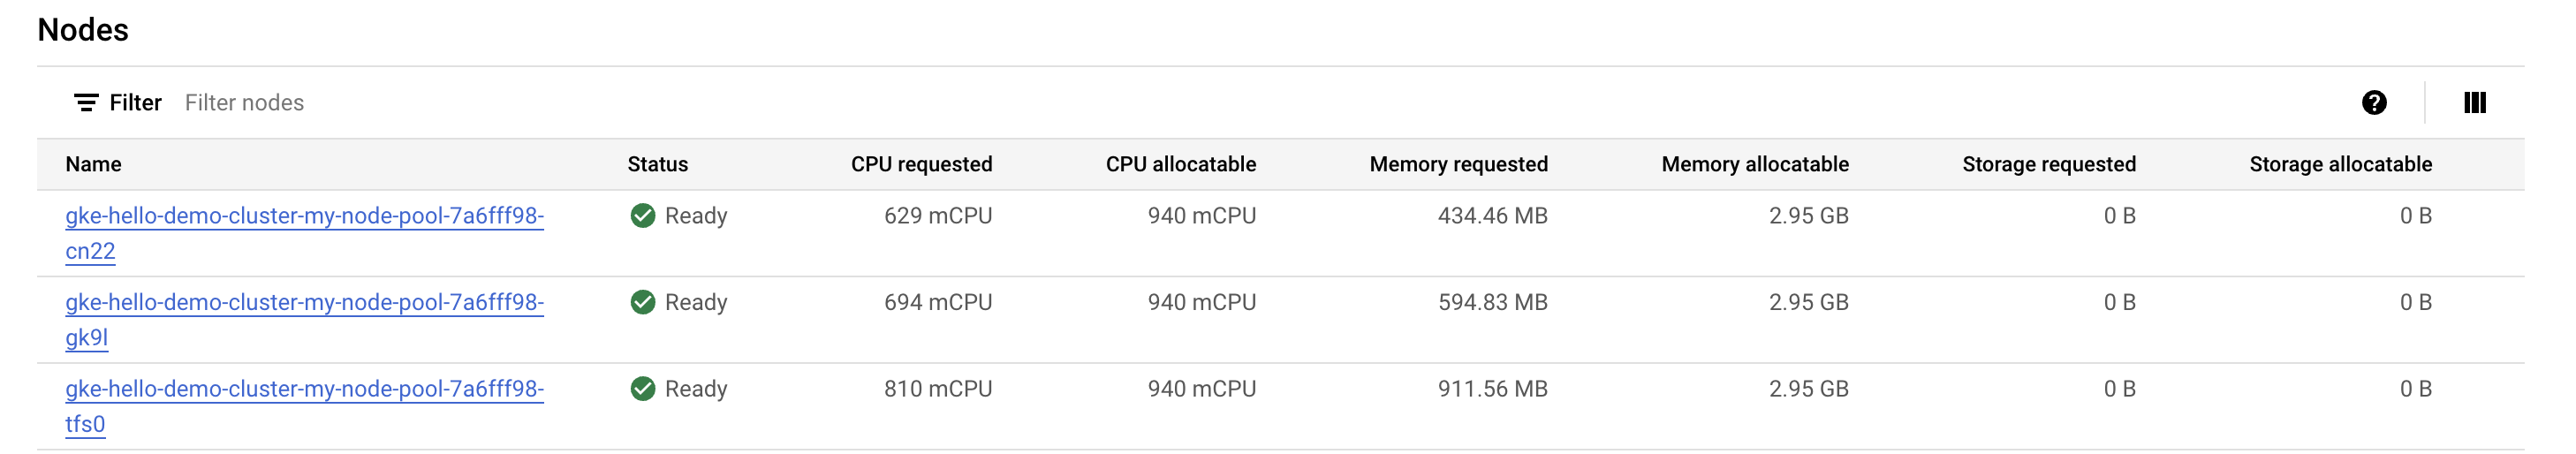
ワークロードのスケールアップが正常に行われたら、クラスタの [ノード] タブに戻ります。
大きくなったノードプールは、処理の重いワークロードに対応できますが、インフラストラクチャ リソースの使用状況に注目してください。
GKE はクラスタのリソースを最大限に利用していますが、最適化の余地はまだあります。1 つのノードはメモリの大半を使用しているものの、2 つのノードでは相当量のメモリが未使用です。
この時点でアプリのスケールアップを続けると、同じようなパターンが見え始めるでしょう。Kubernetes は、hello-server Deployment の新しいレプリカごとにノードを見つけようとし、見つけられず、CPU が約 600m の新しいノードを作成することになります。
ビンパッキング問題とは、体積や形状にばらつきがある複数の品目を、数に限りのある、形状の定まった「ビン(容器)」に収めなくてはならないという問題です。基本的には、これらの品目をできる限り少ない数のビンに効率よく「パッキング」することが課題です。
これは、実行するアプリケーションに合わせて Kubernetes クラスタを最適化するときに直面する課題と似ています。多くの場合、複数のアプリケーションがあれば、リソースの要件(メモリ、CPU など)はそれぞれ異なります。これらのアプリケーションを、Kubernetes によって管理されるインフラストラクチャ リソース(おそらくはクラスタの費用のほとんどを占める部分)に、できる限り効率的に収める必要があります。
Hello デモクラスタでは、ビンパッキングが効率よく行われていません。このワークロードにもっと適切なマシンタイプを使用するよう Kubernetes を構成すると、費用効率が向上するでしょう。
[進行状況を確認] をクリックして、上記のタスクを実行したことを確認します。
次の手順で Pod を新しいノードプールに移行できます。
node)がスケジュール不可に設定されます。Kubernetes は、スケジュール不可に設定されたノードに新しい Pod をスケジュールしなくなります。node)で実行されているワークロードが正常に強制排除されます。この時点で、Pod が新しい larger-pool ノードプールで実行されていることが確認できます。
y」と入力して Enter キーを押します。削除に 2 分ほどかかります。その間に次のセクションに目を通してください。
この時点で、3 台の e2-medium マシンを必要とした同じワークロードを 1 台の e2-standard-2 マシンで実行しています。
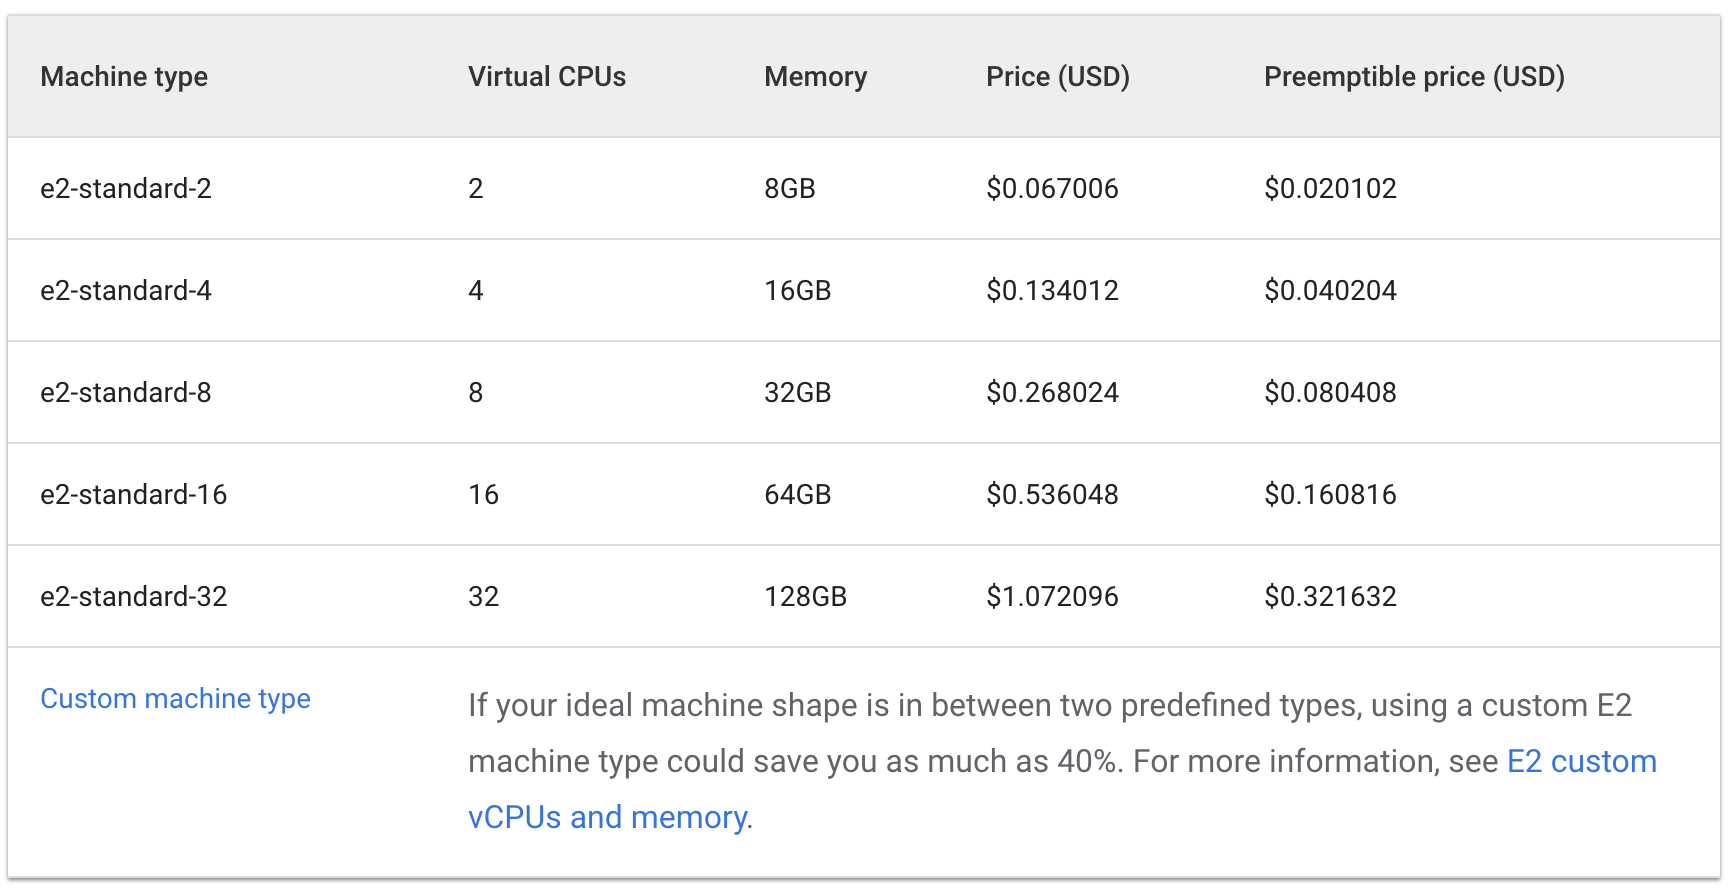
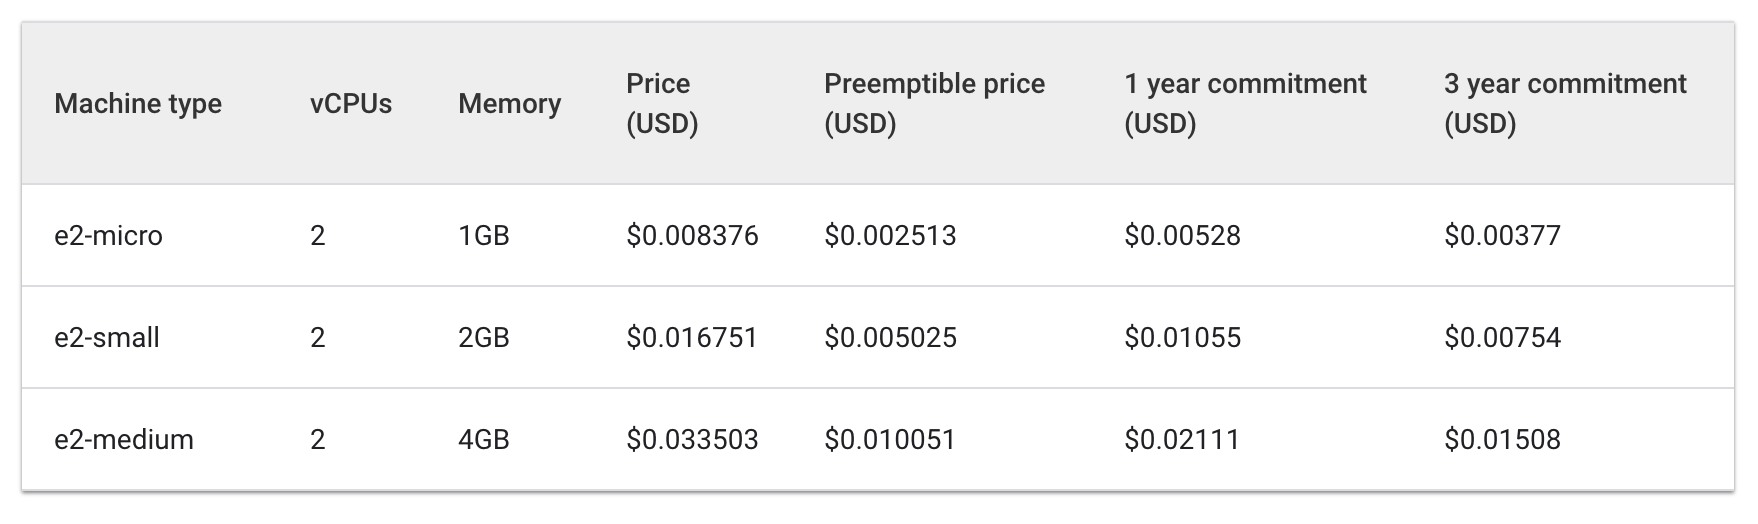
そこで、e2 標準マシンタイプと e2 共有コア マシンタイプを使用する 1 時間あたりの費用に注目してみましょう。
標準:
共有コア:
e2-medium マシン 3 台の費用は 1 時間あたり約 $0.1 ですが、e2-standard-2 1 台は 1 時間あたり約 $0.067 です。
1 時間あたり $0.04 の削減は小さいと感じるかもしれませんが、実行するアプリケーションのライフサイクルの間、これがずっと積み重なります。もっと規模が大きければ、さらに目に見える違いがあるでしょう。e2-standard-2 マシンはこのワークロードをより効率よくパッキングできるので、未使用の領域が減り、スケールアップ費用の増加のペースが下がります。
これは興味深い事実です。というのも、e2-medium は共有コア マシンタイプであり、リソースを大量に消費しない小規模なアプリケーションで費用対効果が高くなるように設計されているからです。ところが、Hello-App の現在のワークロードについては、より大きなマシンタイプのノードプールを使用することが、結果としてより費用対効果に優れた戦略となっています。
Cloud コンソールで、hello-demo クラスタの [ノード] タブがまだ表示されているはずです。このタブを更新し、larger-pool ノードの [リクエストされた CPU] と [割り当て可能な CPU] の各フィールドを確認します。
さらに最適化できる余地があることがわかります。この新しいノードには、別のノードをプロビジョニングしなくても、ワークロードの別のレプリカを収めることができます。また、アプリケーションに必要な CPU とメモリの量に適合するカスタムサイズのマシンタイプを選択すると、リソースの使用をさらに抑えられる可能性もあります。
こうした料金はクラスタのロケーションによって異なることに留意する必要があります。このラボの次のセクションでは、最適なリージョンを選択し、リージョン クラスタを管理する方法を説明します。
クラスタのノードに使用される Compute Engine リソースは、世界各地の複数のロケーションでホストされています。これらのロケーションはリージョンとゾーンからなります。リージョンとは、リソースをホストできる特定の地理的位置です。リージョンには 3 つ以上のゾーンがあります。
仮想マシン インスタンスやゾーン永続ディスクなど、ゾーンを有効範囲とするリソースはゾーンリソースと呼ばれます。静的外部 IP アドレスなど、それ以外のリソースはリージョン リソースです。リージョン リソースは、ゾーンに関係なく、そのリージョン内のどのリソースでも使用できますが、ゾーンリソースは同じゾーン内の他のリソースでのみ使用できます。
リージョンまたはゾーンを選択する際は、次のことに注意してください。
リージョンによる費用の差はさまざまな要因に左右されます。たとえば、us-west2 リージョンのリソースは、us-central1 のリソースより高価になりがちです。
クラスタで使用するリージョンまたはゾーンを選択する際は、アプリで実行する処理を確認します。レイテンシの影響を受けやすい本番環境の場合、ネットワークのレイテンシが少なく、効率が高いリージョンまたはゾーンにアプリを配置すると、パフォーマンスと費用の最適なバランスが得られるでしょう。
これに対して、レイテンシの影響を受けにくい開発環境は、廉価なリージョンに配置することで費用を抑えられます。
GKE で使用できるクラスタのタイプには、ゾーン(シングルゾーンまたはマルチゾーン)とリージョンがあります。額面の料金では、シングルゾーンのクラスタが最も廉価です。しかし、アプリケーションの高可用性を確保するには、クラスタのインフラストラクチャ リソースを複数のゾーンに分散するのが最適です。
多くのケースで、マルチゾーン クラスタまたはリージョン クラスタを使用してクラスタ内の可用性を優先させると、パフォーマンスと費用のバランスが最適なアーキテクチャになります。
複数のゾーンにまたがったクラスタのリソース管理は、やや複雑になります。注意を怠ると、Pod 間での不必要なゾーン間通信によって余計な費用が積み重なる可能性があります。
このセクションでは、クラスタのネットワーク トラフィックを観察し、大量のトラフィックを相互に送っている 2 つの Pod を同じゾーンに移動します。
Pod とノードでやり取りされるトラフィックを実際に確認するため、リージョン クラスタ内で 2 つの Pod を別々のノードに作成します。トラフィックをモニタリングするために、ping を使用して Pod 間のトラフィックを生成します。
[進行状況を確認] をクリックして、上記のタスクを実行したことを確認します。
作成した Pod は、node-hello コンテナを使用し、リクエストされたときに Hello Kubernetes メッセージを出力します。
作成した pod-2.yaml ファイルを確認すると、podAntiAffinity がルールとして定義されていることがわかります。これにより、この Pod は pod-1 と同じノードにスケジュールされないように指定されます。pod-1 の security: demo ラベルに基づいて matchExpressions のロジックが適用されるためです。podAffinity は Pod が同じノードにスケジュールされるようにし、podAntiAffinity は Pod が同じノードにスケジュールされないようにします。
このケースでは、ノード間のトラフィックについて説明するために podAntiAffinity を使用しますが、podAntiAffinity と podAffinity を賢く使用すれば、リージョン クラスタのリソースをさらに効率よく利用できます。
どちらの Pod も「Running」ステータスと内部 IP を返します。
出力例:
pod-2 の IP アドレスをメモしておきます。これは次のコマンドで使用します。
pod-1 コンテナへのシェルを取得します。pod-2 にリクエストを送信します。ここで [POD-2-IP] は、pod-2 のものとして表示された内部 IP アドレスに置き換えます。pod-1 から pod-2 への ping で発生する平均レイテンシをメモしておきます。
pod-1 から pod-2 に ping が実行されている状態で、クラスタが作成された VPC のサブネットでフローログを有効にして、トラフィックを観察できます。
[VPC Flow Logs の構成を追加] ボタンをクリックし、[サブネット] で [サブネット向けの構成を追加] をクリックします。
[現在のプロジェクトのサブネット] タブの [VPC ネットワーク] プルダウンで、[デフォルト] をオンにして、[OK] をクリックします。
次に、
[構成 - サブネット(Compute Engine API)] で [構成を追加] をクリックし、[完了] をクリックします。
次に、[保存] をクリックします。
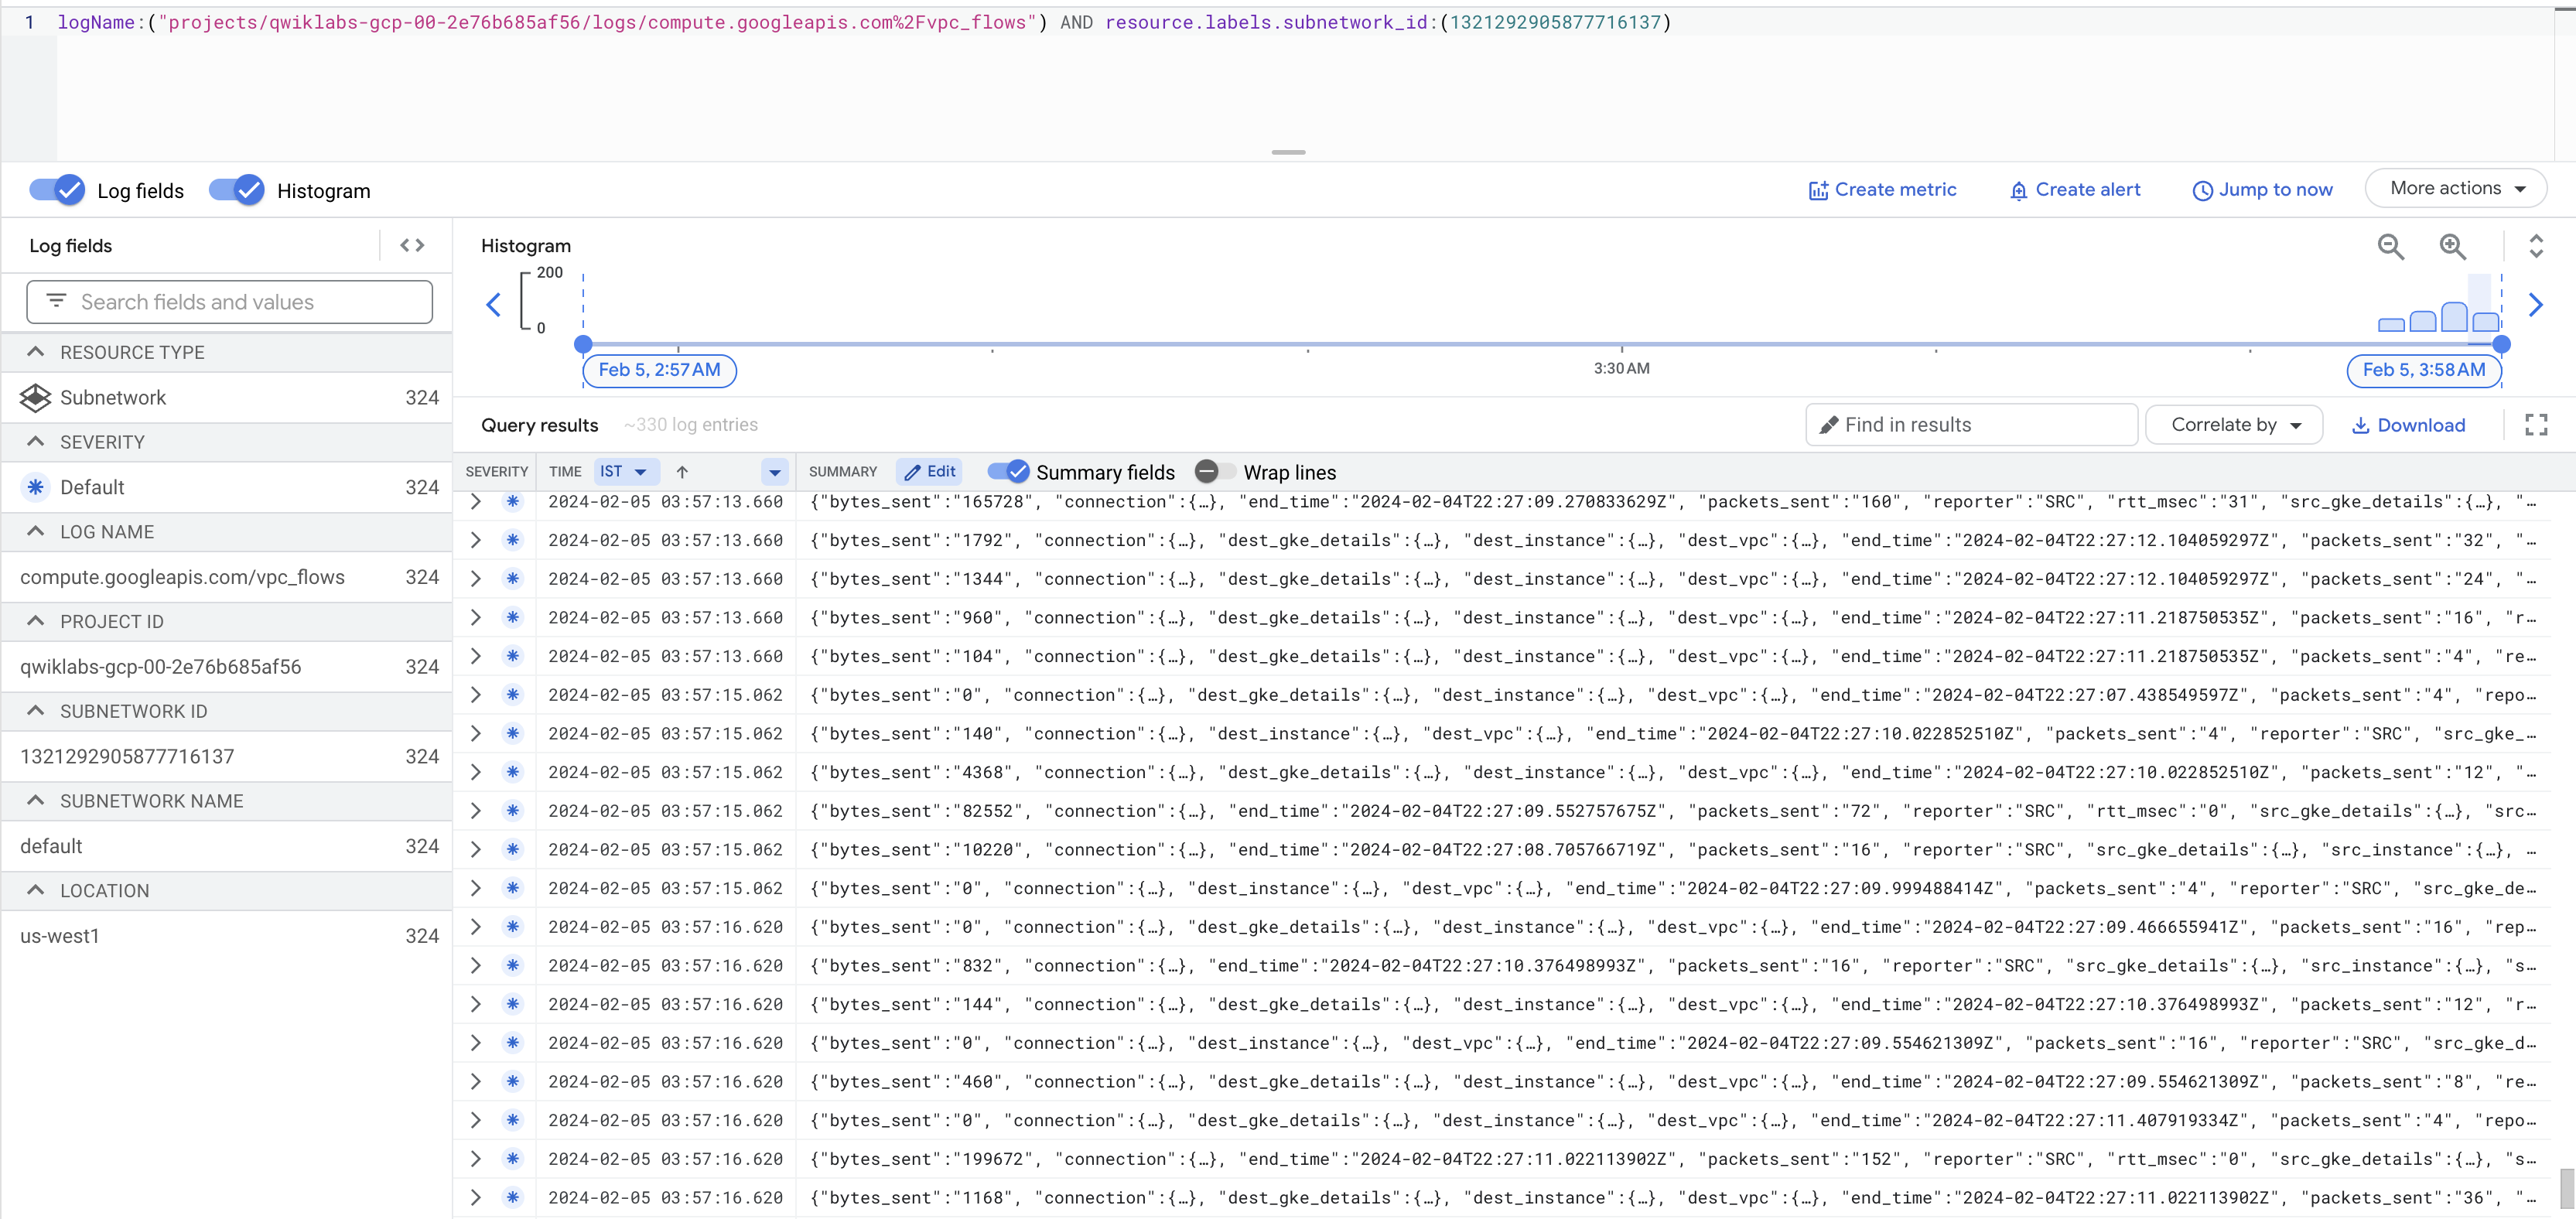
次に、Cloud コンソールのログ エクスプローラに移動します。[すべてのログ名] をクリックし、[vpc_flows] を選択します。[適用] をクリックします。
ログのリストが表示され、いずれかのインスタンスで送信または受信があるたびに大量の情報が示されます。
ログが生成されない場合は、上記のスクリーンショットを参考にして、「vpc_flows」の前にある「/」を「%2F」に置き換えます。
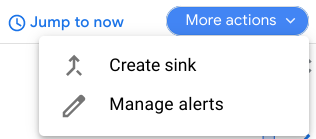
このままでは少し読みづらいかもしれません。次に、このログを BigQuery テーブルに書き出して、関連情報をクエリできるようにします。
シンクに「FlowLogsSample」という名前を付けます。
[次へ] をクリックします。
これ以外はそのままで構いません。
[シンクを作成] をクリックします。
新しく作成したデータセットを確認してみましょう。Cloud コンソールのナビゲーション メニューで、[分析] セクションの [BigQuery] をクリックします。
[完了] をクリックします。
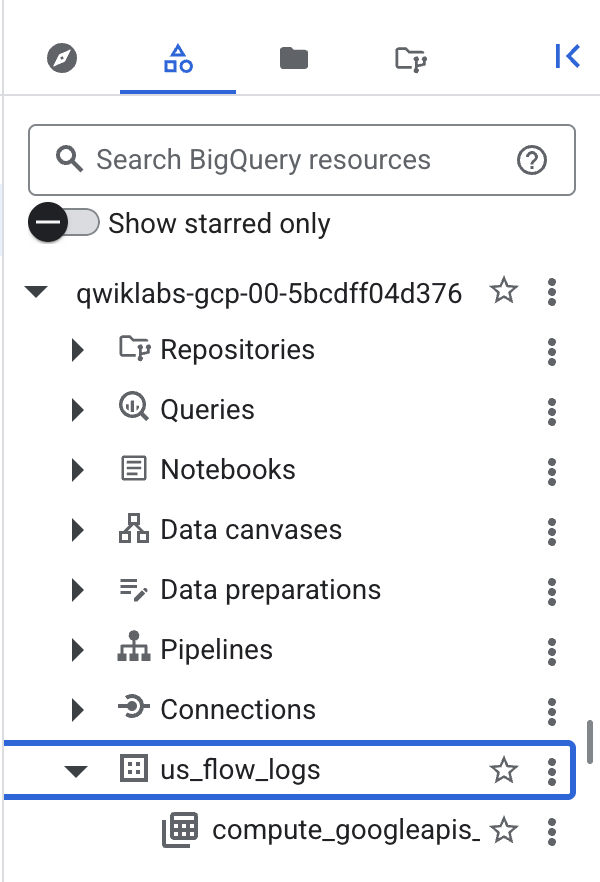
プロジェクト名のプルダウンをクリックし、us_flow_logs データセットを選択して、新しく作成されたテーブルを表示します。テーブルが表示されない場合は、作成されるまで更新してください。
us_flow_logs データセットの下で compute_googleapis_com_vpc_flows_xxx テーブルをクリックします。
[クエリ] をクリックします。
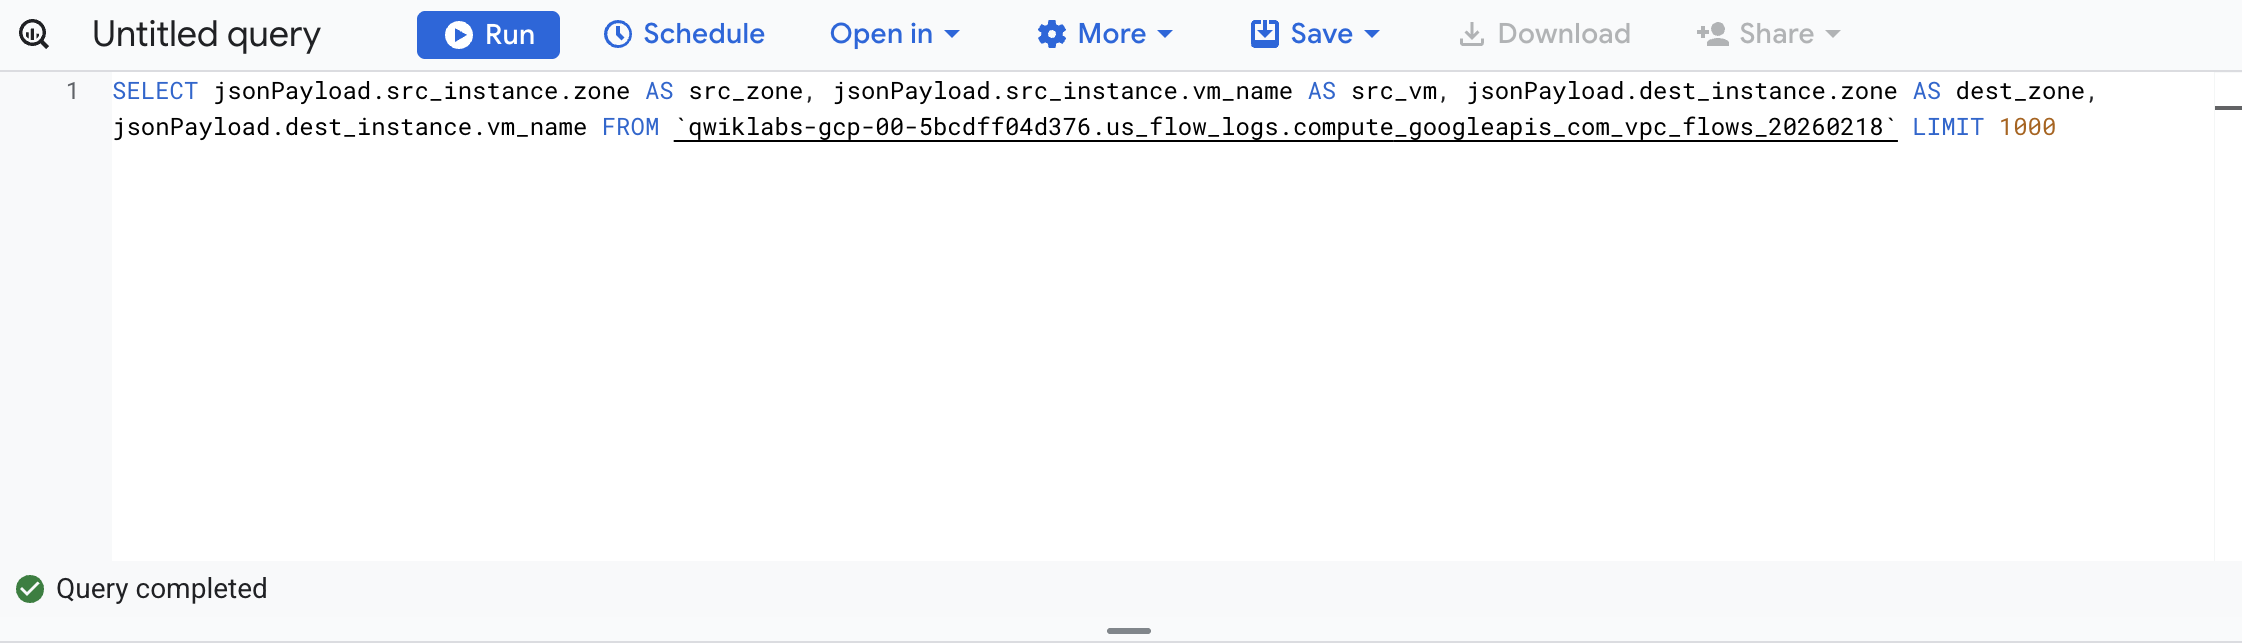
BigQuery エディタで、SELECT と FROM の間に以下のコードを貼り付けます。
先ほどのフローログが、source zone、source vm、destination zone、destination vm でフィルタされて表示されます。
regional-demo クラスタ内の 2 つのゾーン間で呼び出しが行われている行を探します。
フローログを観察すると、異なるゾーン間で頻繁にトラフィックが発生することがわかります。
次に、Pod を同じゾーンに移動し、効果を観察してみましょう。
Cloud Shell に戻り、Ctrl+C キーを押して ping コマンドをキャンセルします。
exit コマンドを入力して pod-1 のシェルを終了します。
pod-2 のマニフェストを編集します。podAntiAffinity ルールを podAffinity ルールに変更しますが、ロジックは変更しません。これで、pod-2 が pod-1 と同じノードにスケジュールされます。
pod-2 を削除します。pod-2 が削除されたら、新しく編集したマニフェストを使用して再作成します。[進行状況を確認] をクリックして、上記のタスクを実行したことを確認します。
Running」であることを確認します。出力を見ると、pod-1 と pod-2 が同じノードで実行されていることがわかります。
pod-2 の IP アドレスをメモしておきます。これは次のコマンドで使用します。
pod-1 コンテナへのシェルを取得します。pod-2 にリクエストを送信します。ここで [POD-2-IP] は、先ほどのコマンドで取得した pod-2 の内部 IP に置き換えます。2 つの Pod 間の ping にかかる平均時間が、かなり短くなったことがわかるでしょう。
この時点で、フローログの BigQuery データセットに戻り、最新のログをチェックして、望ましくないゾーン間通信がなくなったことを確認できます。
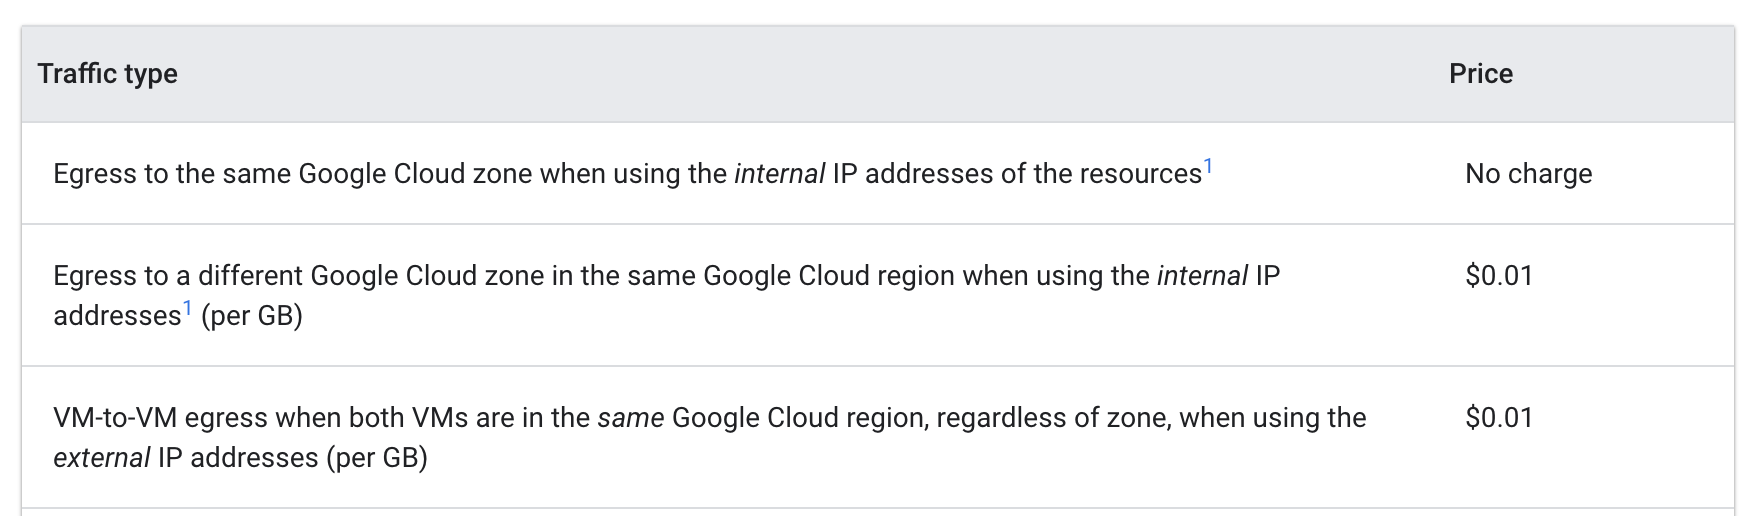
Google Cloud 内の VM 間外向きトラフィックの料金に注目します。
Pod が別々のゾーンから互いに ping を実行していたときは、1 GB あたり $0.01 の料金が発生していました。少額だと思うかもしれませんが、複数のサービスがゾーン間で頻繁に呼び出しを行う大規模なクラスタであれば、たちまち費用がかさみます。
その後、Pod を同じゾーンに移動したので、ping の実行に料金が発生しなくなりました。
ここでは、GKE クラスタの一部である仮想マシンの費用を最適化する方法について学習しました。まず、より適切なマシンタイプのノードプールにワークロードを移行し、次に、異なるリージョンの長所と短所について理解したうえで、最後に、リージョン クラスタ内にある通信量の多い Pod を通信先の Pod と同じゾーンに配置しました。
このラボでは、GKE VM の費用対効果を高めるためのツールと戦略を紹介しましたが、仮想マシンを最適化するには、まずアプリケーションとそのニーズを理解する必要があります。実行するワークロードの種類を知り、アプリケーションのニーズを見積もると、GKE クラスタの基盤となる仮想マシンに最適なロケーションとマシンタイプの判断が変わってきます。
クラスタのインフラストラクチャを効率的に利用することは、費用の最適化に大いに役立ちます。
Google Cloud トレーニングと認定資格を通して、Google Cloud 技術を最大限に活用できるようになります。必要な技術スキルとベスト プラクティスについて取り扱うクラスでは、学習を継続的に進めることができます。トレーニングは基礎レベルから上級レベルまであり、オンデマンド、ライブ、バーチャル参加など、多忙なスケジュールにも対応できるオプションが用意されています。認定資格を取得することで、Google Cloud テクノロジーに関するスキルと知識を証明できます。
マニュアルの最終更新日: 2026 年 2 月 18 日
ラボの最終テスト日: 2026 年 2 月 18 日
Copyright 2026 Google LLC. All rights reserved. Google および Google のロゴは Google LLC の商標です。その他すべての企業名および商品名はそれぞれ各社の商標または登録商標です。



このコンテンツは現在ご利用いただけません
We can notify you via email when it becomes available

ありがとうございます。
We can contact you via email if it becomes available


1 回に 1 つのラボ
既存のラボをすべて終了して、このラボを開始することを確認してください